


Python只删除字符串首尾换行符:strip与rstrip用法
在Python中如果只想删除字符串首尾的换行符而不破坏空格和缩进,不能直接使用无参strip(),而应使用strip('\r\n')或rstrip('\r\n')。本文详解其核心原理、字符集匹配机制及实际场景应用。
strip()。正确的做法是给方法显式传入换行字符集:两端只去换行使用 s.strip('\r\n');若在读取文件或代码时只去除行尾换行符并完整保留缩进,应使用 s.rstrip('\r\n')。
一、为什么默认的 strip() 无法满足“只删换行符”?
初学者在需要去掉字符串末尾或两端的换行符时,往往第一反应是调用 s.strip()。然而在 Python 中,当 strip()、lstrip() 或 rstrip() 不传入参数时,它们默认剔除的是所有的空白字符(Whitespace)。
这些空白字符包括空格(ASCII 32)、制表符(\t)、换行符(\n)、回车符(\r)以及垂直制表符等。如果在处理代码行、文本配置文件或 Markdown 列表等具有缩进格式的数据时使用无参 strip(),字符串头部的所有缩进空格都会被连带移除,导致文本结构被破坏。
# 示例:一段带有4个空格缩进并以换行符结尾的代码字符串
line = "    total = sum(items)\n"

# 错误用法:无参 strip() 会将开头的空格缩进一并删光
result_wrong = line.strip()
print(repr(result_wrong))
# 示例输出: 'total = sum(items)' (缩进完全丢失!)

# 正确用法:只剔除尾部换行符,完整保留开头的4个空格
result_correct = line.rstrip('\r\n')
print(repr(result_correct))
# 示例输出: '    total = sum(items)' (格式完整保留)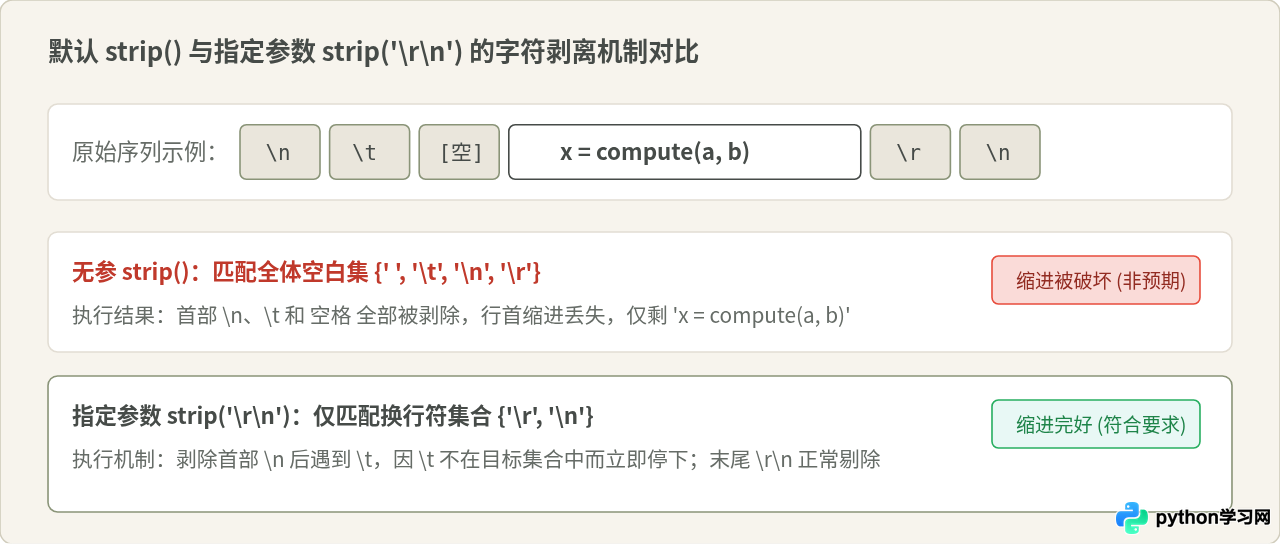
二、精准删除换行符的标准语法与用法
Python 字符串的 strip([chars])、lstrip([chars]) 和 rstrip([chars]) 允许传入一个可选字符串参数 chars。当指定该参数后,方法不再剔除默认的空格与制表符,而是严格只剥除落在 chars 中的字符。
1. 为什么推荐传入 '\r\n' 而不是单纯的 '\n'?
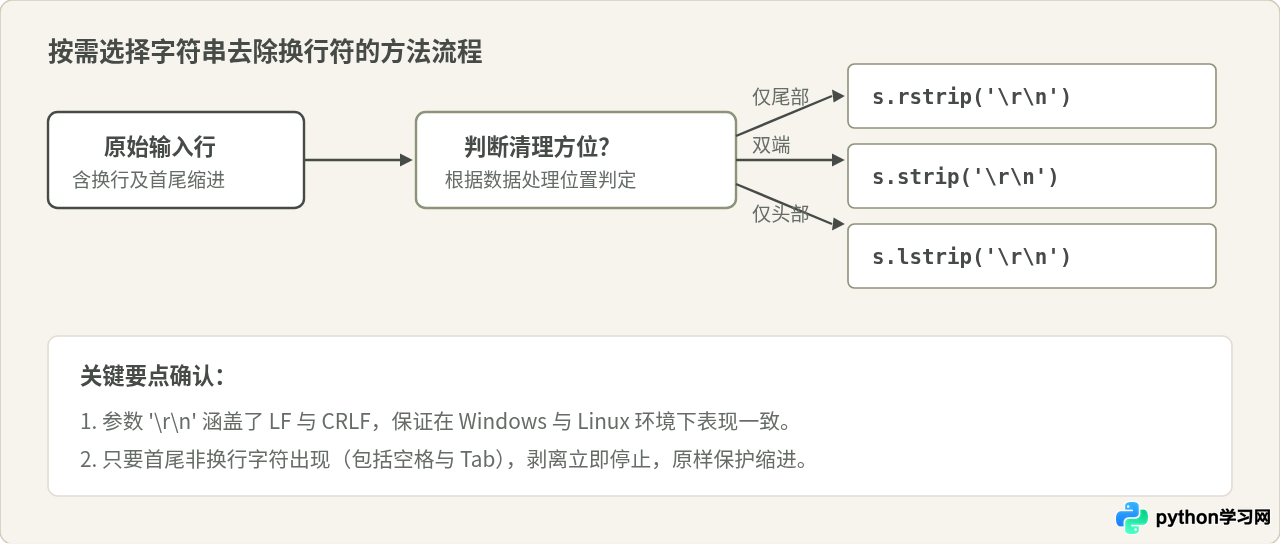
在 Unix/Linux 与现代 macOS 系统中,换行符以单字符 \n(LF)表示;而在 Windows 系统及许多网络协议(如 HTTP 报文、SMTP 等)中,换行是以回车加换行双字符 \r\n(CRLF)存在的。
若只写 s.rstrip('\n'),在遇到来自 Windows 文件或 Windows 客户端传输的数据时,结尾的 \r(回车符)就会残留在字符串末尾,导致显示混乱或在类型转换(如 int())时产生潜在隐患。因此,跨平台通用的最佳实践始终是将两类换行符一并写入集合:'\r\n'。
2. 三个核心方法的职责区分
s.rstrip('\r\n'):只从字符串右侧(尾部)剥除换行符。文件读取场景 95% 以上使用该方法。s.lstrip('\r\n'):只从字符串左侧(开头)剥除换行符,保留所有尾部内容及头部空格。s.strip('\r\n'):同时从开头和末尾剥除换行符,中间若有换行或首尾有空格制表符均不受影响。
三、文件逐行读取时的经典实战
在 Python 中使用 for line in file_obj: 或 readline() 逐行迭代文本时,Python 返回的每一行末尾都包含原生的行终止符。
如果直接打印或分析这些行,末尾的换行会带来额外空行,或干扰以 endswith() 进行的后缀匹配。此时,rstrip('\r\n') 是最为标准优雅的解决方案。
# 示例:解析带缩进的结构化配置文件或代码
with open('config.yaml', 'r', encoding='utf-8') as f:
    for line in f:
        # 仅剔除行末的换行符,行首的空格缩进将被原样保留
        clean_line = line.rstrip('\r\n')

        # 此时仍可精确判断缩进深度
        indent_level = len(clean_line) - len(clean_line.lstrip(' '))
        print(f"缩进空格数: {indent_level}, 内容: {clean_line}")
四、进阶辨析:字符集剥离与精准单次删除
很多开发者容易对 strip([chars]) 的工作机制产生一个常见误解:认为传入 '\r\n' 是将 '\r\n' 视为一个固定顺序的子字符串进行剥除。
实际上,strip 的参数是一个“字符集合(Set of characters)”,而非子字符串。Python 解释器会从边缘向内逐个扫描字符,只要当前字符存在于 chars 集合中,就会将其剥除,直到遇到第一个不在该集合中的字符为止。
连续换行符被一网打尽的特性
由于是集合匹配,如果文本末尾存在连续两个或多个空行(例如 "data\n\n\n"),调用 rstrip('\r\n') 会把末尾所有换行符全部移除,最终输出 "data"。
在绝大多数常规文件清洗场景下,这种行为正是我们所期望的。但如果你处理的是固定格式数据(例如需要严格保留结尾的空行数量),或者只想精准剥离单个结尾换行符,则应当使用 Python 3.9+ 引入的专门方法:removesuffix()。
text_multi = "paragraph\n\n\n"

# rstrip 会清除所有尾部换行
print(repr(text_multi.rstrip('\r\n')))
# 示例输出: 'paragraph'

# removesuffix 仅移除单个匹配的后缀(Python 3.9+)
print(repr(text_multi.removesuffix('\n')))
# 示例输出: 'paragraph\n\n' (保留了前两个换行)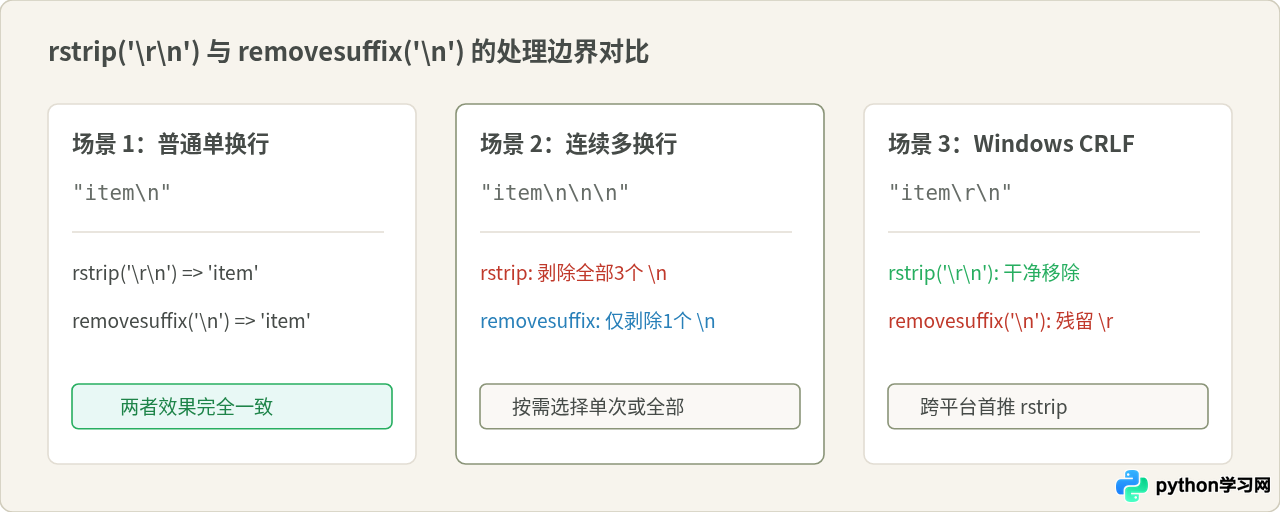
五、常用方法速查与总结建议
为了在实际编写与维护代码时快速选用正确的方法,下表汇总了 Python 中处理换行及空白字符的主要函数与适用特征:
| 方法调用 | 匹配目标 | 首尾空格与制表符 | 典型适用场景 |
|---|---|---|---|
s.strip() |
全部空白符(空格, \t, \n, \r 等) | 会被全部删除 | 用户纯输入文本、两端格式无要求的脏数据清洗 |
s.rstrip('\r\n') |
仅尾部 \r 与 \n |
完整保留 | 逐行读取文件、代码/Markdown行清洗(最常用) |
s.strip('\r\n') |
首尾 \r 与 \n |
完整保留 | 包含多余空行的文本块、段落两端多余空行修剪 |
s.removesuffix('\n') |
末尾精准匹配的单个 \n |
完整保留 | 严格保留连续空行数量、精准剔除单次换行符(Python 3.9+) |
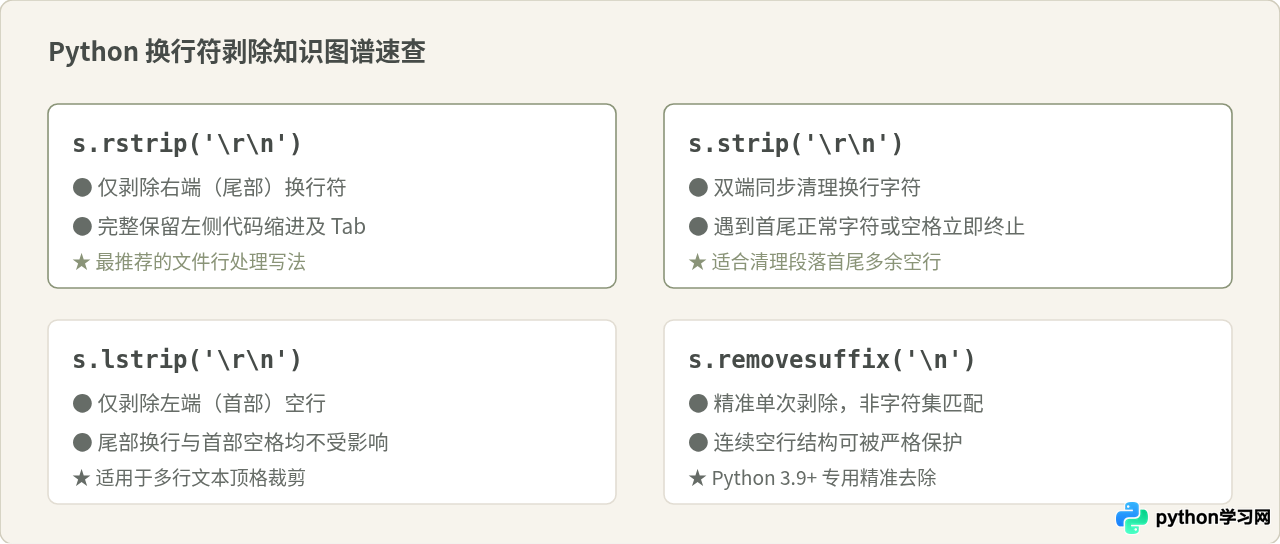
总结而言:当你的需求是“只删除换行符”时,牢记将目标换行符显式写在参数中。在绝大多数文本遍历与文件读取循环中,写成 line.rstrip('\r\n') 既能规避跨平台换行差异,又能避免误伤行首缩进,是稳健且规范的 Pythonic 实践。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















