


Python多线程并发编程简单示例:threading与concurrent.futures用法
本文详细介绍Python多线程并发编程的核心概念与基础用法,通过清晰的代码示例分别演示threading模块与concurrent.futures线程池的实现方式,并提供两者的对比与选型建议。
在编写 Python 程序时,如果遇到大量网络请求、文件读写或接口轮询等耗时操作,单线程顺序执行会导致程序长时间处于等待状态。使用多线程并发可以在一个线程等待 I/O 响应时,切换执行其他线程的任务,从而显著缩短整体运行时间。在 Python 标准库中,实现多线程主要有两种方式:一是底层的 threading 模块,适合对单个线程进行精细控制;二是现代高阶的 concurrent.futures 模块(通过 ThreadPoolExecutor),更适合管理批量任务并发与结果收集。本文通过具体且可直接运行的示例,带你掌握这两种方式的用法与适用场景。
一、Python多线程工作原理与适用场景
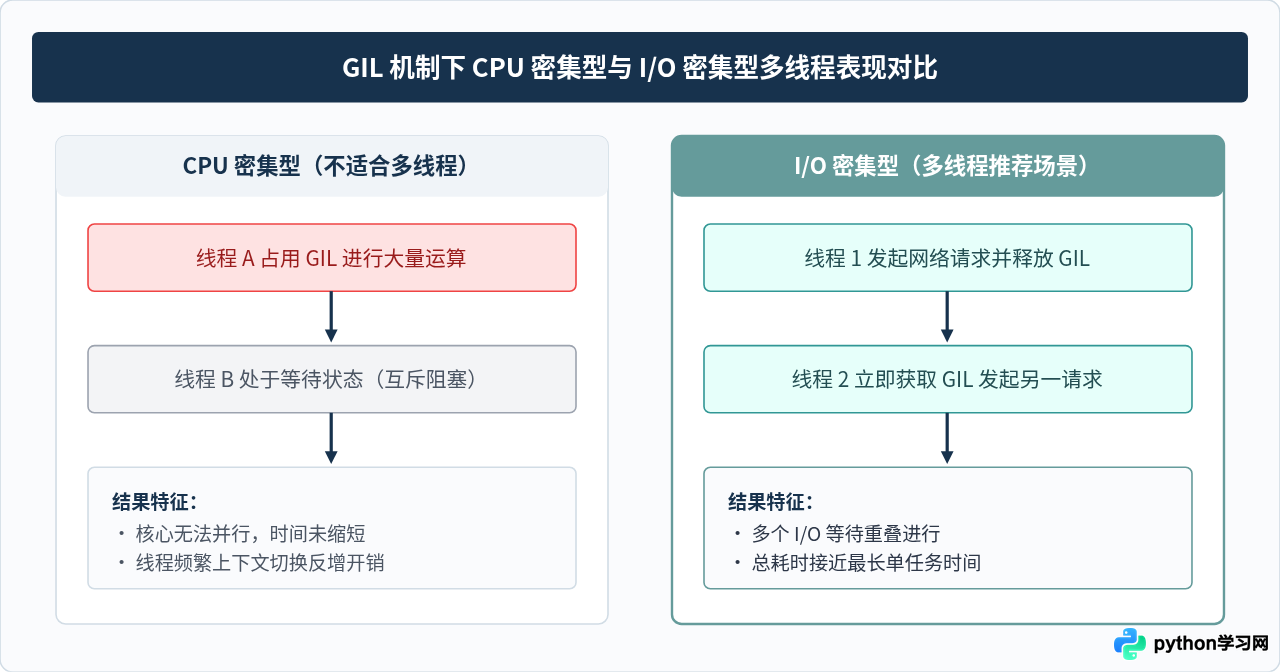
在开始写代码前,需要明确 Python 多线程的适用边界。受限于标准 CPython 解释器的全局解释器锁(Global Interpreter Lock,简称 GIL),同一时刻只有一个线程能够在 CPU 核心上执行 Python 字节码。因此,多线程并不能让纯计算密集的任务(如大型矩阵运算、复杂加密解密)利用多核并行提速。
但在 I/O 密集型任务中,当某个线程发起网络请求或磁盘读写时,会进入等待状态并主动释放 GIL。此时其他就绪状态的线程就可以获取 GIL 继续执行。这样各任务的“网络等待时间”重叠在了一起,整体执行效率就会得到大幅提升。
二、使用 threading 模块编写多线程程序
threading 是 Python 提供的基础线程模块。它的基本操作方式非常直观:定义一个工作函数,把该函数传递给 threading.Thread 构造器,然后调用 start() 启动线程,最后在主线程中调用 join() 等待子线程执行完毕。
1. 基本步骤与代码示例
以下示例模拟同时下载 3 个文件的场景,使用 time.sleep() 模拟网络传输的延迟:
import threading
import time

def download_file(filename, duration):
    print(f"[{time.strftime('%H:%M:%S')}] 开始下载: {filename}")
    time.sleep(duration)  # 模拟网络耗时
    print(f"[{time.strftime('%H:%M:%S')}] 完成下载: {filename} (耗时 {duration}s)")

def main():
    start_time = time.time()
    tasks = [("file1.zip", 2), ("file2.zip", 3), ("file3.zip", 1)]
    threads = []

    # 1. 创建并启动线程
    for name, dur in tasks:
        t = threading.Thread(target=download_file, args=(name, dur))
        threads.append(t)
        t.start()

    # 2. 等待所有线程执行结束
    for t in threads:
        t.join()

    total_time = time.time() - start_time
    print(f"所有任务完成,总耗时: {total_time:.2f} 秒")

if __name__ == "__main__":
    main()
运行上述代码后,终端的示例输出如下:
[10:00:00] 开始下载: file1.zip
[10:00:00] 开始下载: file2.zip
[10:00:00] 开始下载: file3.zip
[10:00:01] 完成下载: file3.zip (耗时 1s)
[10:00:02] 完成下载: file1.zip (耗时 2s)
[10:00:03] 完成下载: file2.zip (耗时 3s)
所有任务完成,总耗时: 3.01 秒
如果使用单线程顺序执行,这三个任务的总耗时为 2 + 3 + 1 = 6 秒;而在多线程并发下,三个任务同时开始等待网络,总耗时仅取决于耗时最长的任务(约 3 秒)。
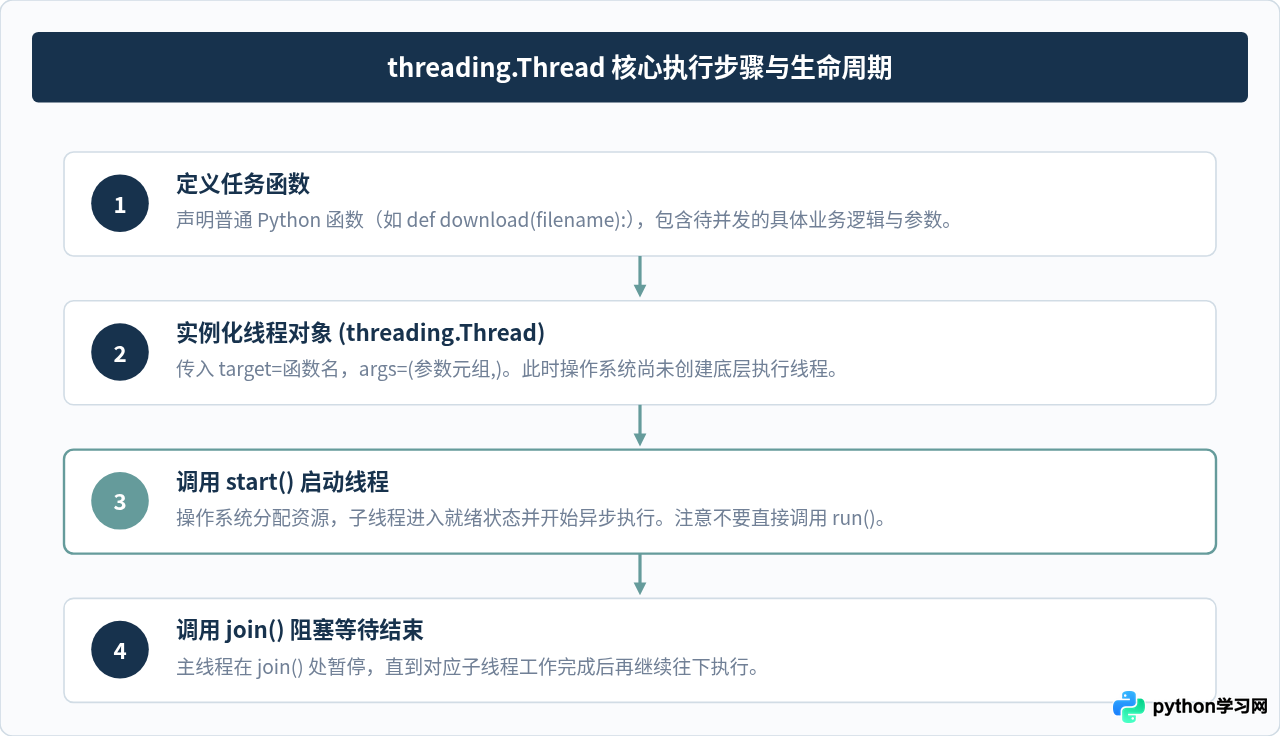
args必须是元组。如果只有一个参数,写成args=("item1",),切勿漏掉末尾逗号。- 启动线程必须调用
t.start()。如果误写成t.run(),只会在当前主线程中同步执行函数,失去并发效果。 threading.Thread无法直接拿到函数返回值。如果需要获取子线程产生的数据,需要借助queue.Queue或列表等外部容器。
三、使用 concurrent.futures 模块高效管理线程池
在实际工程场景中,直接使用 threading.Thread 往往存在一些局限:如果需要并发处理 500 个文件,一次性创建 500 个线程会造成巨大的内存开销和操作系统调度负担;此外,获取返回值和捕获异常都很繁琐。
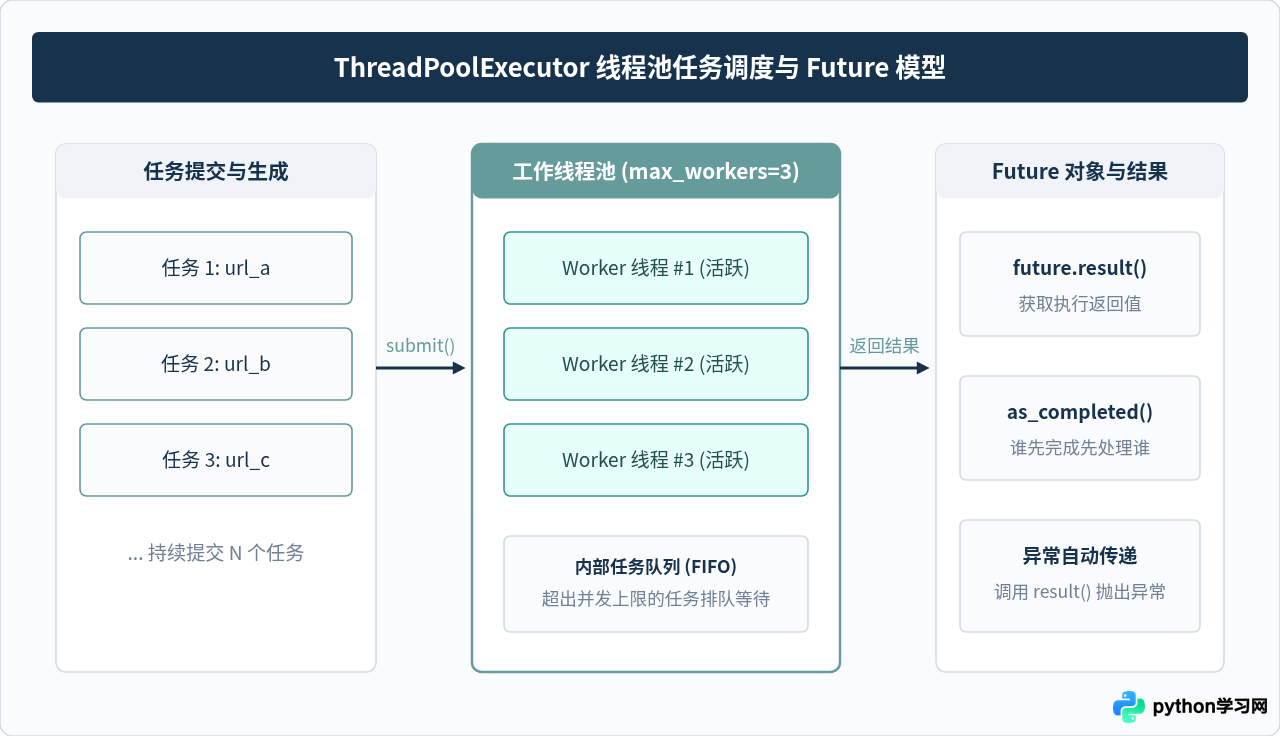
Python 3.2 引入的 concurrent.futures.ThreadPoolExecutor 完美解决了这些痛点。它维护了一个可控容量的线程池(Worker Pool),复用固定数量的线程去消化任务队列,并通过 Future 对象优雅地返回执行结果和异常。
1. 方式一:使用 map() 批量执行并按序获取结果
如果你有一批参数相同的任务列表,并且希望按照输入顺序依次获取计算结果,executor.map() 是最简洁的方法:
import time
from concurrent.futures import ThreadPoolExecutor

def fetch_data(item_id):
    time.sleep(1)  # 模拟网络耗时
    return f"数据项 #{item_id} 内容"

def main():
    items = [101, 102, 103, 104, 105]
    start = time.time()

    # 创建容量为 3 的线程池
    with ThreadPoolExecutor(max_workers=3) as executor:
        # map 会将 items 中的每个元素分别传给 fetch_data 并并发执行
        results = executor.map(fetch_data, items)

        for res in results:
            print(f"[{time.strftime('%H:%M:%S')}] 获得结果: {res}")

    print(f"全部读取完成,总耗时: {time.time() - start:.2f} 秒")

if __name__ == "__main__":
    main()
通过上下文管理器 with ThreadPoolExecutor(),当代码块执行退出时,会自动调用 shutdown(wait=True),确保所有在执行中的线程安全退出。
2. 方式二:使用 submit() 与 as_completed() 实现“先完成先处理”
在更多实际应用中,任务的耗时可能长短不一。如果希望哪个任务先下载完就立即处理哪个,可以使用 executor.submit() 单独提交任务,并配合 as_completed() 进行迭代:
import time
from concurrent.futures import ThreadPoolExecutor, as_completed

def request_api(url, delay):
    time.sleep(delay)
    if "bad" in url:
        raise ValueError(f"请求失败: {url}")
    return f"响应数据来自 {url}"

def main():
    tasks = {
        "https://api.example.com/fast": 1,
        "https://api.example.com/slow": 3,
        "https://api.example.com/medium": 2,
    }

    with ThreadPoolExecutor(max_workers=3) as executor:
        # 将 Future 对象与对应的 url 做字典映射,便于后续识别
        future_to_url = {
            executor.submit(request_api, url, delay): url
            for url, delay in tasks.items()
        }

        # as_completed 谁先完成就先产出谁的 Future 对象
        for future in as_completed(future_to_url):
            url = future_to_url[future]
            try:
                data = future.result()
                print(f"[{time.strftime('%H:%M:%S')}] 成功: {data}")
            except Exception as exc:
                print(f"[{time.strftime('%H:%M:%S')}] 异常: {url} 生成了错误: {exc}")

if __name__ == "__main__":
    main()
示例输出清晰展示了“先完成先响应”的机制:
[10:00:01] 成功: 响应数据来自 https://api.example.com/fast
[10:00:02] 成功: 响应数据来自 https://api.example.com/medium
[10:00:03] 成功: 响应数据来自 https://api.example.com/slow
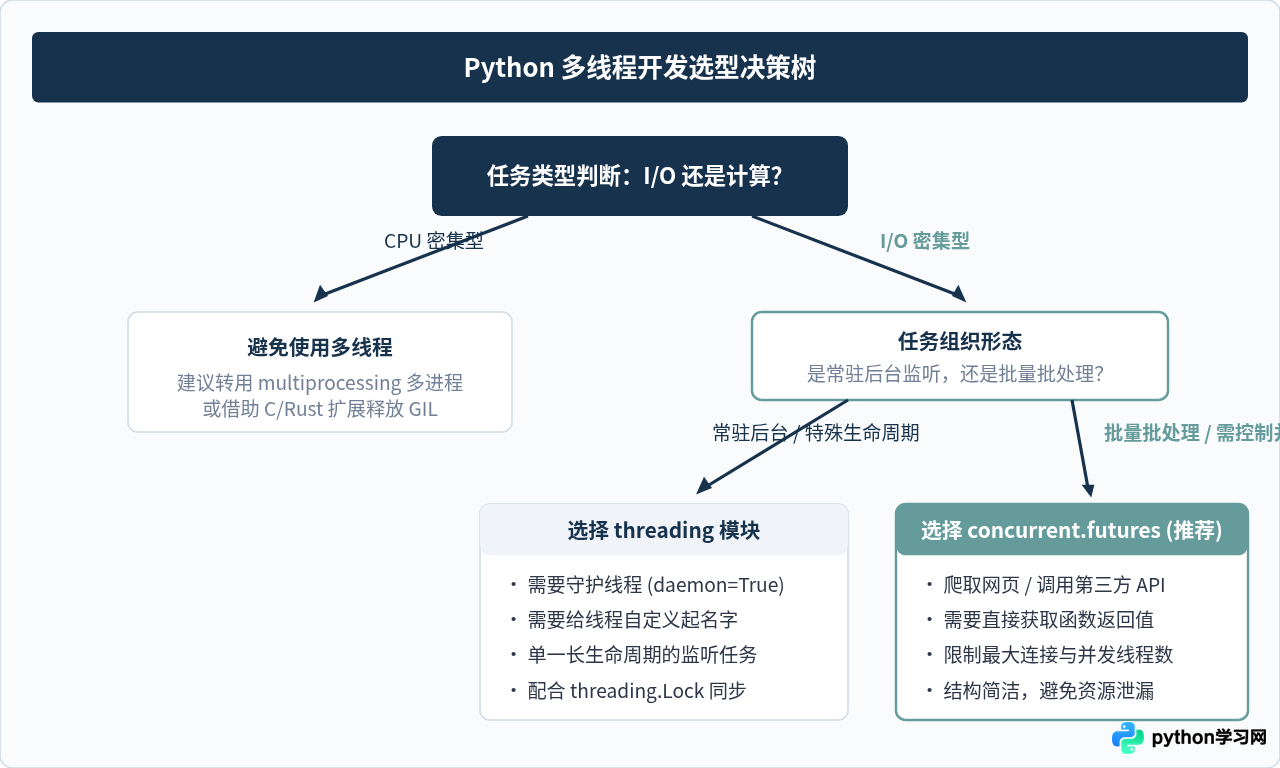
四、threading 与 concurrent.futures 对比与选型
两者在 Python 标准库中各司其职,在不同场景下各有优劣。以下是两者核心维度的对比矩阵:
| 对比维度 | threading 模块 | concurrent.futures 线程池 |
|---|---|---|
| 抽象级别 | 较低层级,细粒度管理单个线程 | 较高层级,统一调度与生命周期托管 |
| 并发量控制 | 需要手动维护线程列表或结合信号量 (Semaphore) | 直接设定 max_workers,超出任务自动排队 |
| 返回值与异常 | 无法直接通过函数返回,需借助队列 (Queue) 传递 | 通过 future.result() 直接取回结果,异常会自动在主线程抛出 |
| 资源开销 | 频繁创建与销毁线程会带来额外系统开销 | 线程常驻并循环复用,节约系统分配与销毁开销 |
| 典型适用场景 | 常驻后台监控线程、自定义 Socket 监听、特殊守护任务 | 批量网络爬虫、文件并发下载、并行 API 调用、批处理 I/O |
五、常见问题与实用排查建议
1. 为什么增加了多线程,速度反而变慢了?
遇到这种情况,首先排查任务是否属于计算密集型。如果是纯 CPU 计算(如数值计算、正则表达式大量匹配、图片处理),由于 GIL 锁的存在,多个线程会在单核上反复竞争锁和切换上下文,这不仅不能提升速度,反而会因额外的调度开销导致整体变慢。对于 CPU 密集型任务,应使用 multiprocessing.Pool 或 ProcessPoolExecutor。
2. 线程池的 max_workers 设置为多少合适?
线程数并非越多越好。过多的线程会消耗大量内存堆栈(每个线程默认占用数兆字节),并增加操作系统上下文切换的负担。通常的建议是:
- 对于绝大多数 I/O 密集型任务,
max_workers建议设置在min(32, (os.cpu_count() or 1) + 4)之间(Python 3.8+ 默认采用此策略)。 - 如果是高延迟的外部接口调用(如单个接口耗时数十秒),可以适当提高至 50 到 100,但需注意目标服务器的速率限制(Rate Limit)与本地操作系统的最大文件描述符限制。
3. 线程安全问题与共享数据
多个线程如果同时修改同一个非线程安全的全局变量(如对全局计数器执行 counter += 1),由于该操作在字节码层面并非原子操作,会导致数据不一致。此时必须使用 threading.Lock 进行加锁保护,或者优先采用“数据不共享、只通过返回值交付”的函数式设计风格,这也是优先推荐 ThreadPoolExecutor 的重要原因之一。
六、总结
掌握 Python 多线程编程的关键在于认清并发场景与选对工具:
- 适用前提:多线程专注解决 I/O 密集型等待问题,无法规避 CPU 密集型场景下的 GIL 限制。
- 轻量单一任务:使用
threading.Thread明确掌控单个线程的生命周期,配合start()与join()执行。 - 批量并发处理:优先使用
concurrent.futures.ThreadPoolExecutor,通过上下文管理器自动回收资源,利用map()进行有序处理,或借助submit()与as_completed()实现高效的先到先得调度。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















