


python函数文档docstring怎么写规范
详细讲解Python函数文档字符串(Docstring)的规范编写方法,从PEP 257官方约定、主流风格选择(Google/NumPy/Sphinx)、核心段落拆解,到常见认知误区辨析与自动化校验工具。
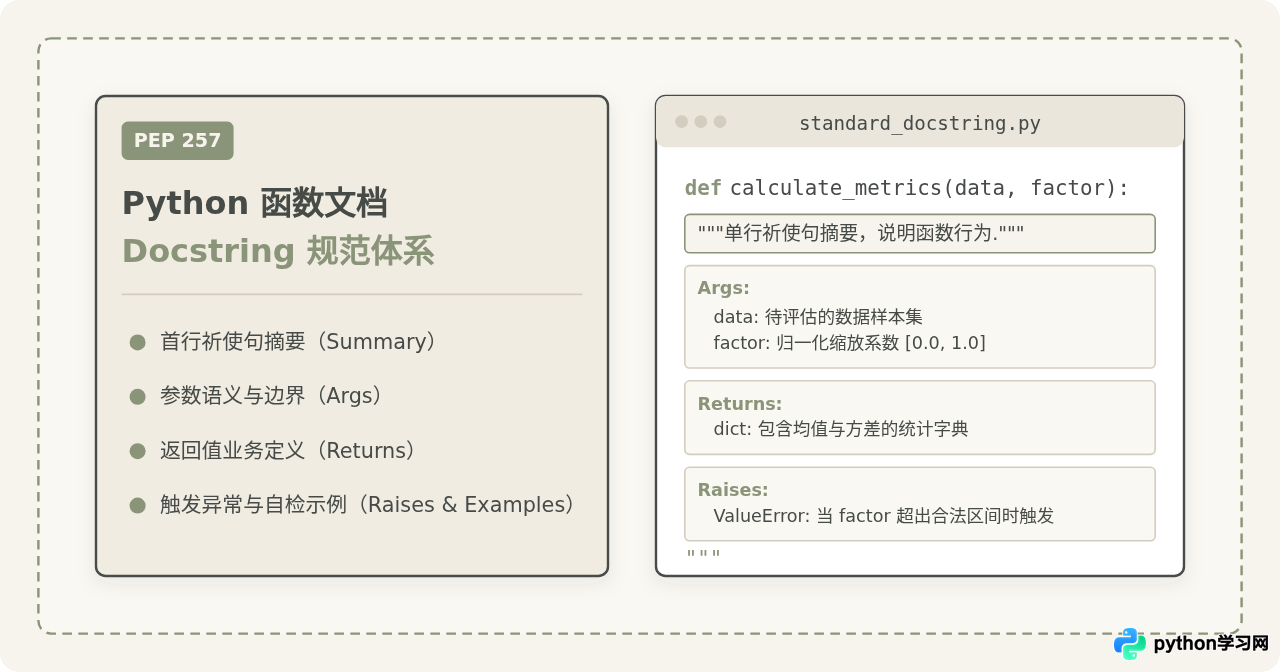
一、认识 Docstring:与普通代码注释的本质区别
在 Python 中,文档字符串(Docstring)是指紧跟在函数、类或模块定义下方的第一个字符串字面量。它与以 # 开头的普通行内注释有着本质不同:Docstring 会被 Python 解释器主动编译并挂载到对象的 __doc__ 属性中,属于代码元数据的一部分。
这意味着无论是在交互式命令行中使用 help(func_name),在现代 IDE(如 VS Code、PyCharm)中悬停查看函数提示,还是借助文档生成器自动输出 API 手册,读取的都是 Docstring。普通注释是写给维护函数内部实现的工程师看的,而 Docstring 是写给函数调用方看的“对外接口契约”。
二、PEP 257 核心准则:单行与多行骨架要求
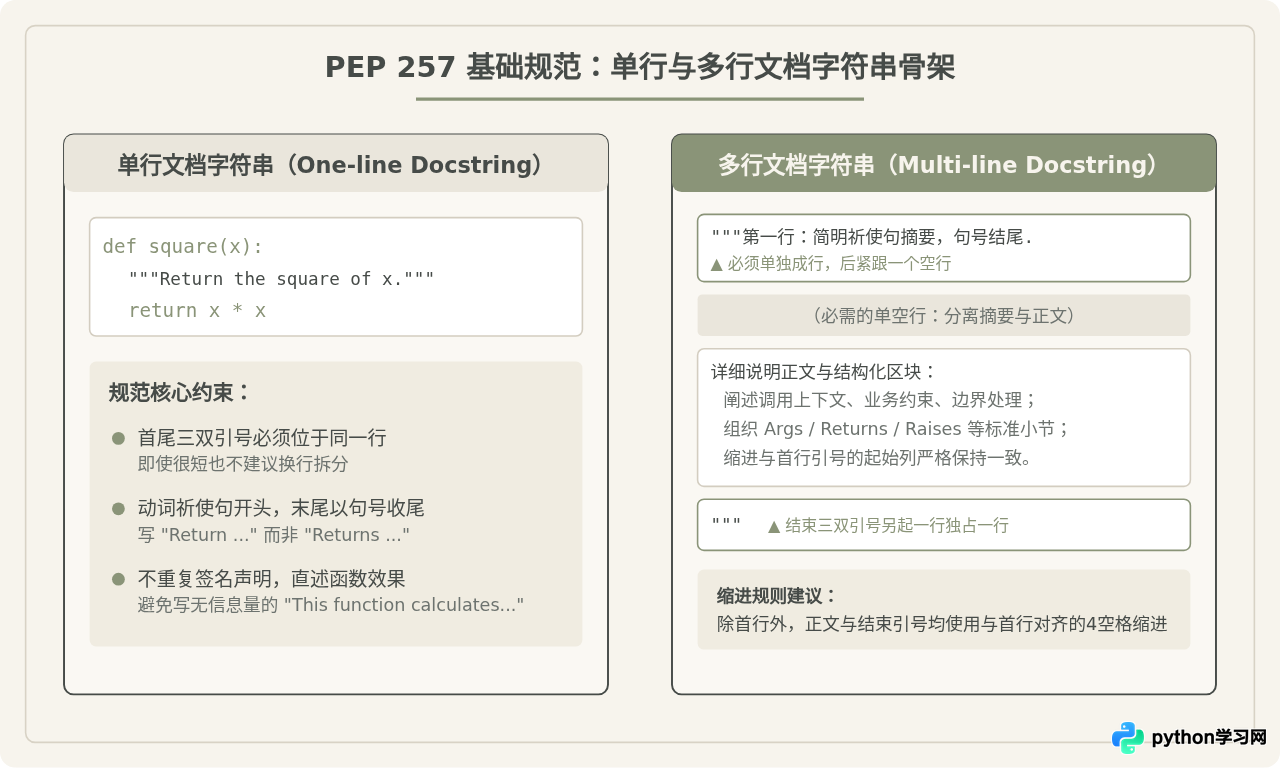
Python 官方在 PEP 257 中对文档字符串的排版给出了明确的基础约定。根据函数复杂度的不同,Docstring 分为单行文档字符串与多行文档字符串两种形态。
1. 单行文档字符串(One-line Docstrings)
单行文档字符串适用于行为单一、签名直观、无需额外补充参数说明的简单辅助函数。遵循以下硬性要求:
- 使用三双引号:即使内容只有一行,也统一使用
"""...""",方便后续扩展。 - 首尾引号在同一行:起始引号、文字内容与闭合引号必须全部保留在同一行中,不进行折行。
- 使用祈使句动词开头:表述应像一条指令(例如写
"""Return the absolute value of x."""),而不是陈述句(不写Returns...,也不写This function returns...)。中文则采用“计算并返回……”、“校验……”、“转换……”。 - 末尾以句号结尾:遵循标准语法标点。
def square(x: float) -> float:
    """计算并返回数值 x 的平方."""
    return x * x
2. 多行文档字符串(Multi-line Docstrings)
当函数涉及多个参数、边界约束、特定返回值结构或可能抛出的业务异常时,必须使用多行文档字符串。其排版骨架包括:
- 首行摘要独立成行:第一行同样是简明扼要的祈使句摘要,后跟句号。
- 强制保留单空行:摘要行下方必须空出一整行,将摘要与后续的详细描述区分开。这是许多文档生成工具正确解析短摘要的前提。
- 结构化详细描述:空行之后,依次阐述参数(Args)、返回值(Returns)、可能触发的异常(Raises)等结构块。
- 闭合引号单独占一行:结尾的三双引号
"""必须另起一行,缩进位置与首行的起始引号严格对齐。
三、主流 Docstring 风格对比与团队选型
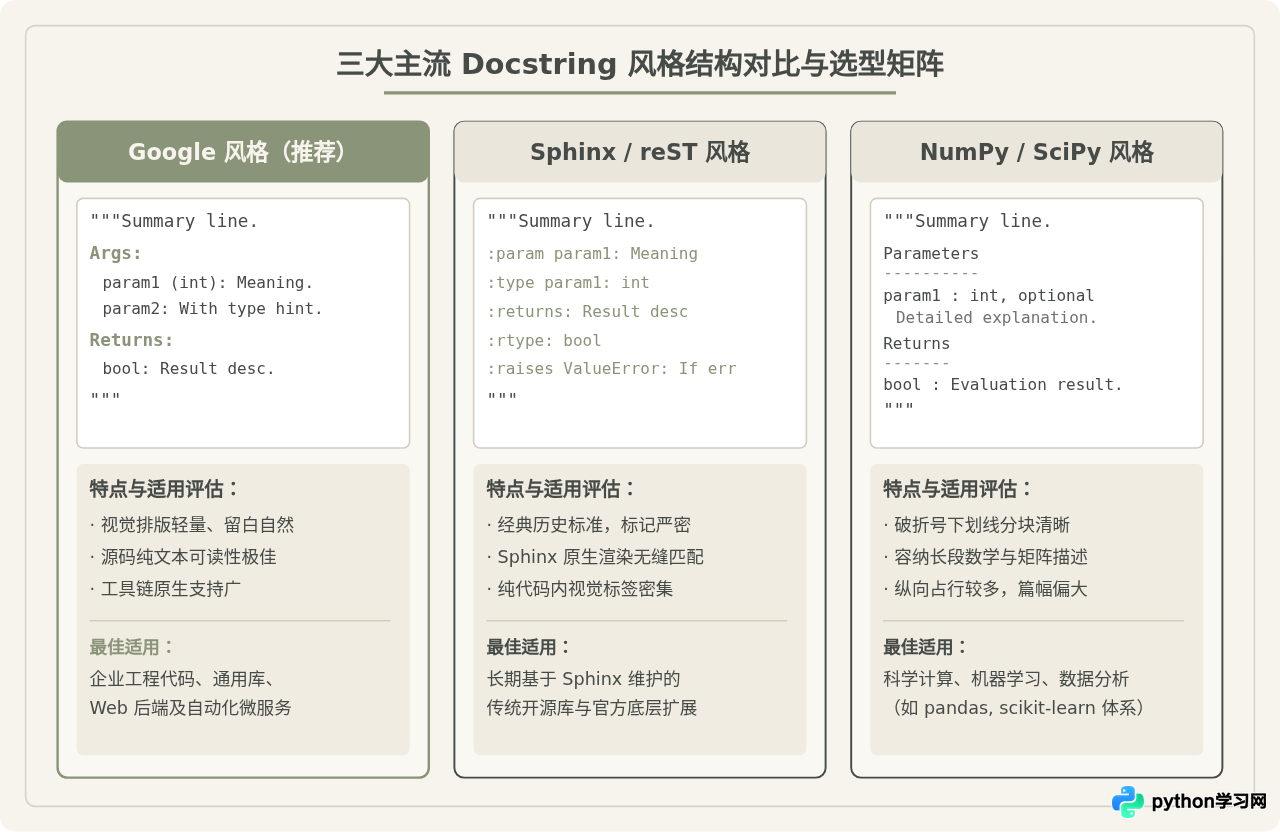
PEP 257 规定了空行与首行摘要等宏观原则,但没有规定参数、返回值该用什么标记格式。在工程实践中,行业形成了三种主流风格:Google 风格、Sphinx/reST 风格和 NumPy 风格。
1. Google 风格(Google Style)——通用工程推荐
Google 风格采用直观的轻量缩进小节(Args:、Returns:、Raises:)。它在源码中的可读性极好,不需要复杂的标记符号,阅读纯文本代码时就像在读排版整齐的说明书。目前在现代 Python 开源库和商业项目中应用最为广泛。
2. Sphinx / reStructuredText 风格 —— 传统标准
Sphinx 风格使用显式的字段标签(如 :param name:、:type name:、:returns:)。它是 Python 官方文档和早期开源库的标配。其优势是 Sphinx 原生无需任何插件即可直接编译出 HTML 手册;但缺点是标签符号较多,在代码编辑器中阅读纯文本时容易显得繁琐紧绷。
3. NumPy / SciPy 风格 —— 科学计算标准
NumPy 风格使用段落标题加下划线破折号(如 Parameters
----------)。这种风格版面宽阔大气,能够容纳大段复杂的数学公式、多维数组形状(shape)说明与长文本理论阐释,因此在 numpy、pandas、scipy 等数据科学库中占主导地位。
四、规范 Docstring 的关键要素与标准写法
以现代工程中使用最广的 Google 风格为例,一个完备规范的函数文档字符串包含五个关键组成部分:
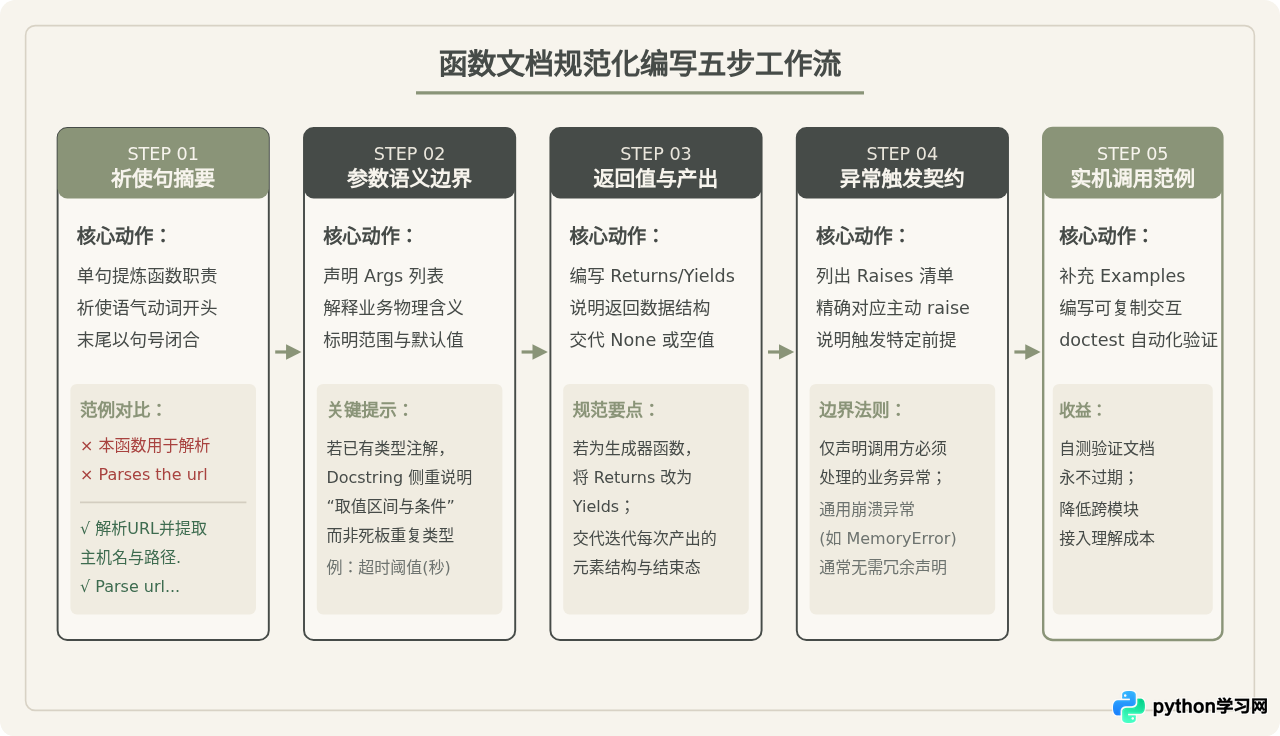
1. 摘要行(Summary Line)
一句话讲清函数的核心作用。避免啰嗦的空话,直接指出该函数对输入数据做了什么、产生了什么结果。
2. 参数说明(Args)
列出所有形式参数(除 self 和 cls 之外)。格式为:参数名紧跟冒号,空一格写说明。若代码已包含 Python 3 的类型注解(Type Hints),可以不在 Docstring 中重复类型名称;若未写类型注解,则可在参数名后加括号注明类型,如 timeout (float): 超时秒数。
重点说明参数的业务物理含义、取值范围、单位限制、合法枚举值以及默认值的含义,这些信息是类型系统无法完全表达的。
3. 返回值(Returns)与生成器(Yields)
说明函数执行完毕后返回的内容。写明返回值的类型(若函数签名未注解)以及所代表的具体业务对象。如果是生成器函数(内部包含 yield),应使用 Yields: 替代 Returns:,交代每一次迭代产出的元素含义与生成终止条件。
4. 异常声明(Raises)
明确列出该函数在什么具体条件下会主动抛出异常。只列出调用方在正常业务逻辑中预期应该显式捕获或防范的异常类型(例如参数校验失败抛出 ValueError,资源不存在抛出 FileNotFoundError)。系统级灾难异常(如 MemoryError、KeyboardInterrupt)无需在每个函数中声明。
5. 调用示例(Examples)
对于逻辑复杂、输入格式特殊的函数,提供简短清晰的代码示例能极大提升易用性。推荐采用 Python 交互式命令行格式(以 >>> 开头),这样的示例可以直接被标准库的 doctest 模块识别并进行自动化测试验证。
6. 完整标准函数示范
下面是一个涵盖完整规范要素的生产级函数实现与 Docstring 示例:
from typing import List, Optional

def calculate_trimmed_mean(
    scores: List[float],
    trim_ratio: float = 0.1
) -> float:
    """计算修剪均值(Trimmed Mean),剔除两端极值后求平均.

    对输入的数据集按升序排列,分别从头部和尾部截断指定比例的数据点,
    以消除异常极值对统计平均水平的干扰。

    Args:
        scores: 待计算的数值样本列表,元素必须为浮点数或整数.
        trim_ratio: 两端截断的比例比例值,取值区间必须为 [0.0, 0.5).
            默认值为 0.1(即首尾各剔除 10% 的极值数据).

    Returns:
        float: 修剪后的样本算术平均值. 如果剔除后恰好只剩一个元素,
        则直接返回该元素值.

    Raises:
        ValueError: 当 scores 为空列表时触发.
        ValueError: 当 trim_ratio 小于 0.0 或大于等于 0.5 时触发.

    Examples:
        >>> data = [1.0, 2.0, 3.0, 4.0, 100.0]
        >>> calculate_trimmed_mean(data, trim_ratio=0.2)
        3.0
    """
    if not scores:
        raise ValueError("scores 列表不能为空")
    if not (0.0 <= trim_ratio < 0.5):
        raise ValueError("trim_ratio 必须位于区间 [0.0, 0.5)")

    sorted_scores = sorted(scores)
    n = len(sorted_scores)
    k = int(n * trim_ratio)

    trimmed = sorted_scores[k : n - k]
    return sum(trimmed) / len(trimmed)
五、常见认知偏差与实践辨析
在编写函数文档时,开发者常常会遇到一些看似合理、实则存在认知偏差的说法。理性分析这些说法的成立条件与边界,有助于更好地把握文档的深度。
辨析一:“既然已有类型注解(Type Hints),Docstring 里的参数说明是不是多余了?”
为什么看似合理:在现代 Python 3 中,通过 scores: List[float] 已经能在语法层面交代参数的数据类型,静态检查工具(mypy)也能进行有效拦截。如果 Docstring 仅仅重复写一句“scores (list): 一个浮点数列表”,确实没有增量价值。
修正与正确做法:类型注解解决的是“计算机层面的类型校验”,但无法说明“人类层面的业务契约”。例如,trim_ratio: float 只能表达它是浮点数,无法表达“取值必须在 0.0 到 0.5 之间”、“两端按百分比剔除”这一业务逻辑。因此,在类型注解普及后,Docstring 应当省略冗余的纯类型罗列,聚焦于业务含义、合法区间、单位换算与特殊场景,二者是互补协同的关系。
辨析二:“优秀的代码应当自解释,写 Docstring 属于过渡冗余?”
为什么看似合理:通过合理的函数命名(如 is_valid_email)和简短的内部结构,代码本身的执行路径确实应该做到清晰易懂。
修正与正确做法:“代码自解释”解决的是实现细节(How),而 Docstring 解决的是设计意图与调用契约(Why & What)。调用方使用一个函数时,并不想深入查看其 30 行内部代码是如何处理切片、排序与边界分支的。Docstring 构筑了模块间的抽象屏障,让调用方无需阅读源码实现就能安全调用。
辨析三:“Docstring 越长越好,最好把算法实现细节全写进去?”
为什么看似合理:写作者希望尽可能交代清楚函数的每一个考量。
修正与正确做法:Docstring 面向的是外部调用者,而非该函数未来的维护重构者。如果把内部使用了快速排序还是归并排序、声明了哪个私有临时变量等细节写入 Docstring,一旦后续优化算法,Docstring 就会立刻过时变成谎言。实现层面的算法推导和技术折衷,应该使用普通的行内注释(#)写在函数体内部。
六、规范落地:自动化检查与质量闭环
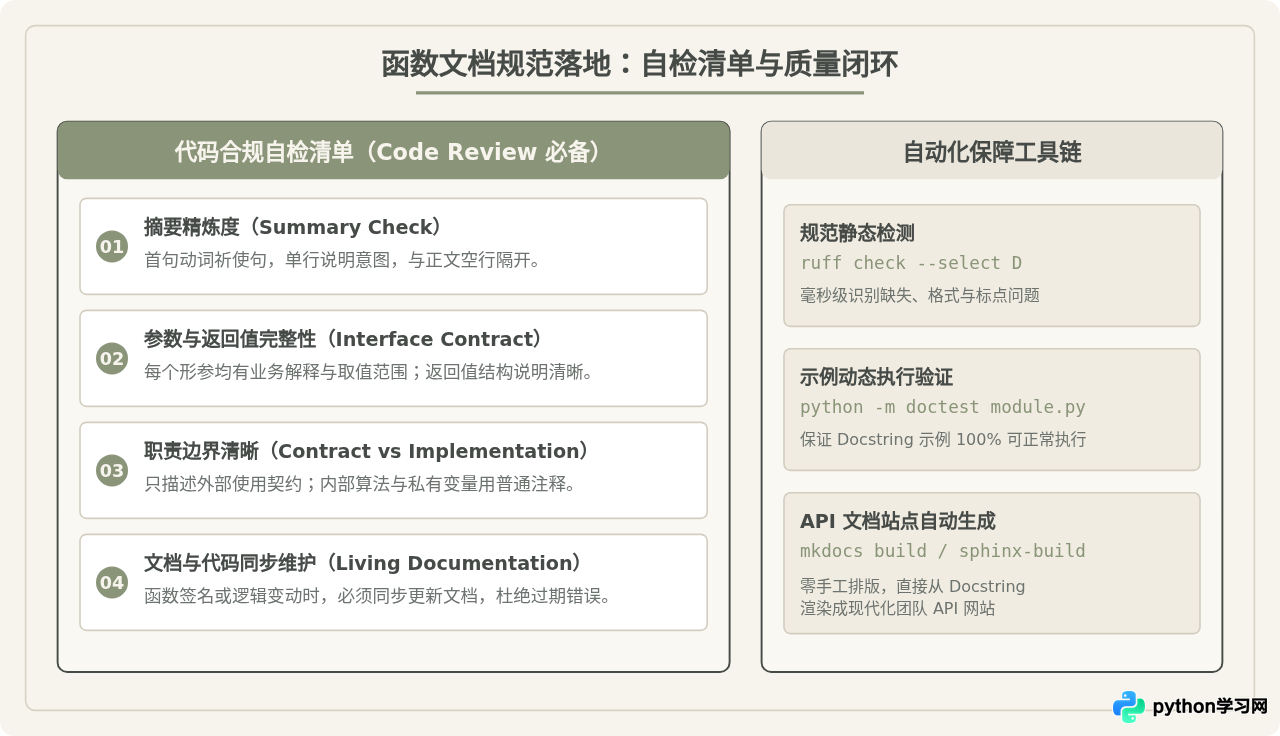
写好规范的关键在于将规则嵌入自动化工具链,避免依赖口头约定。
- IDE 自动模板生成:在 VS Code 中安装
autoDocstring插件,或在 PyCharm 中配置 Docstring 格式为 Google,输入三双引号后按回车,即可根据当前函数的参数签名自动生成骨架。 - 静态语法校验:使用现代代码分析器
ruff(启用D规则族,即pydocstyle规则集)。可以在提交代码时自动识别未空行、缺少句号、缺少参数说明等语法违规:# 使用 ruff 检查整个项目的 docstring 规范 ruff check . --select D - 示例执行校验:利用 Python 标准库自带的
doctest工具,在持续集成(CI)流程中自动验证 Docstring 中的代码范例是否能得到预期输出:# 校验模块内部 docstring 的执行结果 python -m doctest calculate.py -v
七、总结
编写规范的 Python 函数文档字符串,本质是为代码建立清晰、稳定、对调用方友好的契约。在日常开发中,建议牢记以下核心要领:
- 以 PEP 257 为基底,全团队统一采用 Google 风格作为接口文档骨架。
- 单行摘要坚持祈使句动词开头,末尾以句号闭合;多行文档务必在摘要后空出一行。
- 在参数与返回值说明中,重点补充业务含义、取值区间与边界条件,与类型注解形成互补。
- 明确标注函数主动抛出的业务异常,并在关键路径上编写能够被
doctest验证的交互示例。 - 通过
ruff检查与自动化文档构建工具将规范融入研发流水线,确保代码与文档同步演进。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















