


怎么使用subprocess在Python中并行运行多个脚本
本文详细讲解在Python中使用subprocess模块并行运行多个外部脚本的方法,剖析Popen与run的机制差异,提供多进程列表管理与线程池受控并发的完整代码与避坑指南。
subprocess 模块并行运行多个外部脚本的核心在于避免主线程被单一进程阻塞。常规的 subprocess.run() 属于同步阻塞调用,只有使用非阻塞的底层接口 subprocess.Popen 批量派生子进程,或者利用 concurrent.futures.ThreadPoolExecutor 维护固定并发池来调度 subprocess.run(),才能真正实现多个脚本在操作系统后台的同时执行与统一回收。
一、为什么常规的 subprocess.run 无法实现并行
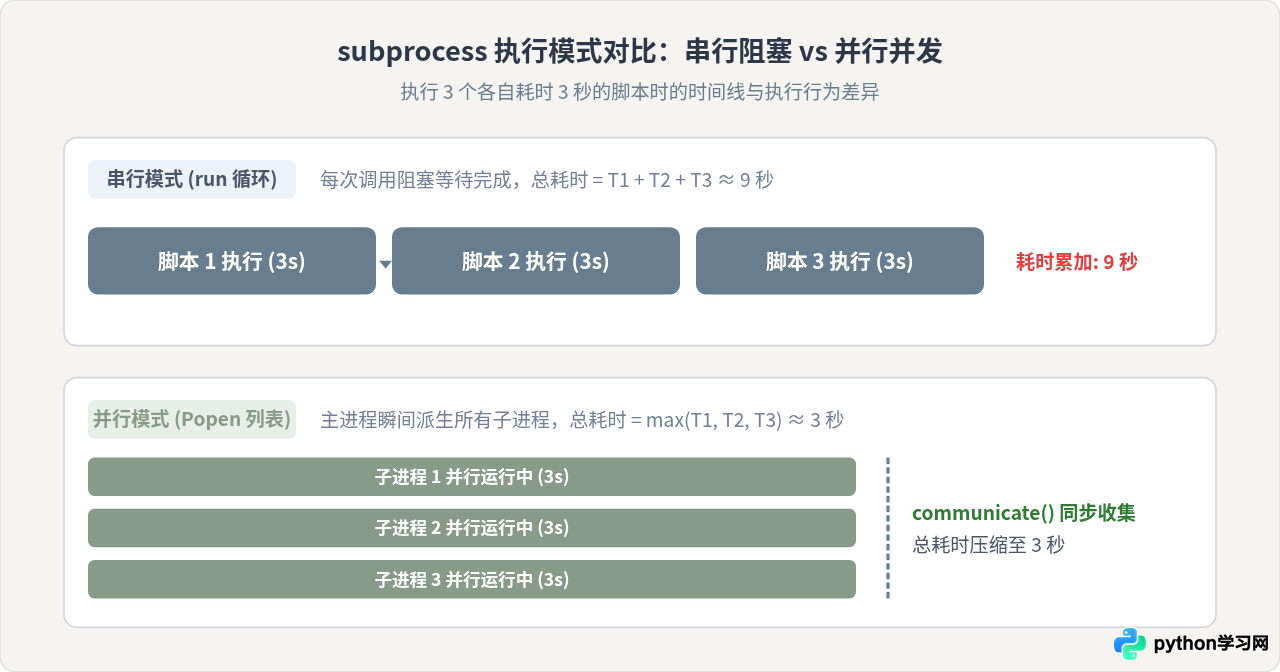
许多开发者在需要运行多个 Python 脚本时,会直觉性地编写一个 for 循环并在其中反复调用 subprocess.run()。然而,subprocess.run() 的设计定位是“运行命令直至结束”。主进程在执行这一函数时会暂停当前线程的推进,进入阻塞等待状态,直到外部子进程完全退出、返回状态码并关闭数据流后,才会交还控制权。
这意味着,如果列表里有 3 个分别需要耗时 3 秒的任务脚本,采用循环调用 subprocess.run() 的方式将严格按顺序执行,总耗时为 9 秒。要让这 3 个脚本同时在操作系统的各个 CPU 核心上并行运行,必须在派生子进程后不立即等待其结束,而是快速派生下一个任务,使所有子进程处于并存状态。
二、核心方法一:使用 Popen 列表实现多脚本并行
subprocess.Popen 是 subprocess 模块的核心底层构造器。当你实例化一个 Popen 对象时,操作系统会立即派生出一个新的子进程执行指令,而 Python 主进程的代码会立刻向下执行,不会发生卡顿。
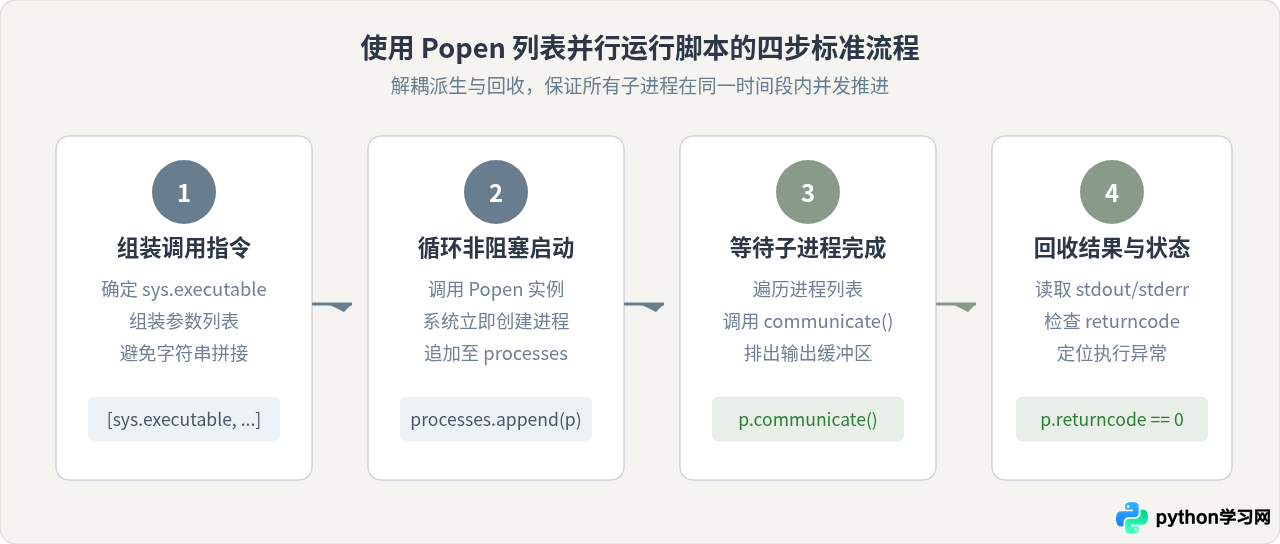
因此,并行运行的核心逻辑可以分为两个清晰的阶段:
- 派生阶段:快速循环启动所有任务脚本的
Popen实例,并将每个进程句柄保存在一个列表中。 - 回收阶段:在所有进程都已启动后,再循环遍历该列表,逐一调用
communicate()或wait()挂起等待它们退出并回收结果。
1. 准备子脚本 worker.py
为了验证并行效果,我们先准备一个模拟执行耗时任务的子脚本 worker.py。它接收一个任务名称和休眠秒数作为参数,并在运行结束后打印输出:
# worker.py
import sys
import time

def main():
    if len(sys.argv) < 3:
        print("参数不足,请提供任务名称与耗时秒数", file=sys.stderr)
        sys.exit(1)

    task_name = sys.argv[1]
    duration = float(sys.argv[2])

    print(f"[{task_name}] 开始执行,预计耗时 {duration} 秒...")
    time.sleep(duration)
    print(f"[{task_name}] 执行完毕。")

if __name__ == "__main__":
    main()
2. 编写主调度程序 main_popen.py
主程序通过 sys.executable 获取当前运行 Python 解释器的绝对路径,确保子脚本运行在相同的虚拟环境与解释器环境中:
# main_popen.py
import sys
import subprocess
import time

def run_scripts_in_parallel():
    # 待运行的任务参数配置:(任务名, 模拟耗时)
    tasks = [
        ("Task-A", 3),
        ("Task-B", 3),
        ("Task-C", 3)
    ]

    start_time = time.time()
    processes = []

    print(f"开始派生 {len(tasks)} 个并行脚本...")

    # 第一阶段:非阻塞循环启动所有脚本
    for task_name, duration in tasks:
        cmd = [sys.executable, "worker.py", task_name, str(duration)]

        # 启动子进程,将标准输出与标准错误重定向到管道
        proc = subprocess.Popen(
            cmd,
            stdout=subprocess.PIPE,
            stderr=subprocess.PIPE,
            text=True  # 自动以文本形式解码输出
        )
        processes.append((task_name, proc))
        print(f"-> 子进程 {task_name} (PID: {proc.pid}) 已派生")

    print("\n所有子进程已启动,主线程等待完成并回收输出...")

    # 第二阶段:遍历等待所有进程结束并读取结果
    for task_name, proc in processes:
        stdout_data, stderr_data = proc.communicate()
        return_code = proc.returncode

        print(f"\n[{task_name}] 退出码: {return_code}")
        if stdout_data:
            print(f"输出内容:\n{stdout_data.strip()}")
        if stderr_data:
            print(f"错误内容:\n{stderr_data.strip()}")

    total_elapsed = time.time() - start_time
    print(f"\n全部任务执行完毕,总耗时: {total_elapsed:.2f} 秒")

if __name__ == "__main__":
    run_scripts_in_parallel()
运行该程序,你会观察到如下执行行为:3 个进程几乎在瞬间被同时拉起并获得系统 PID,最终总运行时间约为 3 秒出头,成功将原本需要 9 秒的串行任务压缩为单个任务的单体耗时。
三、核心方法二:使用 ThreadPoolExecutor 控制并发数量
直接使用 Popen 列表的方式适用于任务总数较小(如 3 到 8 个)的场景。但是,当需要并行运行 50 个或数百个脚本时,如果直接在循环中派生 100 个 Popen 实例,操作系统将瞬间产生大量的进程与线程竞争,导致系统内存暴增、文件描述符耗尽,甚至造成机器卡死。
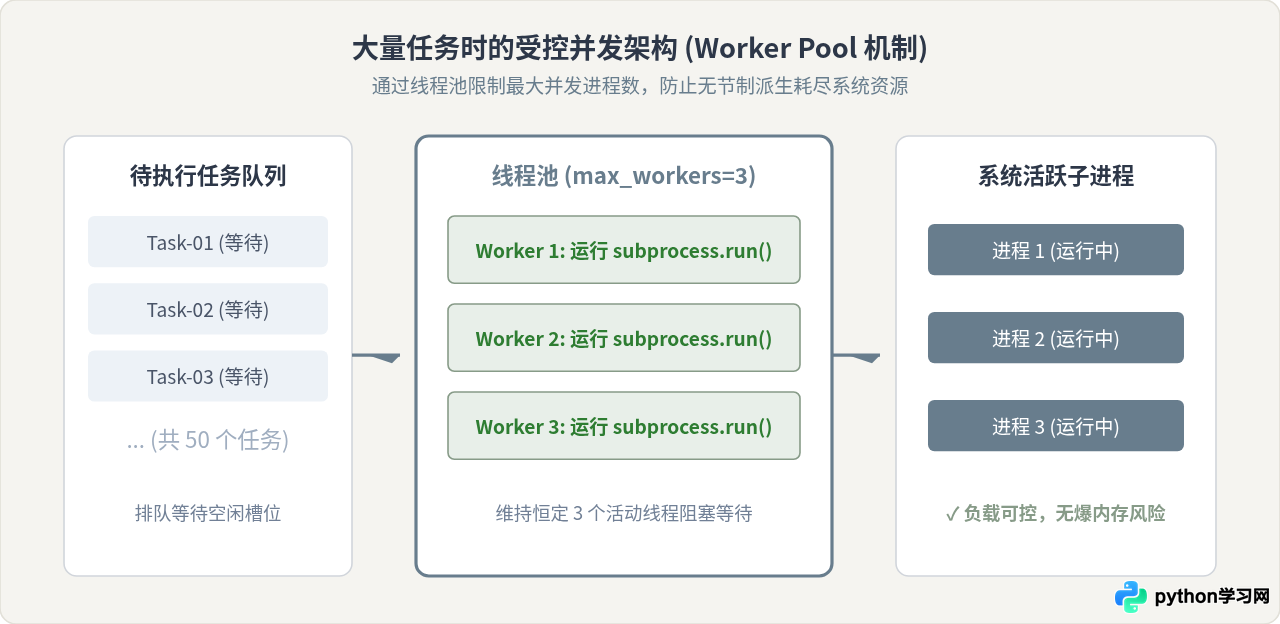
在这种情况下,更健壮的做法是使用 并发工作池(Worker Pool) 机制。借助 Python 标准库的 concurrent.futures.ThreadPoolExecutor,我们可以限制最大并发数量(例如设定 max_workers=4),每个线程内调用简单的 subprocess.run()。
受控并发示例代码
在下面代码中,我们将 max_workers 设为 3,即便任务列表包含 6 个任务,系统也只会在同一时间并发运行 3 个脚本。一个任务完成并退出后,空出的工作槽位会自动启动下一个等待中的任务:
# main_pool.py
import sys
import subprocess
import time
from concurrent.futures import ThreadPoolExecutor, as_completed

def execute_single_script(task_info):
    task_name, duration = task_info
    cmd = [sys.executable, "worker.py", task_name, str(duration)]

    # 在独立的工作线程中执行阻塞调用
    result = subprocess.run(
        cmd,
        capture_output=True,
        text=True
    )
    return {
        "task_name": task_name,
        "returncode": result.returncode,
        "stdout": result.stdout.strip(),
        "stderr": result.stderr.strip()
    }

def main():
    # 模拟 6 个任务
    task_list = [(f"BatchTask-{i}", 2) for i in range(1, 7)]
    max_concurrent = 3  # 最大同时运行的脚本数

    start_time = time.time()
    print(f"总计 {len(task_list)} 个任务,以最大并发度 {max_concurrent} 运行...")

    # 使用 ThreadPoolExecutor 管理并发工作池
    with ThreadPoolExecutor(max_workers=max_concurrent) as executor:
        # 将每个任务提交至线程池
        future_to_task = {
            executor.submit(execute_single_script, task): task[0]
            for task in task_list
        }

        # as_completed 允许实时捕获先完成的任务结果,无需按提交顺序阻塞
        for future in as_completed(future_to_task):
            task_name = future_to_task[future]
            try:
                res = future.result()
                status = "成功" if res["returncode"] == 0 else "失败"
                print(f"[{task_name}] 执行完成 ({status}),输出: {res['stdout']}")
            except Exception as exc:
                print(f"[{task_name}] 执行引发异常: {exc}", file=sys.stderr)

    total_time = time.time() - start_time
    print(f"\n全部任务受控执行完毕,总耗时: {total_time:.2f} 秒 (理论串行为 12 秒)")

if __name__ == "__main__":
    main()
四、两种并行方案的关键差异与选型依据
在一致的系统运行环境下,Popen 列表方案与线程池方案在资源控制能力与实现复杂度上存在显著差异。理解这些差异是保证生产环境稳定性的关键:
| 对比维度 | 方案一:原生 Popen 列表 | 方案二:ThreadPoolExecutor + run |
|---|---|---|
| 并发限制能力 | 无默认限制。列表中有多少任务就会瞬时创建多少子进程。 | 强限制。通过 max_workers 严格控制活跃进程上限。 |
| 代码结构复杂度 | 需显式维护进程句柄数组,手动管理启动与通信两阶段。 | 结构模块化。单个任务逻辑保持同步写法,调度由线程池托管。 |
| 结果获取机制 | 通常需按列表顺序逐个调用 communicate() 回收。 |
可使用 as_completed() 实现先完成的任务先处理。 |
| 适用业务场景 | 批次小、数量固定(如构建流程中同时跑 2-4 个静态检查工具)。 | 大批量批处理(如批量转码 100 个视频、批量下载或解析外部文件)。 |
五、常见陷阱与避坑注意事项
1. 管道缓冲区填满导致的死锁(Pipe Deadlock)
当我们在 Popen 中设置 stdout=subprocess.PIPE 或 stderr=subprocess.PIPE 时,操作系统会为子进程分配一个内存管道缓冲区(在 Linux/macOS 上通常为 64KB)。如果子进程输出了大量日志填满了缓冲区,子进程就会挂起等待数据被读出;此时如果主进程没有主动读取而是直接调用 wait() 等待进程退出,就会产生永久性相互等待死锁。
proc.stdout.read() 配合 proc.wait()。务必调用 proc.communicate(),该方法在底层使用了内部缓冲区读取机制,能够安全清空管道,杜绝死锁。
2. 解释器路径不一致
在命令行中直接输入 python 时,系统会依赖当前终端的 PATH 环境变量。如果在脚本中硬编码 cmd = ["python", "script.py"],当主程序运行在虚拟环境(如 venv 或 conda)中时,派生出的子进程很可能回退到系统全局的 Python 解释器,导致导入第三方包时报 ModuleNotFoundError。因此,请始终使用 sys.executable 作为可执行文件路径。
3. 返回码验证与异常捕获
子进程执行报错(如脚本抛出未捕获异常退出)并不会直接在主进程中抛出 Python 异常。主进程如果只管启动而不校验 returncode,就会误以为脚本执行成功。在调用 communicate() 或 run() 后,必须检查返回码是否为 0,或者在 subprocess.run() 中显式传入 check=True。
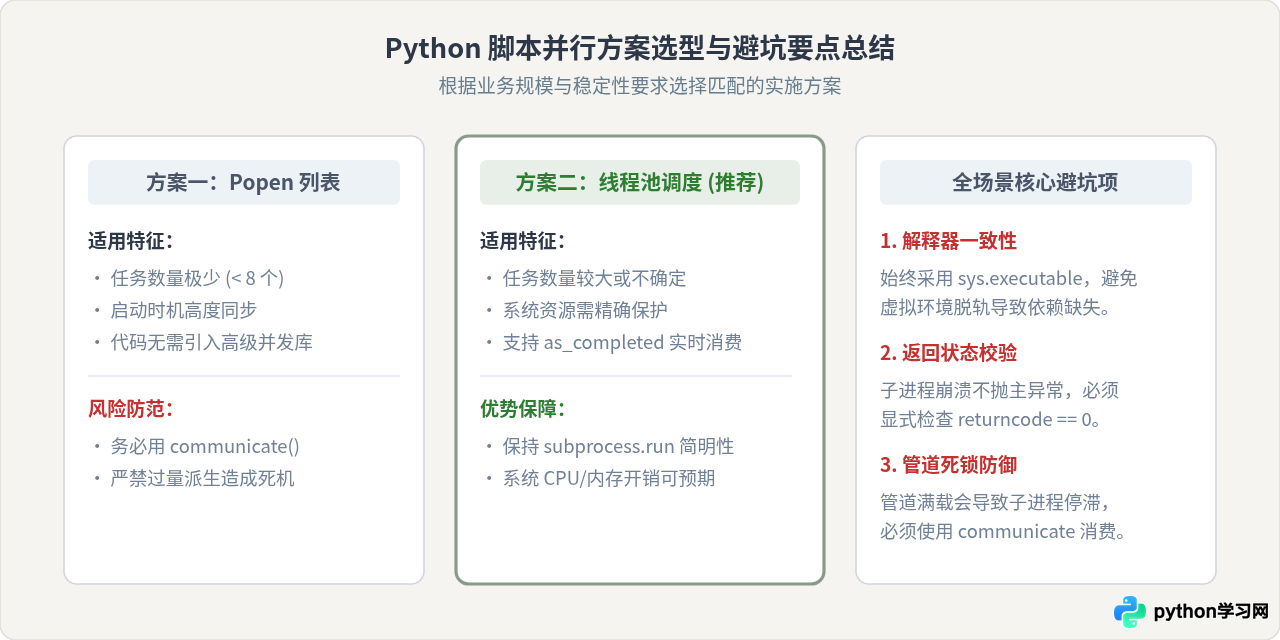
六、总结
在 Python 中利用 subprocess 并行运行多个外部脚本,本质上是将单次阻塞的子进程执行,转换为并行的非阻塞多进程操作。少量任务可直接通过 subprocess.Popen 列表分阶段派生与回收;大批量任务则应采用 ThreadPoolExecutor 配合 subprocess.run() 建立受控的并发工作池。在编写脚本时,牢记使用 sys.executable 锁定环境、通过 communicate() 规避管道死锁并严格校验退出状态码,便能构建出高效且稳健的多脚本并行执行流程。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















