


Python嵌套字典的递归遍历实现
深入解析Python嵌套字典的递归遍历实现方法,从基础递归调用、键路径拼接、字典展平,到复合列表解析及循环引用防范,提供完整代码与详尽图解。
处理外部接口返回的 JSON 数据、复杂的应用程序配置或分层元数据时,多层嵌套字典是 Python 开发者最常面对的数据结构之一。当字典层级深度不固定或各分支结构不统一时,常规的多重 for 循环不仅代码繁琐,而且难以扩展。解决这类问题的标准路径是递归遍历:通过“叶子节点直接输出,字典节点调用自身”的分治思想,能够以极少量的代码优雅地遍历任意深度的嵌套结构。
一、嵌套字典的结构特征与递归模型
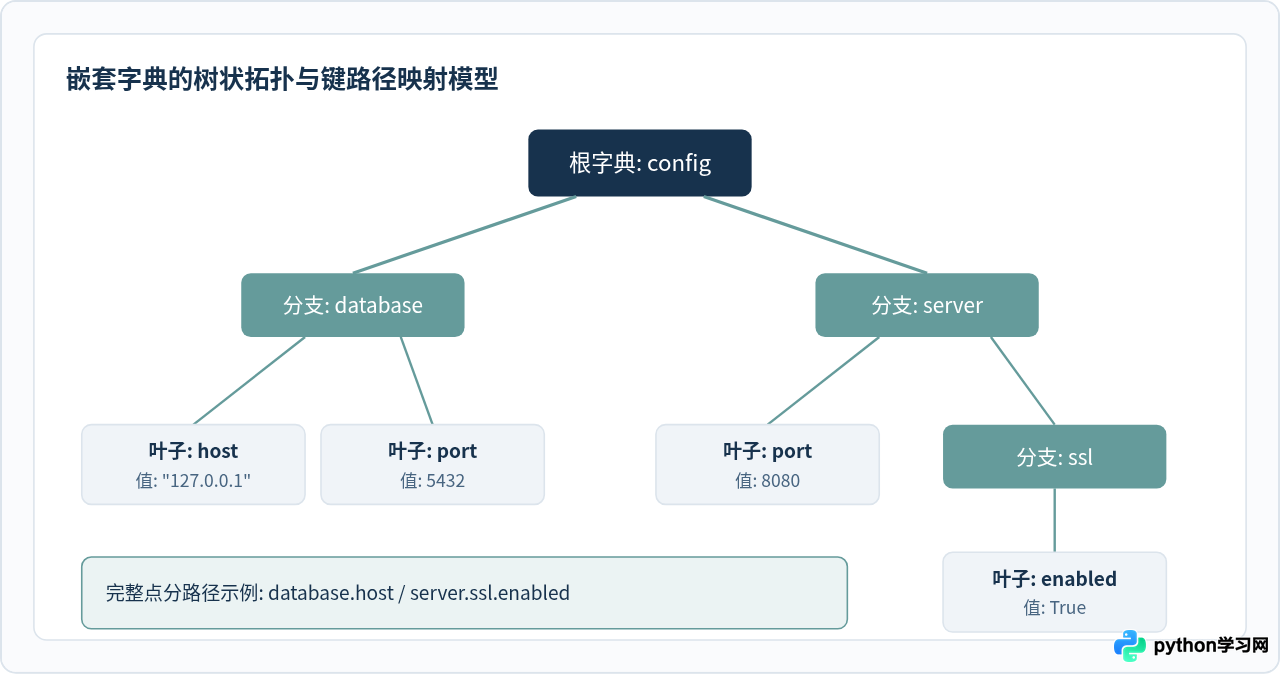
在理解代码前,先明确嵌套字典的数学本质。一个包含多层字典的对象本质上是一棵以键值对构成的多叉树(Multi-way Tree)。顶层字典是树的根节点(Root),中间层包含子字典的键是非叶子节点(Branch),而最终存放具体数据(如数值、字符串、布尔值)的键值对则是树的叶子节点(Leaf)。
设计递归遍历时,需要确立两个关键条件:一是递归推进条件(遇到子字典,将当前子字典与累积路径作为参数,深入调用自身);二是递归基(遇到基本数据类型的叶子节点,触发终止并执行记录或打印操作,随后自然回溯到上一层)。
二、基础递归遍历:逐层访问键与值
最直接的需求是遍历整个字典并打印所有叶子节点的键及其对应值。实现时,遍历函数接受两个主要参数:当前子字典对象 d,以及当前层级的父级路径 parent_key。
def print_nested_dict(d, parent_key="", sep="."):
    """
    基础递归遍历函数:按层级打印完整路径与对应值
    """
    for key, value in d.items():
        # 构建当前节点的完整路径
        current_path = f"{parent_key}{sep}{key}" if parent_key else str(key)

        # 递归判定:如果当前值仍然是字典,继续递归下钻
        if isinstance(value, dict):
            print_nested_dict(value, parent_key=current_path, sep=sep)
        else:
            # 递归基:达到普通值叶子节点,执行具体业务逻辑
            print(f"路径: {current_path} -> 最终值: {value}")
我们准备一个包含三层嵌套的配置字典进行调用验证:
app_config = {
    "app_name": "GatewayService",
    "network": {
        "host": "0.0.0.0",
        "port": 9000
    },
    "security": {
        "auth": {
            "enabled": True,
            "token_ttl": 3600
        }
    }
}

print_nested_dict(app_config)路径: app_name -> 最终值: GatewayService 路径: network.host -> 最终值: 0.0.0.0 路径: network.port -> 最终值: 9000 路径: security.auth.enabled -> 最终值: True 路径: security.auth.token_ttl -> 最终值: 3600
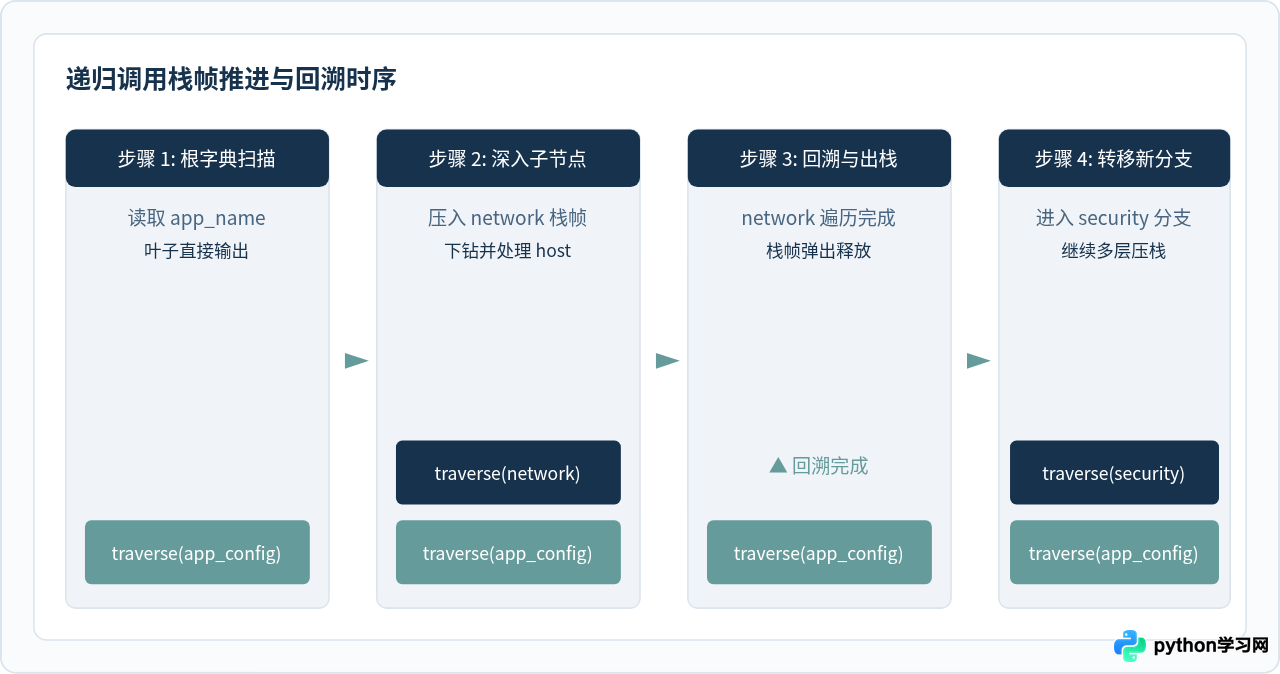
程序执行时,Python 解释器在内存中维护调用栈。当进入 network 节点时,父级上下文被压入调用栈;当 network.port 处理完毕后,该分支返回,栈帧弹出,随后主循环继续推进到 security 分支。
三、实战进阶:展平嵌套字典(Flatten)
除了打印内容,实际开发中最常见的操作是将任意深度的多层字典拍平成一层字典(Flat Dictionary),把层级关系直接映射到连接符构成的单一键名上。例如在将层级配置注入环境变量或将 JSON 导入关系型数据库平面表时,这一模式非常高效。
def flatten_dict(d, parent_key="", sep=".", result=None):
    """
    将嵌套字典展平为一维字典。
    通过在递归中传递同一个结果字典或新建累积,实现结果聚合。
    """
    if result is None:
        result = {}

    for key, value in d.items():
        # 合并路径
        new_key = f"{parent_key}{sep}{key}" if parent_key else str(key)

        if isinstance(value, dict):
            # 存在子字典,递归展平并共享同一个 result
            flatten_dict(value, parent_key=new_key, sep=sep, result=result)
        else:
            # 基础类型直接写入结果
            result[new_key] = value

    return result
也可以使用基于生成器(Generator)的 yield 写法,这样可以在内存中按需流式消费,避免一次性生成超大字典:
def iter_flatten(d, parent_key="", sep="."):
    """基于 yield 生成器的流式扁平化遍历"""
    for key, value in d.items():
        new_key = f"{parent_key}{sep}{key}" if parent_key else str(key)
        if isinstance(value, dict):
            # 将子生成器的键值对完整委托产出
            yield from iter_flatten(value, parent_key=new_key, sep=sep)
        else:
            yield (new_key, value)

# 转换为普通字典
flat_result = dict(iter_flatten(app_config))
四、应对复合结构:同时处理子字典与列表
真实的业务场景往往更加复杂。现代 RESTful API 返回的 JSON 数据不仅包含多层嵌套字典,还经常嵌套列表(List),例如一个部门字典下包含员工列表,每个员工又是包含个人信息的字典。如果递归函数只判断 isinstance(value, dict),列表内的子字典就会被当做叶子节点直接略过。
为了做到全结构遍历,我们需要扩展分支条件,当遇到 list 类型时,遍历列表中的每一个元素并把索引序号(如 [0]、[1])作为路径的一部分继续递归。
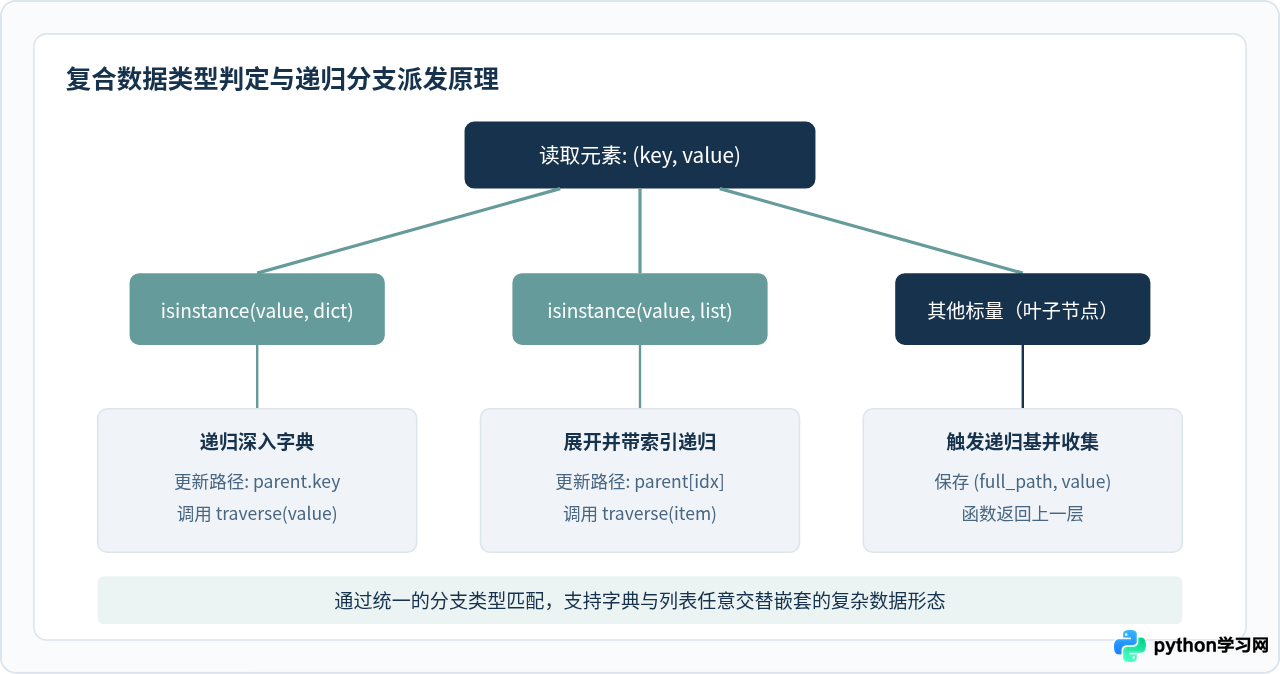
下面是能够同时解析字典与列表复合嵌套的完整实现:
def traverse_composite(data, parent_path=""):
    """
    支持字典与列表混合嵌套的全量递归遍历
    """
    if isinstance(data, dict):
        for key, value in data.items():
            current_path = f"{parent_path}.{key}" if parent_path else str(key)
            # 递归处理子元素
            yield from traverse_composite(value, current_path)

    elif isinstance(data, list):
        for index, item in enumerate(data):
            # 将列表索引包装为 [0], [1] 格式
            current_path = f"{parent_path}[{index}]"
            # 递归处理列表内每一个成员
            yield from traverse_composite(item, current_path)

    else:
        # 到达非集合类型的终点
        yield (parent_path, data)
验证一段典型的微服务返回数据:
complex_payload = {
    "project": "CloudCluster",
    "nodes": [
        {"ip": "10.0.0.1", "role": "master"},
        {"ip": "10.0.0.2", "role": "worker"}
    ]
}

for path, val in traverse_composite(complex_payload):
print(f"{path} = {val}")project = CloudCluster nodes[0].ip = 10.0.0.1 nodes[0].role = master nodes[1].ip = 10.0.0.2 nodes[1].role = worker
五、边界问题与生产环境防御
在实际生产环境中,处理未经清洗的复杂数据源时,递归实现需要应对两个潜在隐患:
1. 最大递归深度超限(RecursionError)
Python 解释器为了防止栈溢出,设置了默认的最大递归深度(通常为 1000)。如果遇到异常数据嵌套了上千层,会导致程序抛出 RecursionError: maximum recursion depth exceeded。
- 临时调整:可通过
sys.setrecursionlimit(5000)扩大限制,但这仅适用于明确受信任且已知深度的场景。 - 架构优化:如果层级极端未知或数据深度不可预测,应将递归改写为基于显式列表模拟的“迭代式深度优先遍历(DFS)”,利用堆内存代替调用栈。
2. 循环引用检测(Circular Reference)
在 Python 中,字典可以通过赋值形成自引用或相互环状引用。一旦遇到环状字典,普通的递归函数将陷入死循环,直到堆栈耗尽奔溃。解决方法是使用一个集合记录已访问对象的唯一标识 id(obj):
def safe_traverse(d, parent_key="", visited=None):
    """
    带有循环引用检测的安全递归遍历
    """
    if visited is None:
        visited = set()

    dict_id = id(d)
    if dict_id in visited:
        # 检测到循环引用,直接退出避免死循环
        print(f"[警告] 检测到循环引用: {parent_key} 已被访问,跳过深入")
        return

    visited.add(dict_id)

    for key, value in d.items():
        new_key = f"{parent_key}.{key}" if parent_key else str(key)
        if isinstance(value, dict):
            safe_traverse(value, parent_key=new_key, visited=visited)
        else:
print(f"{new_key}: {value}")id(obj) 时应确保对象在生命周期内不被垃圾回收复用内存地址。在递归传参的整个调用周期内,对象始终存在于父作用域中,因此使用 id() 辨识同一内存对象是安全可靠的。
六、方案对比与技术选型总结
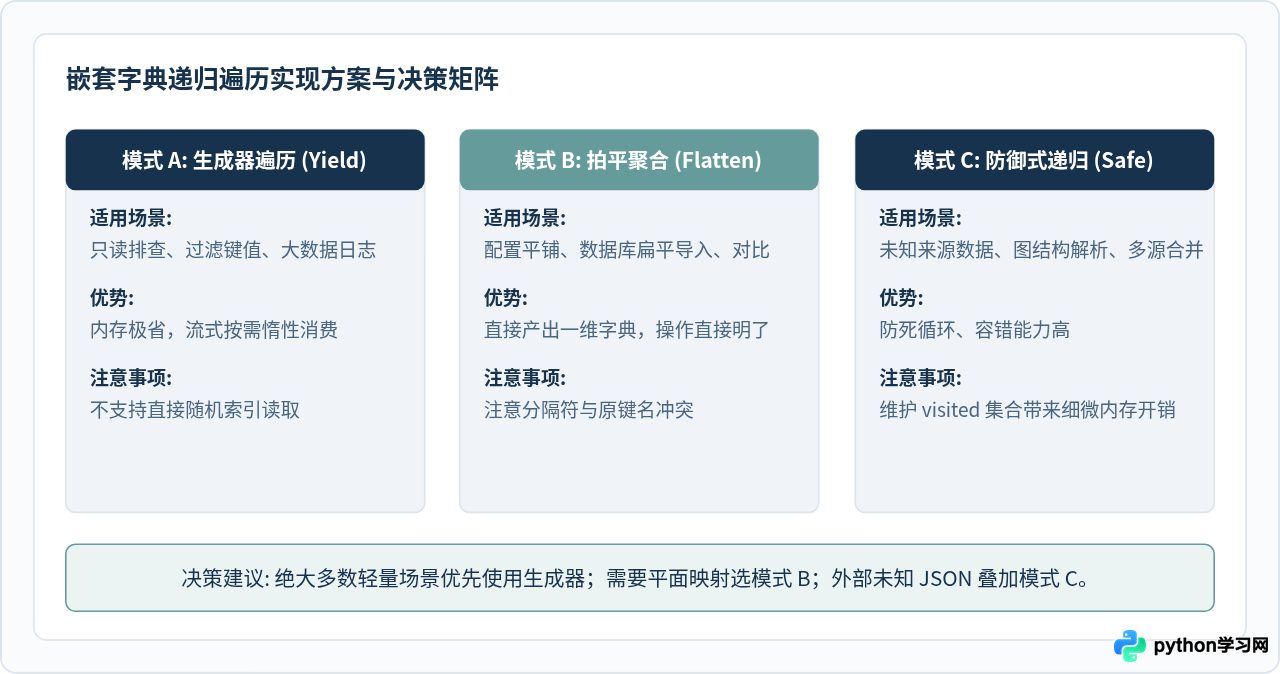
根据具体的工程诉求,递归遍历嵌套字典主要有三种落地形态。选择时应结合数据深度、输出用途以及内存控制综合评估:
| 实现模式 | 典型返回类型 | 空间复杂度 | 核心优势 | 适用业务场景 |
|---|---|---|---|---|
| 基础路径打印 | None(控制台输出) |
O(D) 栈深度 | 逻辑最轻、零内存积压 | 调试、实时监控日志输出 |
| 字典展平 (Flatten) | dict(扁平键值对) |
O(N) 节点总数 | 结构单一,便于直接存取 | 配置合并、入库与转换 |
| 复合类型生成器 | Iterator[Tuple] |
O(D) 栈深度 | 原生支持列表与字典混排 | RESTful API 复杂 JSON 解析 |
| 带环检测安全遍历 | Iterator / dict |
O(N + D) | 杜绝死循环,异常熔断保护 | 复杂数据模型、图遍历 |
总结来说,编写 Python 嵌套字典遍历逻辑的关键在于明确“递归基”与“累积路径传递”。通过判断节点是基本类型还是容器类型(字典或列表),既能保证遍历逻辑自顶向下有序穿透,又能在回溯过程中完成数据清洗与重组。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















