


Python常用数据格式库盘点:JSON、XML、YAML处理方案对比
全面盘点Python中处理JSON、XML、YAML的核心标准库与第三方库,系统对比语法特性、解析性能、安全防护机制与工程选型依据。
在 Python 后端研发、自动化运维与数据工程中,JSON、XML 与 YAML 是三种最核心的结构化数据格式。选择恰当的解析库不仅决定了系统的吞吐性能,更直接关乎运行时的内存开销与安全防线。本文将直入核心,系统梳理这三种格式在 Python 生态中的标准库与主流第三方方案,并通过具体代码、性能评估与安全实战,给出切实可行的选型建议。
一、三种数据格式核心特征与形态差异
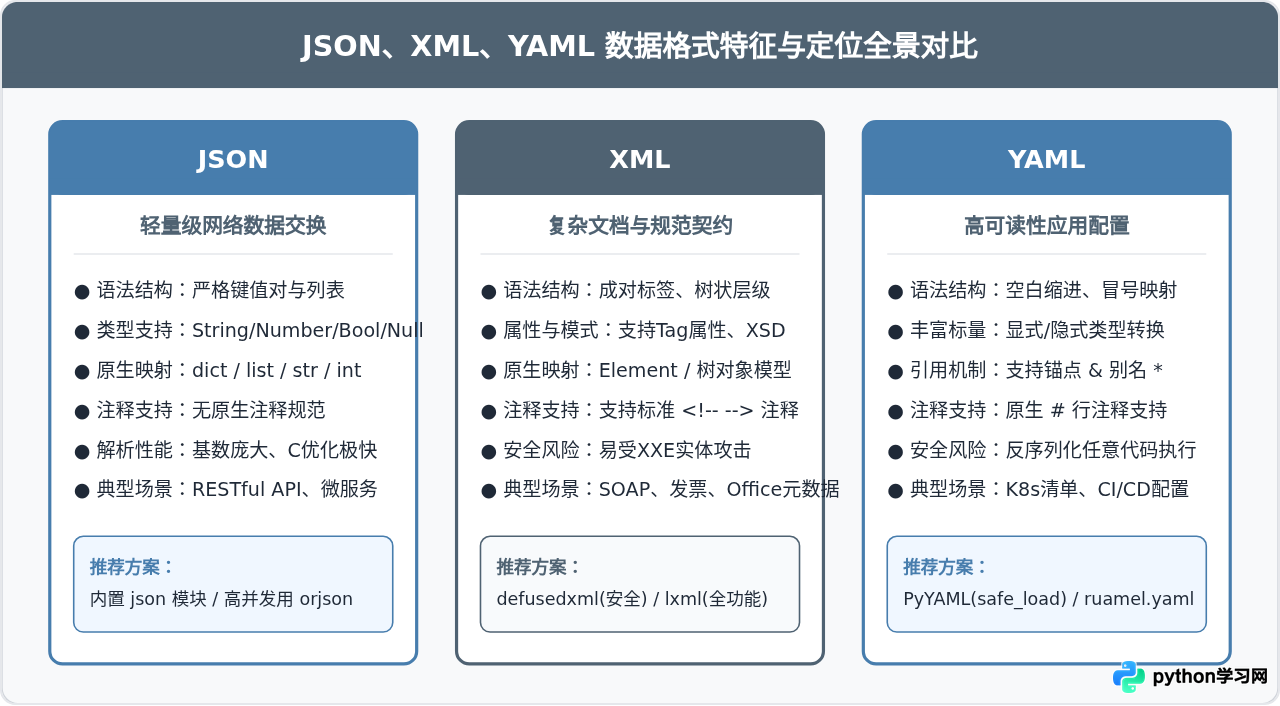
要选对处理库,首先需认清三种数据格式的底层定位与表达边界。JSON 是轻量级数据交换的标准协议,语法简练且原生对齐字典和列表;XML 依赖显式标签与属性树,具备严苛的 Schema 模式校验与命名空间机制;YAML 则面向人类可读性设计,凭借缩进层级与注释支持,成为当今配置文件的事实标准。
二、JSON 处理方案:内置模块与高性能替代品
在 Python 中,JSON 解析首选内置的 json 模块。该模块由 C 语言底层加速实现,无需安装任何外部依赖,完全覆盖日常大多数交互诉求。
1. 内置 json 模块的标准用法与高频参数
处理 JSON 数据时,需分清内存对象转换与文件流操作的区别:loads 与 dumps 负责字符串互转,而 load 与 dump 直接面向文件对象。在输出中文内容和排版配置时,必须合理设置 ensure_ascii 与 indent 参数。
import json

payload = {
    "service": "order-api",
    "port": 8080,
    "debug": False,
    "tags": ["电商", "高并发"]
}

# 序列化为格式化字符串:保留中文、缩进2格
json_text = json.dumps(payload, ensure_ascii=False, indent=2)

# 反序列化为 Python 原生字典
data = json.loads(json_text)
assert data["service"] == "order-api"json.dumps() 的 ensure_ascii=True,会将中文字符转义为类似 \u7535\u5546 的 Unicode 编码序列。在面向中文输出或持久化存储时,务必将 ensure_ascii 显式指定为 False。
2. 超高性能场景:选用 orjson
当服务每秒需要处理数万次 JSON 序列化(例如高频 Web API 网关、日志收集器)时,内置模块会成为 CPU 瓶颈。由 Rust 驱动的 orjson 是目前 Python 生态中最快的 JSON 库,其解析与序列化吞吐量通常是内置 json 的 3 到 8 倍。
import orjson
from datetime import datetime
from dataclasses import dataclass

@dataclass
class Event:
    event_id: str
    created_at: datetime

event = Event(event_id="EVT-1002", created_at=datetime.now())

# orjson 原生支持 dataclass、datetime 及 UUID,返回 bytes
serialized_bytes = orjson.dumps(event, option=orjson.OPT_NAIVE_UTC)
restored = orjson.loads(serialized_bytes)
三、XML 处理方案:树形解析、XPath 与安全底线
XML 拥有严格的层次规范与属性定义,常用于电子发票、金融报文(如 ISO 20022)以及企业级集成接口。在 Python 中,主要方案包括内置的 xml.etree.ElementTree、功能强大的 lxml,以及防御注入攻击的 defusedxml。
1. xml.etree.ElementTree 基础操作
ElementTree 采用树形节点模型,提供了轻便的 XPath 子集检索能力,适用于解析结构可控的常规 XML 文档。
import xml.etree.ElementTree as ET

xml_raw = """<configuration>
    <database name="master">
        <host>10.0.0.1</host>
        <port>3306</port>
    </database>
</configuration>"""

root = ET.fromstring(xml_raw)
db_node = root.find("database")
host = db_node.findtext("host")
port = int(db_node.findtext("port"))
db_name = db_node.get("name")

assert host == "10.0.0.1"
assert db_name == "master"
2. 安全底线:防范 XXE 注入与 defusedxml
/etc/passwd)或发起内网探测。此外,“十亿笑声”(Billion Laughs)实体嵌套攻击会导致指数级内存膨胀,瞬间耗尽服务器资源。
处理任何来自不可信源(外部请求、用户上传)的 XML 时,应将 xml.etree.ElementTree 替换为 defusedxml.ElementTree,其底层默认禁用了实体展开与外部 DTD 加载。
# 抵御 XXE 与 XML 炸弹的安全做法
import defusedxml.ElementTree as SafeET

try:
    # 遇到外部实体或非法 DTD 时直接抛出 EntitiesForbidden 异常
    safe_root = SafeET.fromstring(xml_raw)
except Exception as err:
    print(f"检测到潜在的 XML 实体威胁: {err}")
四、YAML 处理方案:PyYAML 避坑与 ruamel.yaml 格式保留
YAML 在配置领域应用极广,但其解析模型兼具动态特性,代码编写时稍有疏忽便可能引入致命漏洞。
1. PyYAML 的核心准则:杜绝使用危险的 load
早期 PyYAML 默认的 yaml.load(stream) 支持反序列化 Python 对象。如果读取的内容被篡改,攻击者可通过 !!python/object/apply:os.system 执行任意系统命令。因此在生产代码中,必须严格使用 yaml.safe_load()。
import yaml

yaml_content = """
app:
  name: order-worker
  concurrency: 8
  features:
    - payment
    - refund
"""

# 正确:仅允许解析标准 YAML 基础类型
config = yaml.safe_load(yaml_content)
assert config["app"]["concurrency"] == 8

# 导出为安全 YAML 文本
dumped = yaml.safe_dump(config, allow_unicode=True, sort_keys=False)
2. 保留注释与格式:选用 ruamel.yaml
标准 PyYAML 在读取并重新保存 YAML 文件时,会彻底丢失所有 # 注释行,并重排键值对顺序。若业务场景需要程序化修改运维配置文件并保留原有注释,必须采用 ruamel.yaml。
from ruamel.yaml import YAML

yaml_processor = YAML()
yaml_processor.preserve_quotes = True

# 原样读入,保留注释与缩进
config_data = yaml_processor.load("""
# 核心业务服务配置
server:
  host: 0.0.0.0 # 绑定所有网卡
  port: 8080
""")

# 动态修改参数
config_data["server"]["port"] = 9000

# 写出时注释完好如初
from io import StringIO
stream = StringIO()
yaml_processor.dump(config_data, stream)
五、通用处理流水线与数据流转步骤
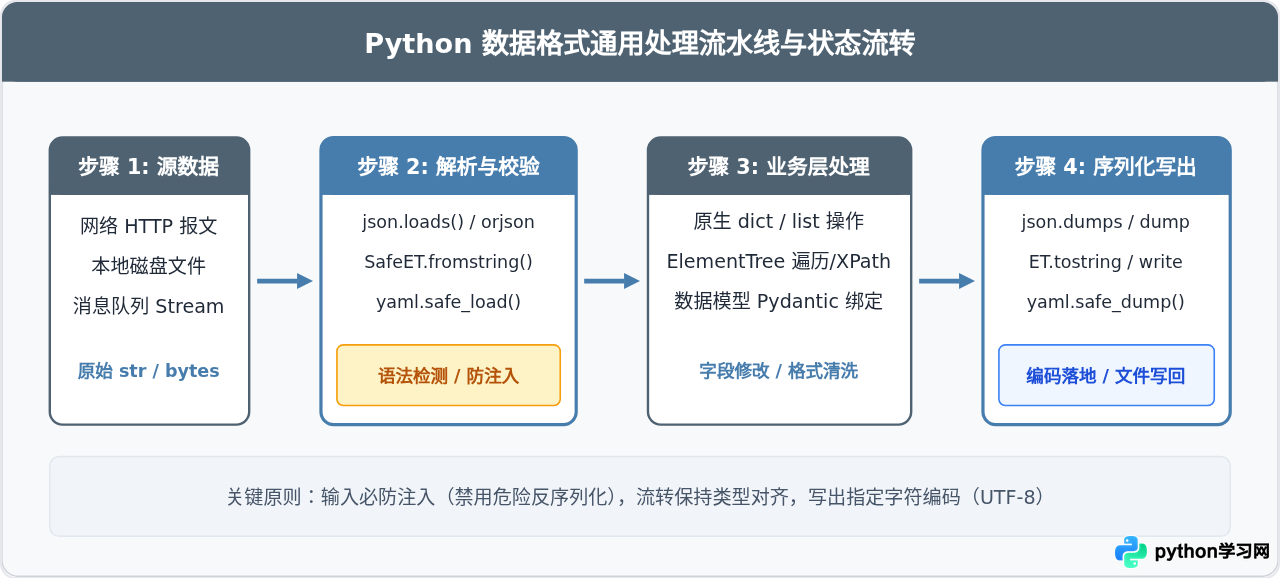
不论处理哪种数据格式,工程中的典型操作均遵循严密的五步流水线模型:数据源获取、反序列化与语法检查、内存对象操控、业务校验、序列化输出或落盘。
六、性能、安全性与容错矩阵
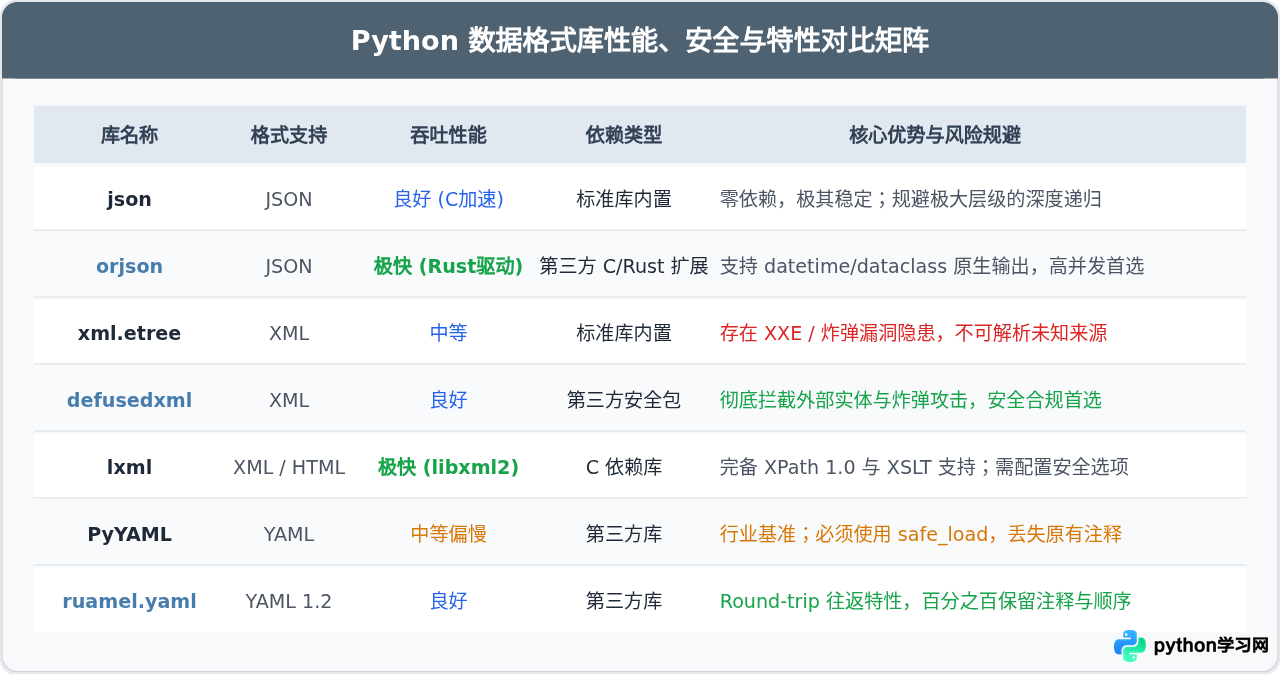
为了让不同方案的综合表现一目了然,下表与图示全面总结了各库在核心维度的具体差异:
七、场景化选型指南与决策路径
结合实际软件开发流程中的输入来源、读写频次及维护要求,建议按照以下决策树开展技术选型:
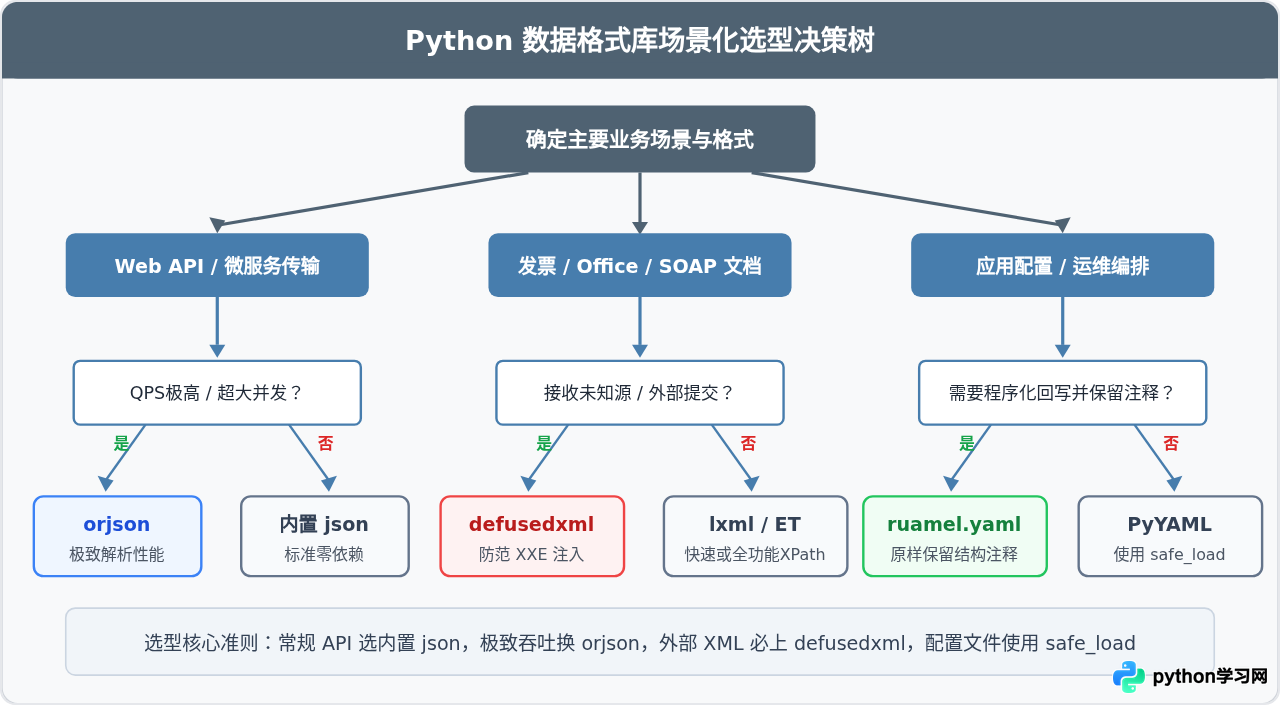
总结而言,数据格式的选型没有绝对的优劣,只有针对具体场景的取舍平衡。在标准 Web 交互中,优先采用内置 json 保持轻量与零维护成本,高并发瓶颈时平滑过渡至 orjson;涉及外部系统 XML 时必须把 defusedxml 作为防御底线;而在维护带有大量注释的工程配置文件时,ruamel.yaml 则是保证文档完整性的最佳解法。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















