


Python 3字符串内部结构:怎么存储不同语言的字符
深入解析 Python 3 字符串的内部结构与 PEP 393 灵活存储机制,详述 ASCII、中文、日韩文及 Emoji 等不同语言字符在底层内存中的分配与表示原理。
在 Python 3 中,无论字符串里包含的是纯 ASCII 英文、西里尔字母、中文汉字还是 Emoji 表情,对外暴露的都是统一的 str 对象,并且全部支持常数时间复杂度 O(1) 的字符按索引访问(例如 s[i])。但在解释器底层,Python 既没有使用极耗内存的固定 4 字节存储,也没有直接使用难以按索引切片的 UTF-8 变长编码;自 Python 3.3 起(PEP 393),CPython 解释器会根据当前字符串中“最大字符的 Unicode 码位”自适应选择 1 字节(Latin-1)、2 字节(UCS-2)或 4 字节(UCS-4)的紧凑定长数组。本文将详细解析这套灵活存储机制的内部结构、底层 C 结构体设计以及工程中的内存细节。
一、为什么 Python 不能直接在内存中使用 UTF-8 或 UTF-32?
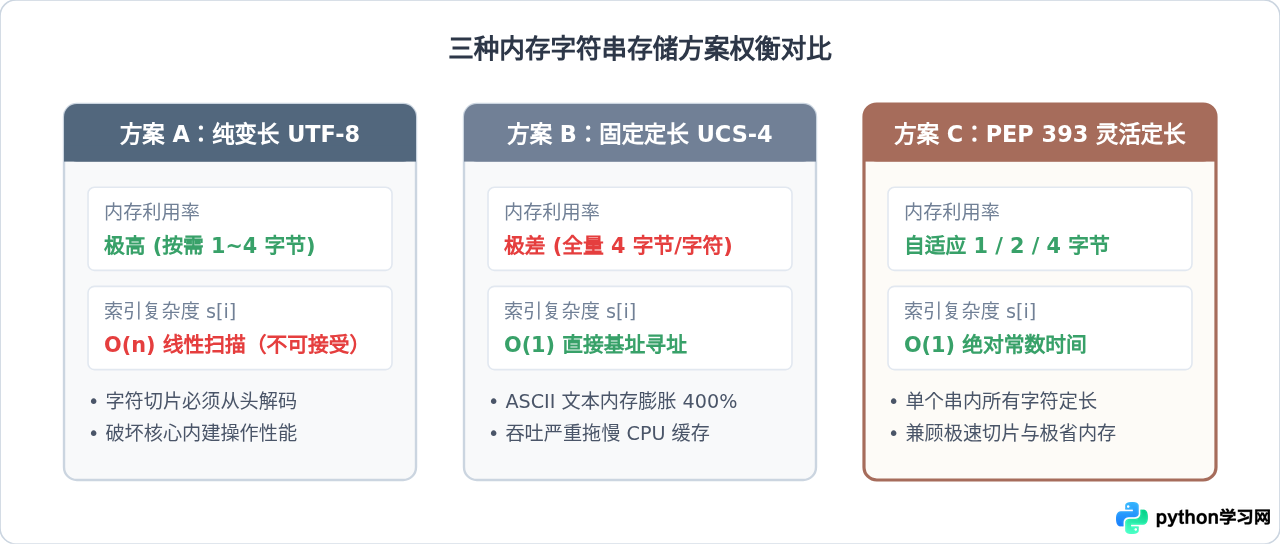
很多初学者容易将“网络传输及磁盘持久化格式”与“运行时内存数据结构”混淆。在磁盘或网络通信中,UTF-8 是事实上的通用标准,但在高级编程语言的内部运行时,直接使用变长编码会带来严峻的性能挑战:
- 变长编码(如 UTF-8)无法实现 O(1) 随机索引:在 UTF-8 中,ASCII 字符占 1 字节,阿拉伯文占 2 字节,常用汉字占 3 字节,Emoji 占 4 字节。如果要执行
s[100],解释器无法通过简单计算偏移量base + 100 * width命中目标,必须从第 0 个字节开始逐字节解码扫描,时间复杂度退化为O(n)。 - 全量定长 UCS-4(UTF-32)内存浪费严重:如果将所有字符统一固定为 4 字节,虽然保证了
O(1)索引,但对于只包含英文字符的代码标识符、HTTP 请求头和配置键,内存占用直接膨胀为原先的 4 倍,大幅降低 CPU 缓存命中率。 - Python 2 与 Python 3.2 以前的妥协之痛:在 Python 3.2 之前,解释器在编译时必须在“窄构建(UCS-2,每字符 2 字节)”和“宽构建(UCS-4,每字符 4 字节)”之间二选一。窄构建无法直接表示超出基本多语言平面(BMP)的 Emoji 或生僻字,需要使用代理对(Surrogate Pairs),导致
len('𝄢')令人困惑地返回 2;而宽构建则极度消耗内存。
二、PEP 393 的三种底层形态:根据最大字符码点自适应
PEP 393(Flexible String Representation)的核心思想是:在一个具体的字符串实例内部,所有字符保持相同宽度的定长存储以支持 O(1) 索引;但不同的字符串实例,根据其包含的“最大 Unicode 码点(Maximum Code Point)”,动态选用 1 字节、2 字节或 4 字节的底层数组。
Unicode 字符的标准编码范围为 U+0000 到 U+10FFFF。Python 解释器在创建字符串对象时,根据字符所属的最大区间划分出三种基础存储形态(统称为 Kind):
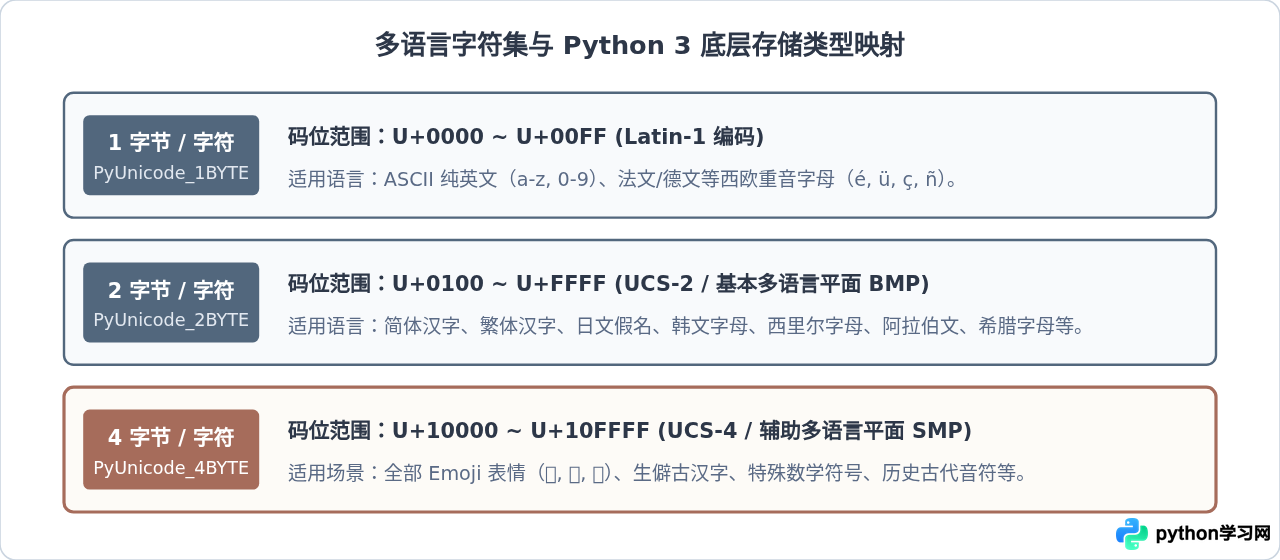
这意味着:
- 如果一个字符串全由英文或 Latin-1 字符组成(码位都在 255 以内),Python 每个字符只分配 1 字节;
- 如果混入了一个中文字符(例如
'中'的码位是U+4E2D,十进制 20013,处于 256 到 65535 之间),整串都会以 2 字节(UCS-2)存储; - 如果再追加一个 Emoji(例如
'🐍'的码位是U+1F40D,十进制 128013,超过 65535),整串的所有字符立即升级为 4 字节(UCS-4)存储。
三、底层 C 结构体剖析:PyASCIIObject 与紧凑分配
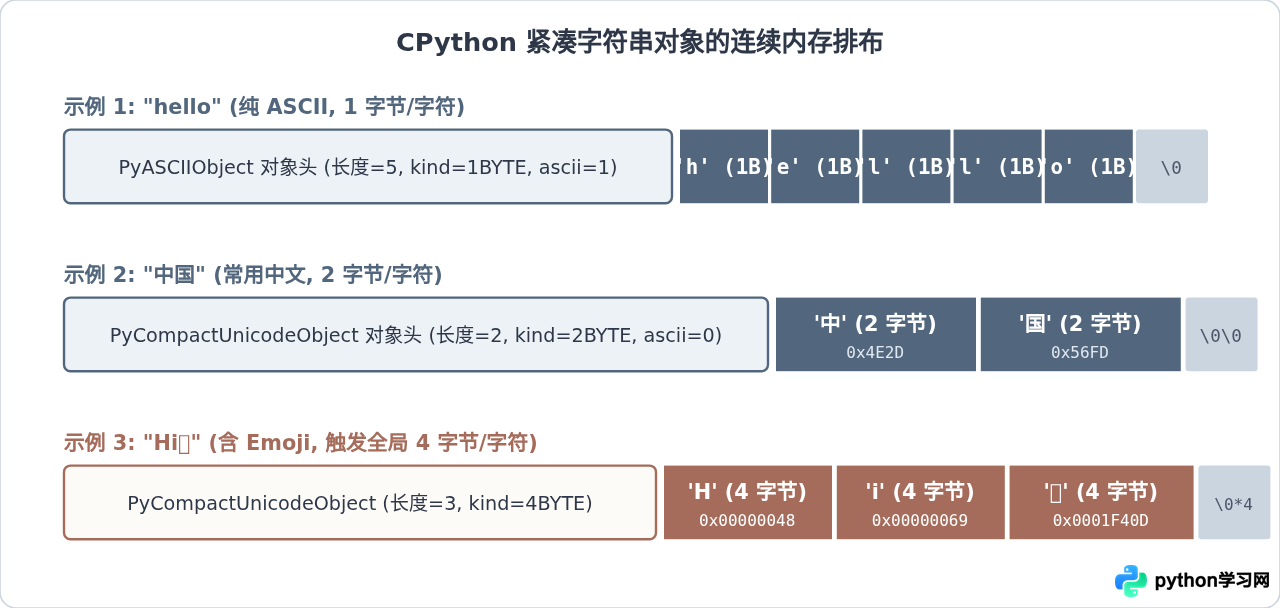
在 CPython 源码(Include/cpython/unicodeobject.h)中,字符串对象并不是单独分配一个结构体再通过外部指针挂载字符数组,而是尽可能采用紧凑单块内存(Compact Allocation),将对象头(Header)与字符数组一次性向操作系统申请。
1. 两个关键的底层结构体
- PyASCIIObject:纯 ASCII 字符串的最小开销结构体。它包含引用计数
ob_refcnt、类型指针ob_type、字符个数length、哈希值缓存hash以及紧凑状态位域state。在 64 位操作系统中,该头部占用 48 字节(若算上末尾的 C-style\0终止符,基础固定开销为 48 或 49 字节)。字符数组直接紧随结构体尾部。 - PyCompactUnicodeObject:当字符串包含非 ASCII 字符时使用。它继承了
PyASCIIObject,并增加了一个utf8缓存指针和utf8_length,用于缓存可能需要的 UTF-8 编码结果(头部开销约为 72 或 80 字节)。字符数据同样紧随其后。
2. 使用 Python 标准库实测验证内存变化
我们可以使用标准库的 sys.getsizeof() 直接验证上述结构体与字符数组的真实内存占用情况:
import sys

# 1. 纯 ASCII 字符串(1 字节/字符)
s_ascii = "hello"
print(f"ASCII 'hello': {sys.getsizeof(s_ascii)} 字节")
# 输出示例: 48 字节 header + 5 字节数据 + 1 字节 '\0' = 54 字节

# 2. 纯中文字符串(2 字节/字符)
s_chinese = "你好"
print(f"中文 '你好': {sys.getsizeof(s_chinese)} 字节")
# 输出示例: 72 字节 header + 2 * 2 字节数据 + 2 字节 '\0' = 78 字节

# 3. 混入 Emoji 的字符串(4 字节/字符)
s_mixed = "你好🐍"
print(f"混入 Emoji '你好🐍': {sys.getsizeof(s_mixed)} 字节")
# 输出示例: 72 字节 header + 3 * 4 字节数据 + 4 字节 '\0' = 88 字节
从输出中可以清晰观察到:当一个只有 2 个字符的中文串("你好",占用 78 字节)在末尾仅仅追加一个字符 '🐍' 变成 3 个字符时,其数据区不仅增加了新增字符的开销,原有的两个中文字符也全部由 2 字节扩展到了 4 字节,总数据区由 2 * 2 = 4 字节骤增为 3 * 4 = 12 字节。
四、字符串创建时的判定流程
当 Python 代码中出现字面量或者通过 str.join()、格式化拼接创建新字符串时,解释器内部遵循严格的推导与分配流程:
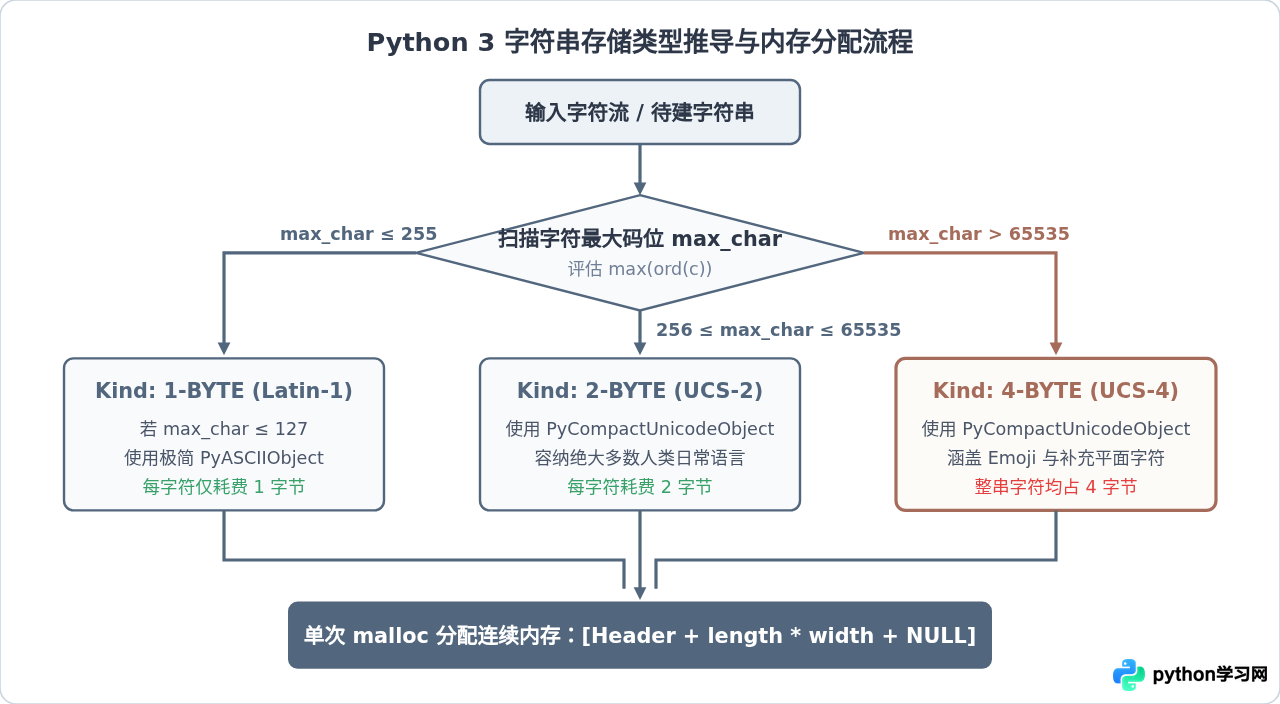
s = s + 'x')实际上都在创建全新的 str 对象,并在新对象生成时重新计算最大码位。
五、工程实践中的关键问题与优化建议
1. 大文本中的“Emoji 污染”效应
由于 PEP 393 的规则是“根据整串中的最大码位决定全局宽度”,这在处理海量纯英文或常用文本时可能会引发意料之外的内存膨胀:
假设你正在内存中缓存一篇包含 100 万字纯英文字符的文章(原本占用约 1 MB 内存)。如果不小心在文章末尾拼接了一个 Emoji 字符 "✨"(码点大于 65535),Python 会将整个字符串的所有 100 万个英文字符全部升级为 4 字节表示,该字符串占用的物理内存将瞬间跃升至约 4 MB。
防范方法:对大文本处理系统或日志存储模块,如果包含多语言或混合字符,建议按段落或逻辑块分别保存,避免长篇大段拼接为一个巨大字符串;或者在需要持久化和网络传输时及时序列化为 UTF-8 字节串(bytes)。
2. UTF-8 缓存机制的副作用
为了兼顾与底层 C 扩展、文件系统、网络套接字等外部系统的兼容性,Python 3 的字符串对象在被调用 s.encode('utf-8') 时,CPython 可能会在其内部的 utf8 指针上缓存生成的 UTF-8 字节序列。
这意味着:一个原本占用 2 字节/字符的中文长字符串,在第一次进行 UTF-8 编码之后,其所占用的总内存可能会额外增加一份 UTF-8 副本的字节大小。如果之后不再频繁编码,该内存在该字符串对象生命周期内将持续驻留。
六、总结与核心规格速查
Python 3 的字符串内部结构通过 PEP 393 实现了“逻辑统一、物理自适应”的精妙设计:
| 形态类型 (Kind) | Unicode 码位上限 | 单字符字节数 | 覆盖典型语言与字符 | 底层 C 结构体 |
|---|---|---|---|---|
| PyUnicode_1BYTE_KIND | U+0000 ~ U+00FF | 1 字节 | 纯 ASCII 英文、数字、Latin-1 西欧语言 | PyASCIIObject (若为纯 ASCII) |
| PyUnicode_2BYTE_KIND | U+0100 ~ U+FFFF | 2 字节 | 简繁中文、日文假名、韩文、西里尔、希腊等 BMP 字符 | PyCompactUnicodeObject |
| PyUnicode_4BYTE_KIND | U+10000 ~ U+10FFFF | 4 字节 | Emoji、生僻古汉字、特殊数学音符等 SMP 字符 | PyCompactUnicodeObject |
理解这一机制,不仅能帮助我们彻底弄清楚为什么 len() 在处理不同语言时表现一致且快速,更能指导我们在高吞吐数据处理、长文本缓存和微服务开发中做出合理的内存规划。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















