


Python模块与包有什么区别?从文件形态到导入机制的对比
深入解析Python模块与包的核心差异:从单文件与目录的文件形态,到sys.modules与查找器加载器的导入底层机制,再到相对导入的边界与工程最佳实践。
.py 脚本;包(Package)则是一种特殊的模块,本质上是包含子模块或子包的目录型命名空间。两者的本质分界线不在于能否被 import,而在于对象是否具备 __path__ 属性,以及导入系统在查找与加载阶段对文件路径和内部符号的绑定方式。
一、文件形态与逻辑结构对比
从物理磁盘形态来看,两者的区分最为直观。一个独立的 Python 源码文件就是一个模块;而一个包含多个模块的文件夹,在特定规则下即构成一个包。但若仅从“文件与文件夹”的角度去理解,就容易忽略 Python 在类型系统和属性绑定上的统一设计。
1. 单文件模块(Module)
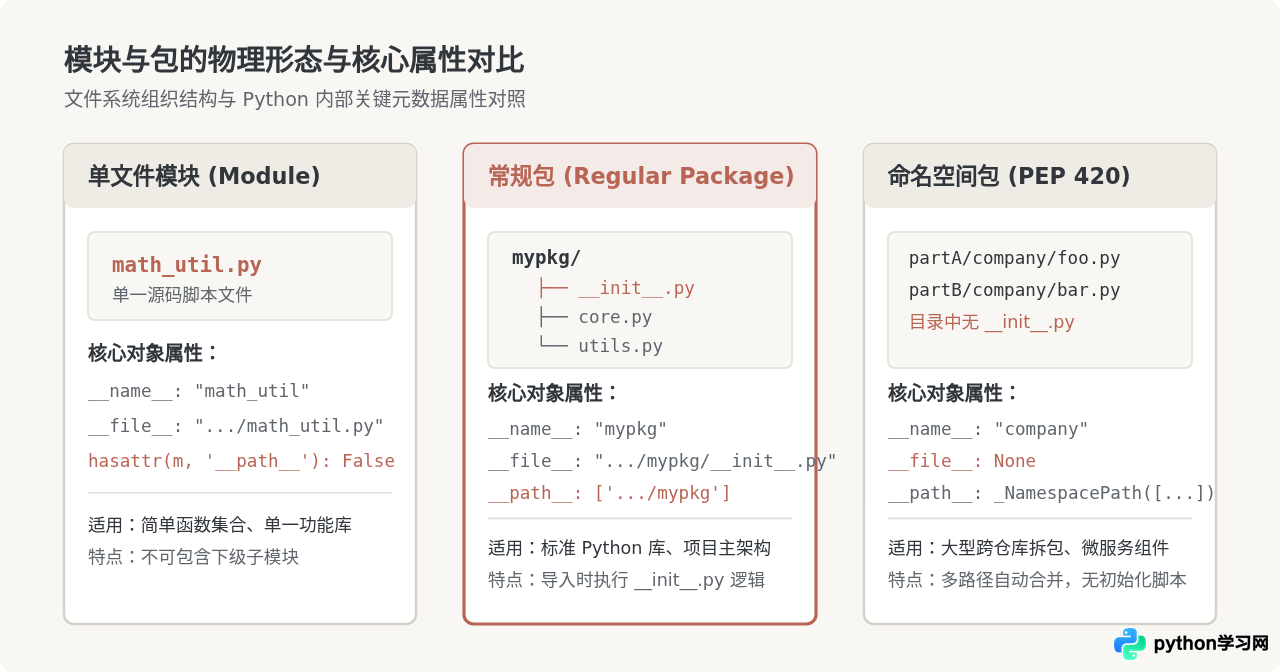
只要创建一个扩展名为 .py 的文件,例如 math_util.py,它就构成了一个标准的 Python 模块。无论该文件是通过 import math_util 引入,还是直接用命令行执行,Python 都会在内存中为其构建一个 module 类型的对象。
模块对象的特征是扁平的。它内部拥有独立的全局命名空间(对应模块全局变量 globals()),拥有 __name__ 和 __file__ 等内建属性,但不具备 __path__ 属性。这意味着模块无法直接作为父容器去容纳下级子模块。
2. 常规包(Regular Package)
常规包在磁盘上表现为一个包含 __init__.py 文件的目录。例如 mypkg/ 目录下存在 __init__.py、core.py 和 utils.py。
当执行 import mypkg 时,Python 实际上做的事情是:执行 mypkg/__init__.py 脚本,并将执行后产生的命名空间封装为一个 module 类型的对象。与普通模块不同的是,该对象会被自动赋予一个列表类型的 __path__ 属性,其初始值为该目录的物理绝对路径:
import mypkg

print(type(mypkg))               # <class 'module'>
print(hasattr(mypkg, '__path__')) # True
print(mypkg.__path__)            # ['/workspace/project/mypkg']
正是因为存在 __path__ 属性,后续执行 import mypkg.core 时,Python 才能以 mypkg.__path__ 为搜索基础,在对应的物理目录下精确定位子模块。
3. 命名空间包(Namespace Package,PEP 420)
自 Python 3.3 引入 PEP 420 之后,即使一个目录中没有任何 __init__.py,只要该目录位于 sys.path 中且包含可导入的 Python 文件,Python 也会将其识别为命名空间包。
命名空间包的特殊之处在于:它的 __file__ 为 None(因为它没有对应的主执行脚本),且其 __path__ 是一个动态的 _NamespacePath 可迭代对象。这允许将同一个逻辑包拆分存放在不同文件系统路径或不同软件仓库中,由导入系统在运行时自动聚合成单一命名空间。
二、Python 导入机制的底层执行流程
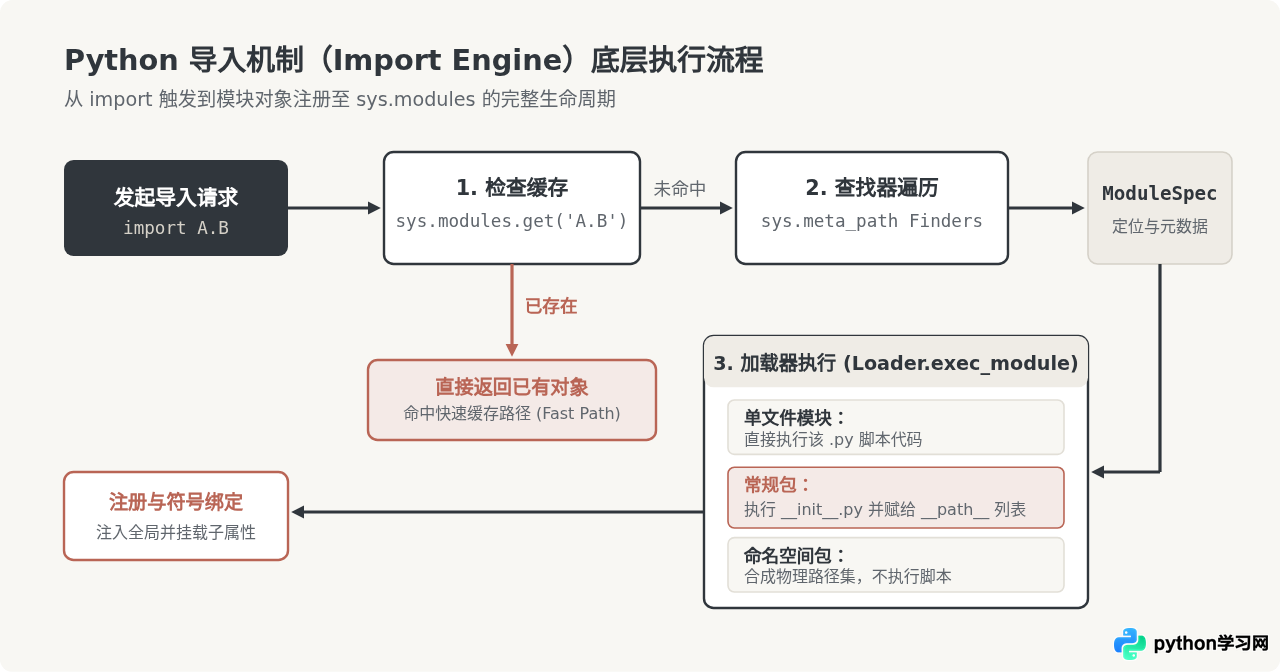
不管是执行 import math 还是 import package.module,Python 解释器背后都依赖一套高度结构化的导入系统。理解模块与包的底层差异,关键在于看清查找器(Finder)与加载器(Loader)在处理它们时的不同分工。
1. 导入的核心三阶段
-
缓存检查(sys.modules 查询):
Python 首先在内存字典sys.modules中根据完整模块名(例如"mypkg.core")进行匹配。如果已经存在该模块对象,则直接返回,避免重复执行代码。这是 Python 导入性能极高且支持单例模式的基础。 -
查找器定位(Finders 与 ModuleSpec 生成):
若缓存未命中,解释器依次遍历sys.meta_path中的查找器(如BuiltinImporter、FrozenImporter、PathFinder)。查找器的任务不是读取源码,而是在磁盘或环境路径中搜索定位,并返回一个包含元数据的ModuleSpec对象。 -
加载器执行(Loader 与命名空间构建):
根据spec.loader执行加载过程。首先通过spec.loader.create_module(spec)创建新的空模块对象,随后将其提前写入sys.modules(用于解决循环引用),最后调用spec.loader.exec_module(module)执行模块的顶层代码。
2. 模块与包在加载时的动作差异
当加载普通模块时,加载器只负责读取对应的 .py 脚本,在其内部命名空间中从头到尾顺序执行所有顶层语句。
当加载常规包时,流程具有复合性:
- 加载器必须先定位并执行该包根目录下的
__init__.py。 - 包对象会初始化其专属的
__path__列表。 - 如果用户写的是
import mypkg.core,解释器在完成mypkg的加载后,才会将mypkg.__path__作为子搜索路径,启动针对core的第二次查找与加载。 - 加载完成后,子模块
core对应的模块对象会被绑定为父包mypkg的一个属性,即mypkg.core。
三、导入语法与路径定位:绝对导入与显式相对导入
在实际编写代码时,开发者通常会在模块和包之间使用 import foo、from foo import bar 或 from . import baz。这里的核心分歧在于:解释器是以运行根目录为基准,还是以模块自身的层级位置为基准。
1. 绝对导入(Absolute Import)
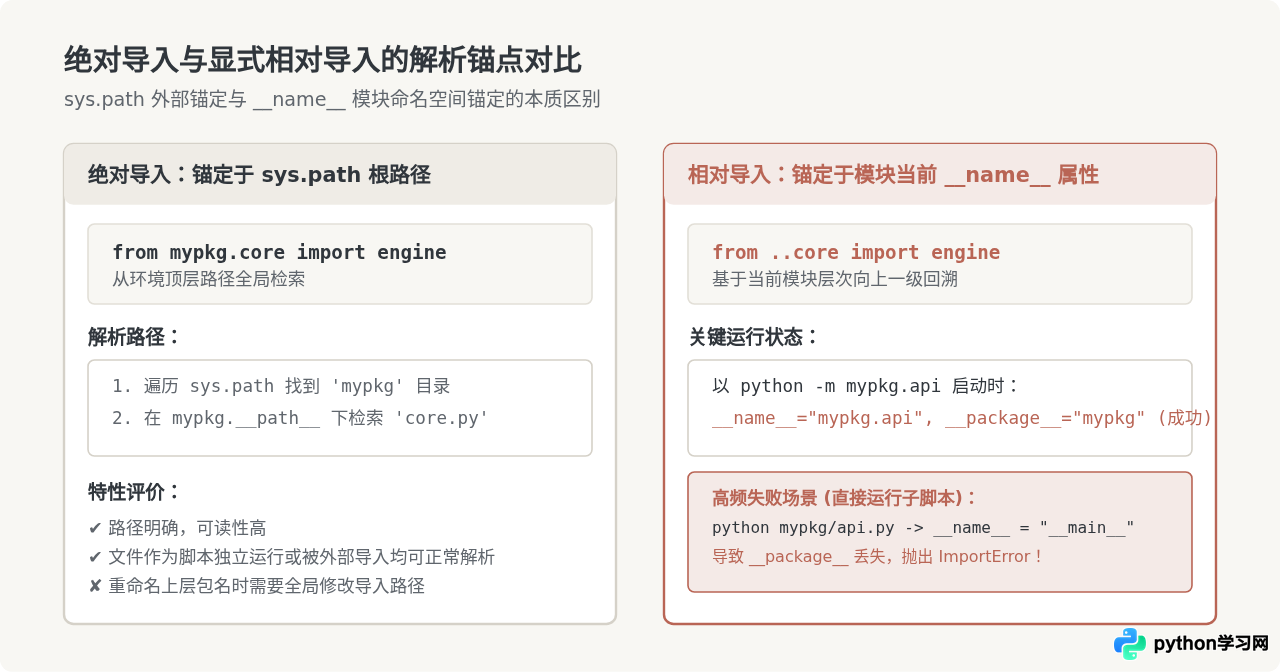
绝对导入始终从 sys.path 包含的顶层路径列表中由外向内逐级查找:
from mypkg.services.user import authenticate
优点:语义明确,代码无论位于项目深处还是浅处,只要 sys.path 包含项目根路径,导入语句的含义完全一致,极易被静态分析工具和重构工具理解。
2. 显式相对导入(Explicit Relative Import)
显式相对导入使用单个或多个句点 . 表示当前包或父级包:
from .models import UserModel          # 导入同级包内的模块
from ..config import DATABASE_URI # 导入上一级包内的模块__name__ 和 __package__ 属性!
如果当前模块的 __name__ 为 "mypkg.services.user",解释器通过截断末尾字段计算出其父包为 "mypkg.services",进而完成 .models 的定位。
高频报错剖析:很多开发者直接在终端中运行包含相对导入的子文件:
$ python mypkg/services/user.py
ImportError: attempted relative import with no known parent package
报错的原因非常清晰:当直接将文件作为主脚本运行时,Python 解释器强制将该模块的 __name__ 赋值为 "__main__",此时其 __package__ 被设为 None。由于失去了父包名称上下文,点号 . 无法定位任何包层级,从而引发错误。
标准做法:应始终从项目根目录以模块形式运行(例如 python -m mypkg.services.user),此时解释器会正确建立完整的包名空间。
四、工程实战中的常见陷阱与避坑指南
在实际工程中,模块演变为包的过程中最容易出现架构层面的问题。遵循以下原则能显著提高代码的可维护性与启动效率。
1. 警惕 __init__.py 中的“隐式副作用”与性能损耗
很多新手习惯在 __init__.py 中将包内所有子模块的类全部 import 进来,以图外部使用时省事:
# mypkg/__init__.py
from .heavy_ml_model import HeavyModel
from .database import DBClient
from .utils import fast_clean
这种做法的代价非常高昂。一旦调用方只是想要使用轻量的 fast_clean,执行 import mypkg 就会强制触发 heavy_ml_model 的加载,导致不必要的第三方重量级依赖(如 PyTorch、TensorFlow)被全量初始化,严重拖慢命令行工具或测试用例的启动时间。
建议:__init__.py 保持轻量,优先暴露核心 API;对于非核心或重量级组件,保持按需显式导入(如 from mypkg.heavy_ml_model import HeavyModel)。
2. 循环导入(Circular Import)的排查与解耦
当两个模块相互 import 对方时,如果发生在顶层代码中,极易因模块未执行完毕而报错:
# module_a.py
from module_b import func_b

def func_a():
    return 1

# module_b.py
from module_a import func_a

def func_b():
    return func_a() + 2
在加载 module_a 时,解释器读到第一行立刻暂停并转去加载 module_b;而 module_b 又在第一行试图从 module_a 中获取 func_a。由于 module_a 尚未执行到定义 func_a 的位置,直接抛出 ImportError: cannot import name 'func_a'。
解决方法:
- 重构公共依赖:将相互引用的公共数据结构或函数提取到第三个独立的基础模块中(如
common.py或types.py)。 - 函数内延迟导入:将
from module_b import func_b移至具体调用它的函数内部,推迟符号解析时机。
五、全维度对比总结与选型依据
为了在架构设计中做出合理决策,下表与图 4 总结了单文件模块、常规包与命名空间包的核心维度对比。
| 对比维度 | 单文件模块 (Module) | 常规包 (Regular Package) | 命名空间包 (PEP 420) |
|---|---|---|---|
| 物理形态 | 单个 .py 文件 |
包含 __init__.py 的目录 |
不含 __init__.py 的目录 |
| __path__ 属性 | 不存在该属性 | 存在,为物理目录列表 | 存在,为 _NamespacePath |
| __file__ 属性 | 指向该脚本文件 | 指向 __init__.py |
为 None |
| 导入时动作 | 顺序执行该文件顶层代码 | 顺序执行 __init__.py 代码 |
不执行任何初始化脚本 |
| 子模块支持 | 不支持 | 支持在目录下无限嵌套 | 支持跨目录分发合并 |
| 选型建议 | 功能单一、代码量在几百行以内的独立工具 | 拥有复杂业务逻辑、分层结构的标准软件库 | 大型企业微服务 SDK、跨仓库第三方插件机制 |
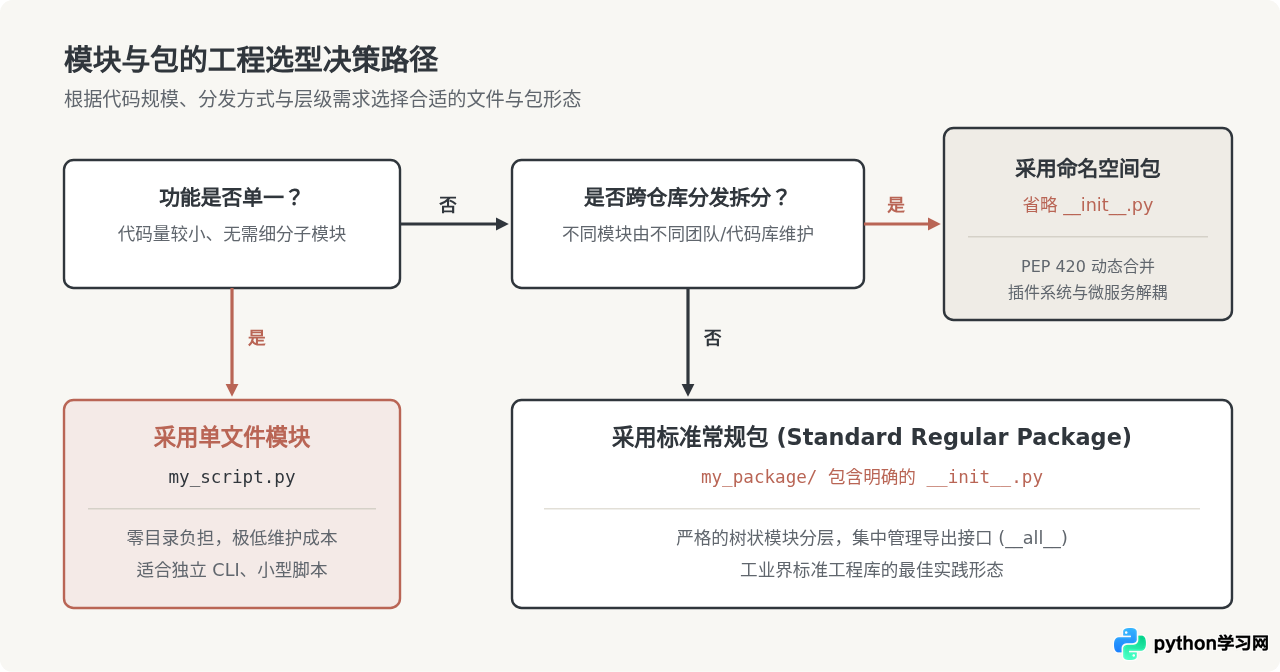
总结而言,模块是代码的直接载体,而包是模块的聚合容器。在日常开发中,当一个功能模块膨胀到需要拆分职责时,将其重构成目录并增加 __init__.py 是最自然的演进路径;深入理解两者的属性差异与导入机制,有助于在代码组织和工程架构中写出更加清晰、优雅且健壮的 Python 项目。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















