


Python变量命名规则:合法字符、关键字与长度限制
深入解析Python变量命名的硬性语法规则与工程实践,涵盖首字符限制、合法字符集、大小写敏感性、保留关键字冲突、内置名称遮蔽陷阱、解释器长度机制及PEP 8推荐规范。
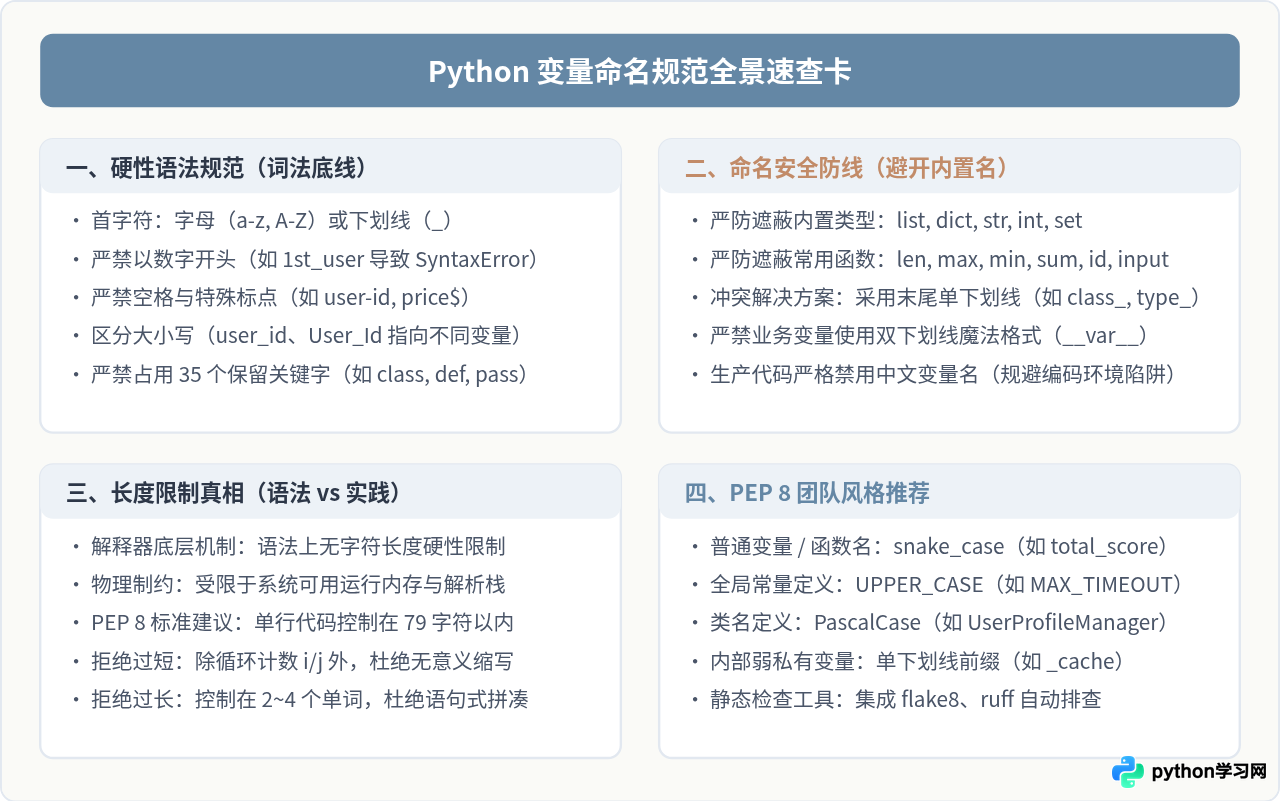
在 Python 中,变量名实际上是指向内存对象的“标识符(Identifier)”。给变量命名看似只是编码时的日常操作,但它直接受到 Python 词法解析器严格的语法约束,同时关系到代码的执行安全性与长期可维护性。一个合格的 Python 变量名,必须同时满足字符合法性、避开关键字与内建冲突以及遵循工程长度规范三个核心层面的要求。
一、合法字符集规范:首字符与后续字符约束
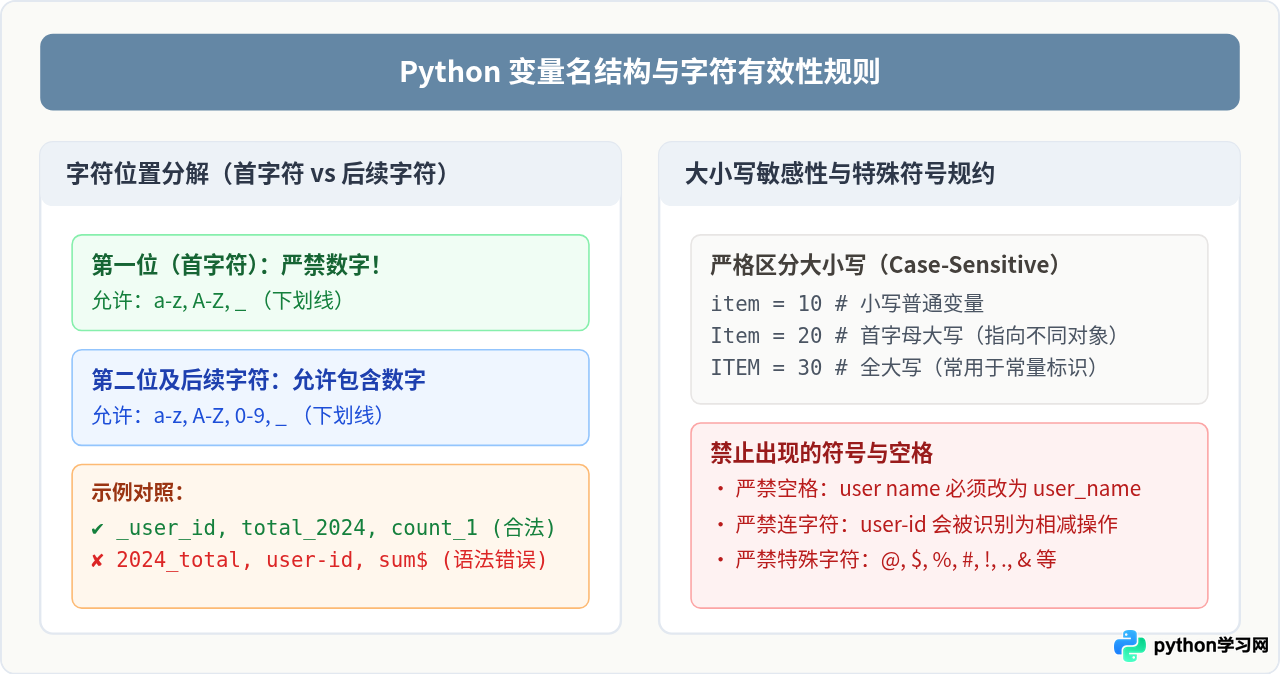
Python 解释器在对源代码进行词法分析(Tokenization)时,依靠明确的模式来区分数值字面量、运算符和标识符。因此,变量命名具有明确的字符位置限制:
- 首字符约束:必须是英文字母(小写
a-z或大写A-Z)或下划线(_),绝对不能以数字开头。若变量名以数字开头,词法分析器会在预读时将其识别为数值格式,从而直接抛出语法错误。 - 后续字符约束:可以包含字母、下划线以及数字(
0-9)。不能包含任何标点符号、运算符或空格(例如@、$、%、-、+、/等)。 - 严格区分大小写:Python 是强大小写敏感的语言。
total_count、Total_Count和TOTAL_COUNT会被解释器视为三个完全独立、指向不同内存地址的变量。 - Unicode 字符支持与工程禁忌:从 Python 3(PEP 3131)开始,解释器支持非 ASCII 的 Unicode 字符作为变量名(例如
总金额 = 100)。尽管这在语法上是合法的,但在实际工程与团队协作中被严格禁止,因为其极易导致跨系统编码异常、排版错乱和输入法切换带来的维护灾难。
二、变量名有效性校验流程与代码检测方法
在编写代码或接收动态配置时,若需要验证一个字符串是否能作为合法的 Python 变量名,可以依据解释器的校验逻辑分步判断。Python 官方提供了内置方法与标准库工具,能够准确完成这一验证。
1. 动态判定方法
Python 字符串内置了 isidentifier() 方法,结合标准库 keyword 模块,可以构建出完全吻合语法要求的检测逻辑:
import keyword

def validate_variable_name(name: str) -> tuple[bool, str]:
    if not isinstance(name, str) or not name:
        return False, "变量名必须是非空字符串"

    # 步骤1:检查字符是否符合标识符规则(首字符及后续字符)
    if not name.isidentifier():
        return False, f"'{name}' 包含非法字符或以数字开头"

    # 步骤2:检查是否为 Python 保留关键字
    if keyword.iskeyword(name):
        return False, f"'{name}' 是 Python 保留关键字,不可用作变量名"

    # 步骤3:检查是否遮蔽内置对象(属于警告级别)
    if name in dir(__builtins__):
        return True, f"'{name}' 语法合法,但遮蔽了内置对象(建议重命名)"

    return True, f"'{name}' 是完全合法的变量名"

# 示例验证
print(validate_variable_name("user_age"))   # (True, "'user_age' 是完全合法的变量名")
print(validate_variable_name("2nd_value")) # (False, "'2nd_value' 包含非法字符或以数字开头")
print(validate_variable_name("class"))     # (False, "'class' 是 Python 保留关键字,不可用作变量名")
print(validate_variable_name("list"))      # (True, "'list' 语法合法,但遮蔽了内置对象(建议重命名)")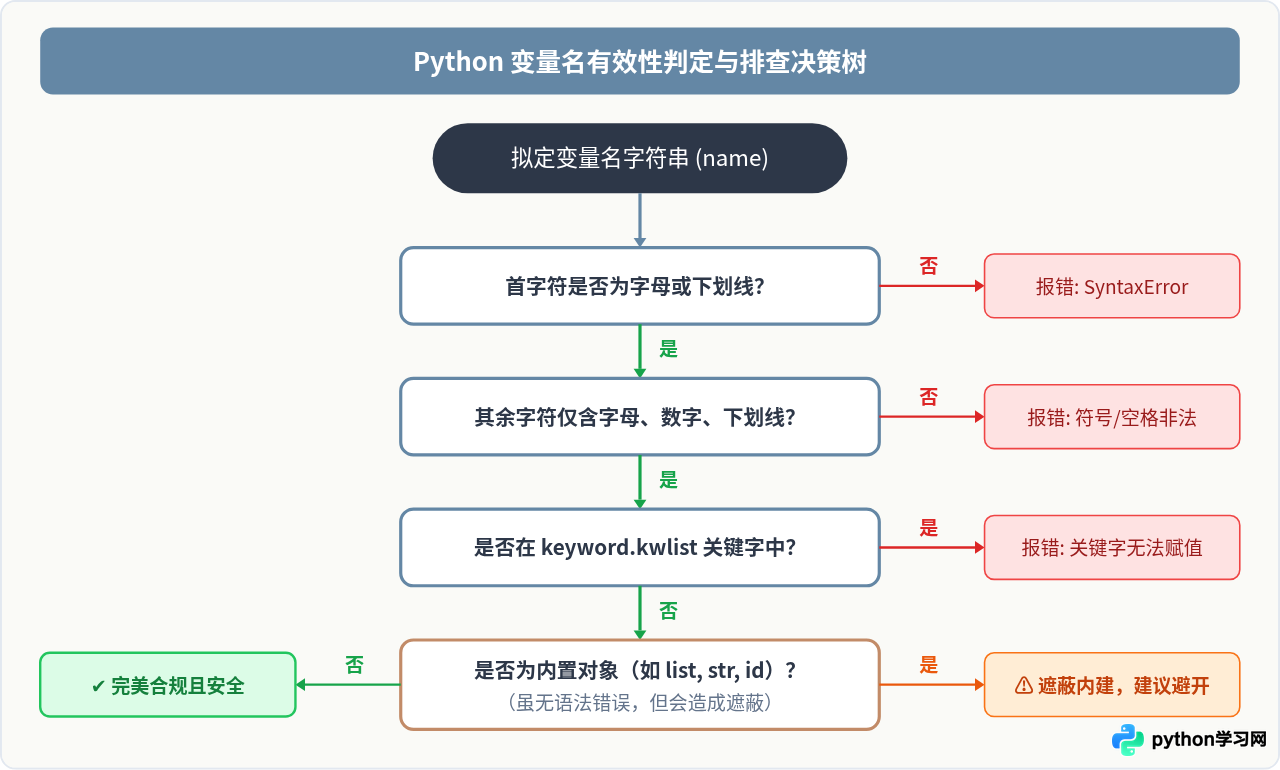
三、关键字与内置标识符:硬错误 vs 隐式遮蔽
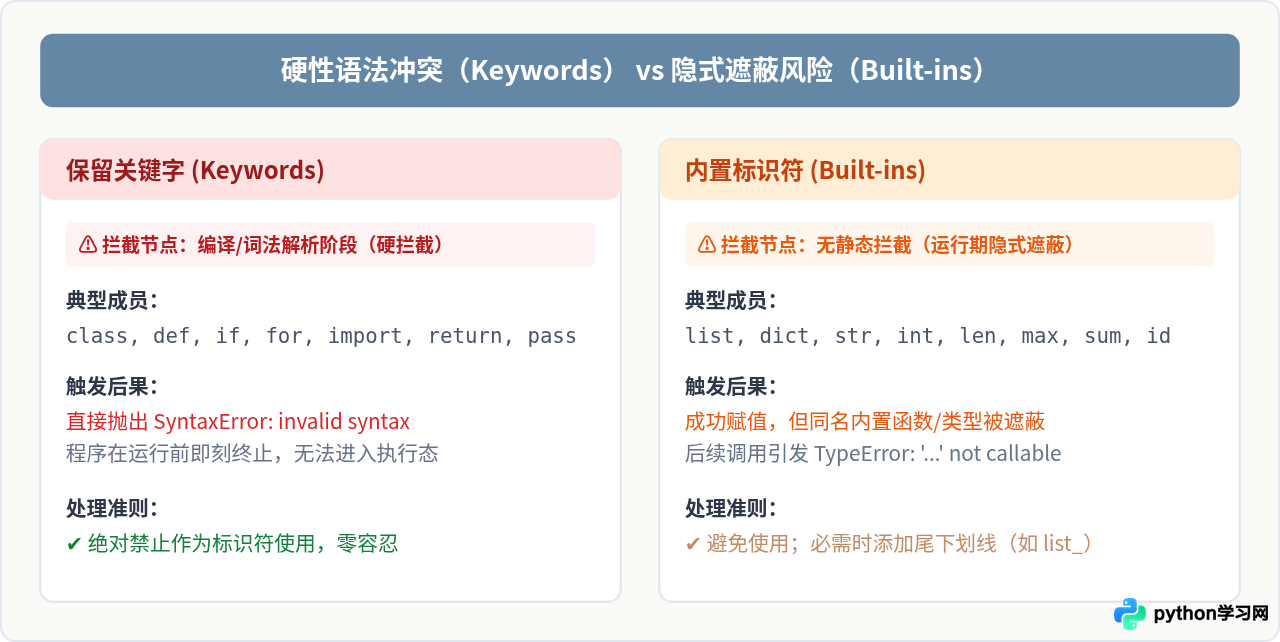
很多初学者容易将保留关键字(Keywords)与内置名称(Built-in Names)混为一谈。在 Python 中,这两者的违规后果存在根本区别:前者是编译器直接拦截的硬性语法错误,后者则是能正常执行但会破坏运行环境的隐蔽陷阱。
1. 保留关键字(Keywords):语法硬拦截
关键字是 Python 语言核心语法的构建基石(如控制流、定义结构、异常处理等)。当前主流 Python 版本中包含 35 个保留关键字:
False, None, True, and, as, assert, async, await, break, class, continue, def, del, elif, else, except, finally, for, from, global, if, import, in, is, lambda, nonlocal, not, or, pass, raise, return, try, while, with, yield
如果尝试为关键字赋值,解释器会在解析阶段直接中断并报出 SyntaxError:
# 错误示例
class = "三年级二班"  # SyntaxError: invalid syntax
pass = "123456"       # SyntaxError: invalid syntax
def = 100             # SyntaxError: invalid syntax
2. 内置标识符(Built-ins):隐式遮蔽风险(Name Shadowing)
内置名称包括常见的数据类型构造器(list, dict, str, int, set, tuple)和常用函数(len, max, min, sum, id, type, input, open 等)。
由于它们位于 Python 作用域解析规则(LEGB 模型:Local → Enclosing → Global → Built-in)的最后一环,在当前作用域中给同名变量赋值并不会抛出语法错误,但会将内置对象完全“遮蔽”,导致后续正常的函数调用崩溃:
# 陷阱演示:覆盖内置类型 list
list = [10, 20, 30]  # 赋值成功,当前命名空间中的 list 已变为一个列表对象

# 后续代码期望将字符串转为字符列表
letters = list("hello")
# 抛出异常: TypeError: 'list' object is not callable
# 原因:此处的 list 已不再指向内置的 list() 构造器,而是指向了上面赋值的 [10, 20, 30]工程避坑建议:若业务变量确有“类型”、“分类”等含义,为了避免与 class、type、list 等冲突,PEP 8 推荐在变量末尾添加单个下划线,例如 class_ = "VIP"、type_ = "order"、list_ = [1, 2, 3]。
四、长度限制的真相:解释器内核 vs 工程实践
关于 Python 变量名最多能写多长,很多初学者常常误以为存在诸如 31、64 或 255 个字符的硬性上限。事实并非如此:
1. 解释器规格层面:理论上无字符上限
在 Python 语言规范以及官方 CPython 解释器实现中,标识符没有固定长度上限。词法分析器读取源代码中的标识符时,会将其作为一个连续字符序列读取进动态分配的内存缓冲区。只要计算机物理内存和解析堆栈尚未耗尽,即便是一个包含 1000 甚至 10000 个字符的变量名,解释器都能正常解析并绑定对象:
# 语法上完全允许:长度为 200 个字符的变量名
a_very_long_variable_name_created_for_testing_length_limits_in_python_interpreter_which_contains_lots_of_words_and_keeps_going_on_and_on_without_triggering_any_syntax_errors_because_python_has_no_hard_limit = 42

print(a_very_long_variable_name_created_for_testing_length_limits_in_python_interpreter_which_contains_lots_of_words_and_keeps_going_on_and_on_without_triggering_any_syntax_errors_because_python_has_no_hard_limit)
# 输出: 42
2. 工程实践层面:PEP 8 行宽与可读性约束
虽然语法不作硬性限制,但在现实工程中,变量名长度受到严苛的可读性与团队规范约束:
- PEP 8 代码行宽约束:PEP 8 官方指南强烈建议每行代码不超过 79 个字符。过长的变量名在嵌套表达式、函数传参或推导式中会导致代码剧烈膨胀,迫使开发者频繁拆行,严重破坏代码结构。
- 信息密度的适度原则:
- 过短的反模式:除局部临时循环计数器(如
for i in range(10)、for x, y in points)之外,滥用a,b,temp,data等无业务语义的缩写,会导致后续维护者完全无法脱离上下文理解代码。 - 过长的反模式:类似
user_information_dictionary_loaded_from_remote_mysql_database_instance的命名冗余度过高,带来沉重的视觉噪音。推荐精炼为remote_user_info或user_data。
- 过短的反模式:除局部临时循环计数器(如
五、下划线命名惯例与 PEP 8 风格指南
在 Python 生态中,下划线 _ 扮演着十分特殊的语义角色,不同位置与数量的下划线代表了不同的约定:
| 命名形式 | 典型命名示例 | 语义与适用场景 |
|---|---|---|
| 普通蛇形命名 (snake_case) | user_age, max_retry_count |
普通局部变量、全局变量和函数名的 PEP 8 标准风格。单词全部小写,用下划线分隔。 |
单前导下划线 (_var) |
_internal_cache |
弱私有标志。提示该变量仅供内部使用;在 from module import * 时默认不会被导入。 |
单末尾下划线 (var_) |
class_, type_, id_ |
避开保留字。用于避免与 Python 关键字或内置函数命名产生命名冲突。 |
双前导下划线 (__var) |
__private_token |
类私有属性(名称修饰/Name Mangling)。解释器会自动重命名为 _ClassName__var,防止子类意外覆写。 |
双前后下划线 (__init__) |
__name__, __doc__ |
特殊魔法属性/方法(Dunder)。由系统内部保留使用,开发者切勿自行发明此类命名的变量。 |
单独立下划线 (_) |
for _ in range(5): |
占位符。表示该变量的值在后续逻辑中不会被使用(惯用抛弃变量)。 |
六、常见反模式自查清单
在日常开发与代码审查中,可以对照以下清单进行快速自查:
- 以数字或连字符开头:如
2nd_user、-data。应当修改为user_2nd、data_negative。 - 使用容易引起混淆的单字符:极度不推荐单独使用小写字母
l(容易与数字1混淆)、大写字母O(容易与数字0混淆)或大写字母I。 - 将内置函数名用作临时计数或容器:如
sum = 0、max = 100。一旦执行,后续代码调用sum([1, 2, 3])时将直接发生崩溃。应当修改为total_sum = 0、max_limit = 100。 - 无意义的单字母拼凑:如
a1,a2,temp1,temp2。应当根据业务语义明确命名为raw_response,parsed_data等。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















