


Python普通注释与文档字符串(docstring)有什么区别
深入对比Python普通注释(#)与文档字符串(docstring)的核心区别,涵盖底层编译机制、语法编写规范、运行时驻留机制、易混淆认知误区以及工程实践中的选择依据。
#)标记,主要面向代码的实现者和维护者,用于解释某行或某个局部算法“为什么这样写”,在代码被编译为字节码时会被解释器直接彻底丢弃;而文档字符串(docstring)则是放置在模块、类、函数或方法最开头的字符串字面量(通常使用三引号 """),它会被解释器作为语法节点解析并挂载到对象的 __doc__ 属性上,在运行时常驻内存,供内置的 help() 函数、IDE 悬浮提示以及自动化文档生成工具查询与调用。
一、核心机制差异:编译期丢弃与运行时驻留
要真正理解两者的区别,首先需要观察 Python 解释器在编译和执行代码时是如何对待它们的。Python 在将源码(.py 文件)编译为字节码(Bytecode)的过程中,词法分析器遇到 # 号时,会直接将该行后续的字符全部忽略。这意味着普通注释完全不会进入抽象语法树(AST),编译生成的 .pyc 文件或内存代码对象中不包含任何普通注释内容。
与此相反,文档字符串在语法层面是一个合法的表达式语句(Expression Statement)。当 Python 编译器发现某个模块、类或函数的首个有效语句是一个字符串字面量时,它会把这个字符串存入该代码对象的常量表(co_consts)中,并显式绑定到该对象的 __doc__ 属性上。因此,文档字符串在程序运行期间是真实存在的内存数据。
def calculate_discount(price: float, discount_rate: float) -> float:
    """根据基础价格与折扣率计算折后价格。

    参数:
        price: 原价,需大于等于0
        discount_rate: 折扣比率,取值范围在 0.0 到 1.0 之间
    """
    # 业务校验:如果折扣率超出范围,做兜底限制,防止计算出负数
    if not (0.0 <= discount_rate <= 1.0):
        discount_rate = 1.0

    return price * discount_rate
通过交互式终端或反射机制,可以清晰看到两者的存留情况:
# 1. 查询函数的 __doc__ 属性
print(calculate_discount.__doc__)
# 输出:
# 根据基础价格与折扣率计算折后价格。
#
# 参数:
#     price: 原价,需大于等于0
#     discount_rate: 折扣比率,取值范围在 0.0 到 1.0 之间

# 2. 使用 help() 函数查看
help(calculate_discount)

# 3. 尝试在代码对象中寻找“业务校验”这一行普通注释
# 结果:无论是 __doc__、__code__.co_names 还是任何运行期属性,均无该注释的任何痕迹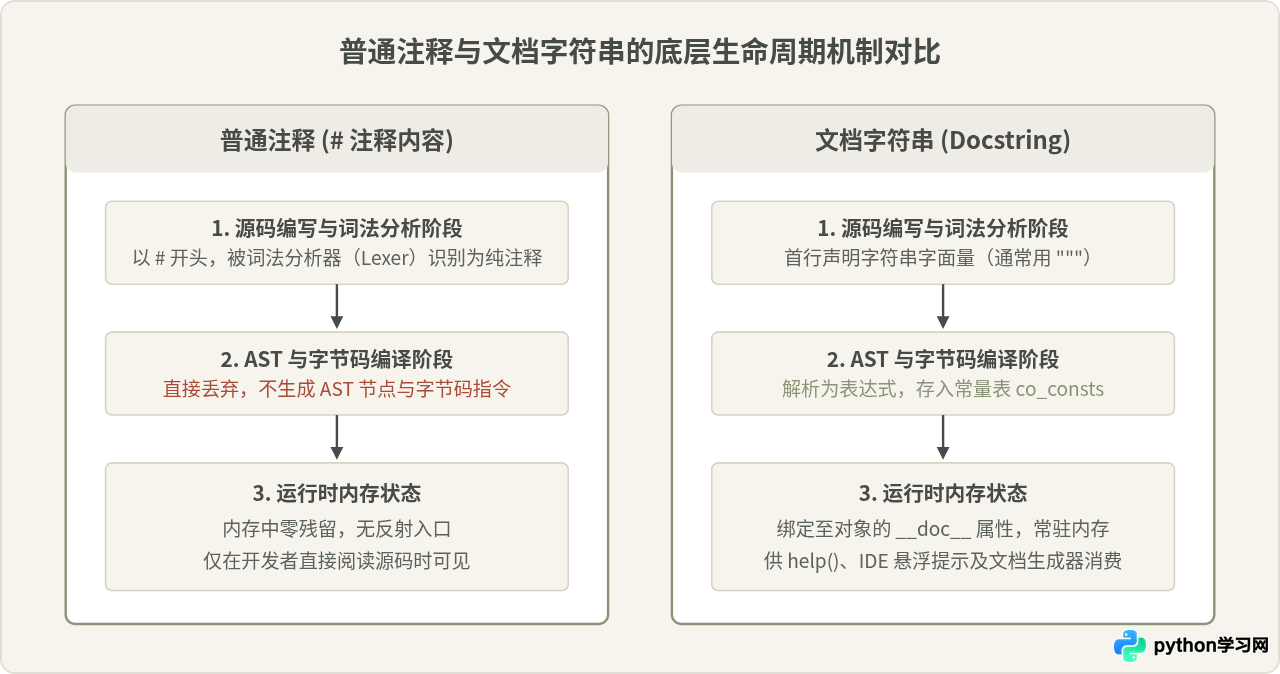
二、语法形式与编写位置规范
除了运行期机制不同,两者的语法规则和允许出现的位置也大不相同:
1. 普通注释的编写规范(PEP 8)
- 行首或块注释:独占一行或多行,紧挨被解释的代码上方。以
#开头,后跟一个空格。 - 行内注释(Inline Comment):位于可执行代码同一行的末尾。PEP 8 规定行内注释距离代码至少有两个空格,
#后保留一个空格。例如:x = x + 1 # 边界计数器自增。 - 使用限制:普通注释不能成为表达式或语法树节点,不能被赋值,也不能作为对象的属性。
2. 文档字符串的编写规范(PEP 257)
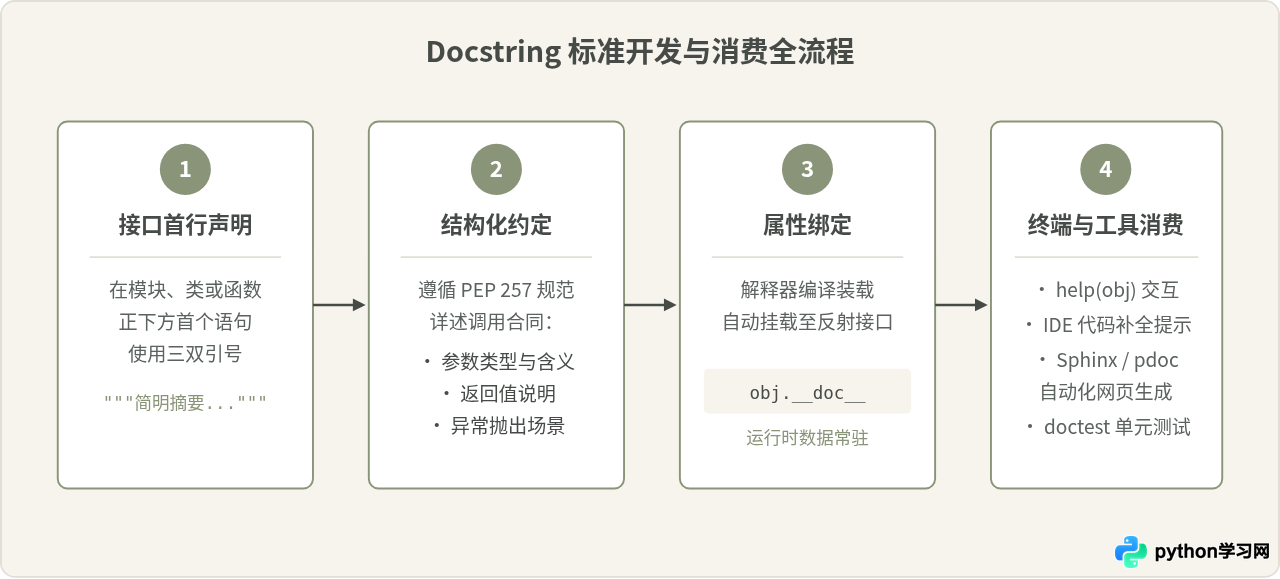
- 严格的声明位置:必须紧跟在
def(函数/方法)、class(类)或者.py模块的最顶端,作为其第一条可执行语句。如果该位置前面出现了任何赋值、打印或其他代码语句,该字符串将不再被解释器视作 docstring。 - 字面量格式:虽然单引号
'...'或双引号"..."也可以充当单行 docstring,但 PEP 257 强烈建议统一使用三双引号"""...""",即使只有单行也应如此。三引号不仅支持天然跨行,还能避免文档内部双引号转义的问题。 - 结构化风格:成熟项目通常遵循主流规范(如 Google 风格、NumPy 风格或 Sphinx/reST 风格),明确列出
Args、Returns、Raises等小节,便于工程维护和工具解析。
三、常见认知误区与辨析
在日常开发讨论中,常有一些看似合理但不够准确的说法,需要结合实际机制进行辨析:
分析与修正:这种说法在语法逻辑上是不准确的。在 Python 语法规范中,唯一的官方注释符号是井号(#)。三引号(''' 或 """)只是多行字符串的字面量表示法。
如果三引号字符串出现在函数或类的首行,它是文档字符串(docstring),会被编译器存入 __doc__;如果它出现在代码中间且没有赋值给任何变量,虽然它在运行期不产生任何实际副作用(作为一个无赋值的孤立表达式语句,通常在编译优化时被忽略),但它本质上仍然是一段被丢弃的字符串常量表达式,而不是语言层面的“注释机制”。
分析与修正:两者服务的目标群体不同。Docstring 是“对外声明的合同”,面向的是函数或模块的调用者,重点阐述“这个对象有什么用、需要什么输入、会返回什么”,使用者无需关注具体实现;而普通注释是“对内记录的备忘”,面向的是日后阅读或修改该函数实现细节的维护者。
当内部算法存在特殊边界条件、由于历史兼容性而采取的特殊逻辑、或者针对性能瓶颈做出的非直观优化时,必须使用普通注释在关键代码行旁做出解释,否则维护人员很难了解代码这样编写的深层原因。
分析与修正:在绝大多数实际工程中,Docstring 带来的内存开销完全可以忽略不计。每个 docstring 仅仅是在模块加载时作为一个字符串对象存在于常量表中,占用几百字节的内存。
如果是在资源极度受限的嵌入式 Python(如 MicroPython)或对内存有极端要求的特殊场景下,Python 解释器本身就提供了官方优化参数:在启动 Python 时附加 -OO 参数(即 python -OO script.py),解释器在编译字节码时会自动彻底剥离所有文档字符串(将 __doc__ 置为 None)。因此,在平时的源代码中完整编写 docstring 并不会成为不可逆的性能负担。
四、实际开发中的选择依据与决策路径
在实际编写代码时,开发者应如何快速判断当前内容该用普通注释还是 docstring?可以参考以下决策依据:
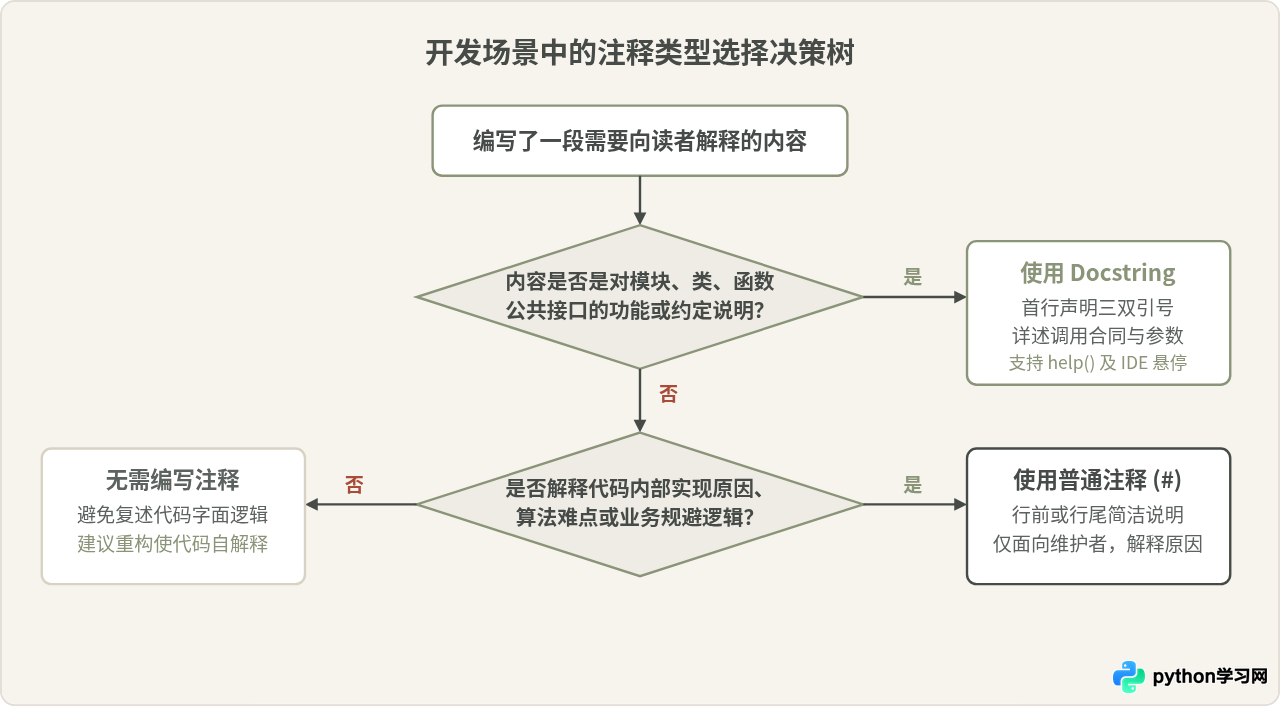
1. 必须使用 Docstring 的典型场景
- 公共 API 与导出模块:任何供团队其他成员、第三方用户引用的函数、类及模块,都必须具备清晰的 docstring,以便调用者直接使用
help()或在编辑器中查看用法。 - 自动化文档构建系统:项目中若引入 Sphinx、pdoc 或 MkDocs 等工具自动生成 HTML 接口文档,工具读取的核心数据源就是代码中的 docstring。
- 内置轻量级测试(doctest):docstring 中可以嵌入交互式会话示例,运行
python -m doctest script.py可以直接将 docstring 中的示例当作自动化单元测试执行,既能作为范例也能防范回归。
2. 应当使用普通注释(#)的典型场景
- 解释“为什么”而非“做什么”:代码本身已经表达了“做了什么”,注释应当交代代码无法直观呈现的业务背景或技术限制。例如:
# 使用二分查找而非字典,是为了在受限内存环境中避免哈希表的额外内存分配。 - 临时规避(Workaround)与已知缺陷警告:标注针对特定底层库 Bug 或特殊操作系统的兼容性处理,并附带相关 Issue 链接。
- 标记代办事项:使用规范的
# TODO: ...或# FIXME: ...标记待重构或待优化的局部片段。
五、核心特征横向总结
为了便于查阅与记忆,下表及图示从语法形式、存在位置、运行时状态、服务对象及配套工具链等五个核心维度对两者进行了综合归纳:
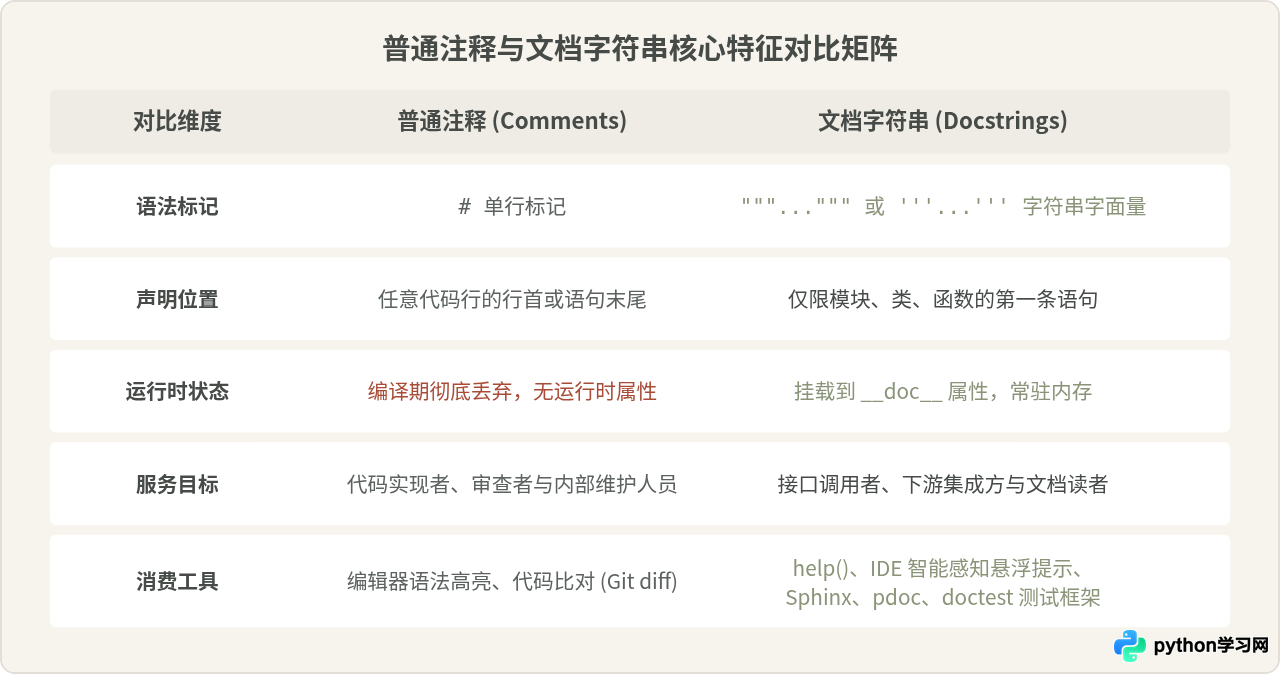
总结而言,在日常 Python 开发中,区分这两种机制的核心准则是:“面向接口与使用者用 docstring,面向实现与维护者用普通注释”。合理搭配使用这两种工具,既能确保公共接口自解释且易于调用,又能让复杂的内部实现清晰透明、易于维护。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















