


Python脚本需要编译吗?解释型语言执行原理解析
深入解析Python脚本的执行原理,解答Python是否需要编译的核心疑问,详解CPython从源码、抽象语法树(AST)、字节码到Python虚拟机(PVM)的完整执行流程及.pyc缓存机制。
很多初学 Python 的开发者常有一种直观印象:C 或 Go 语言需要经过编译生成二进制可执行文件后才能运行,而 Python 只需要在终端敲下 python main.py 就能立刻启动,因此 Python 是“纯解释执行、完全不需要编译”的。然而这种理解并不准确。简明扼要的答案是:Python 脚本确实需要编译,但它的编译是隐式且自动完成的,它编译的目标不是底层 CPU 的机器指令,而是由 Python 虚拟机专用的“字节码(Bytecode)”。
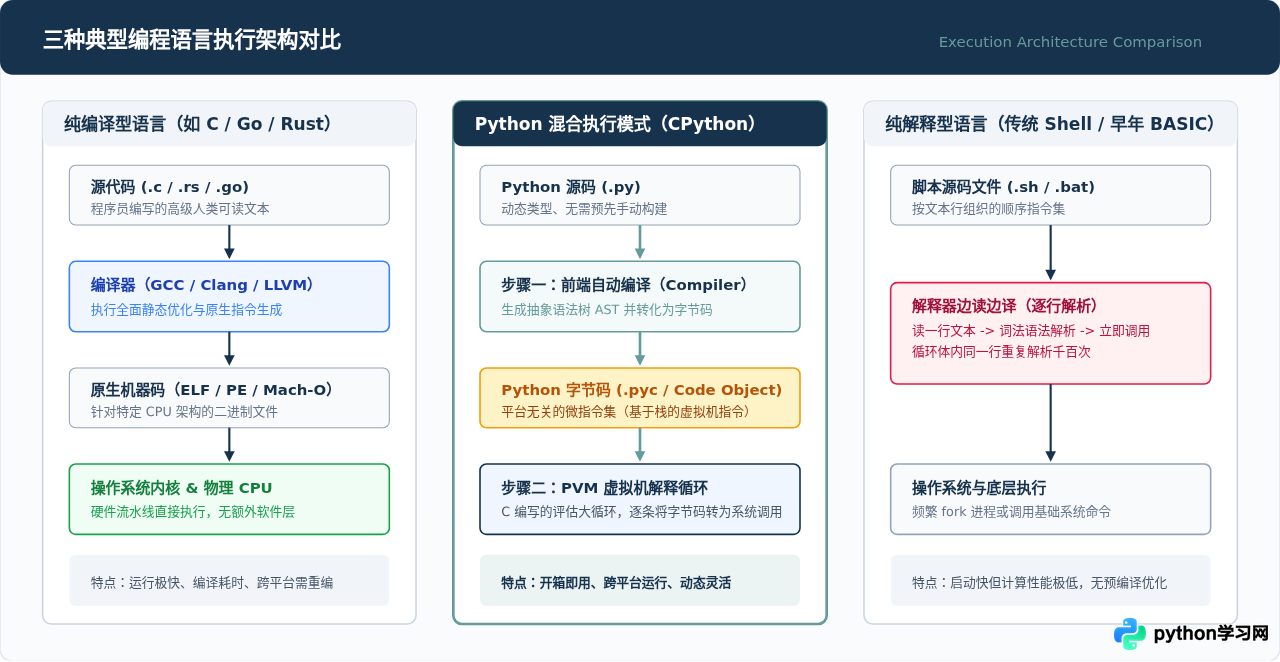
Python 既不是纯粹的静态机器码编译型语言,也不是逐行读取源码实时翻译的纯解释型语言。以最常用的官方实现 CPython 为例,Python 采用的是“前端编译为字节码 + 虚拟机解释执行字节码”的混合执行模型。
一、为什么说“Python 不需要编译”是一个常见误区?
要澄清这个问题,必须先区分计算机科学中两种不同的“编译”概念:
- 编译到机器码(AOT / Native Compilation):如 C/C++、Rust、Go。编译器直接将人类可读的高级语言代码转化为目标 CPU 架构(如 x86-64、ARM)所识别的原生机器指令。生成的是独立的二进制可执行文件,运行时脱离源代码和编译器。
- 编译到中间字节码(Bytecode Compilation):如 Java(编译为 JVM 字节码)、Python(编译为 PVM 字节码)。源码先被翻译成结构紧凑、平台无关的中间指令集,随后由专门的软件虚拟机负责调度和执行。
传统的纯解释型语言(例如早期的 Shell 脚本或早期版本的 BASIC)在执行时,解析器会从第一行一直读到最后一行,读一行翻译一行,遇到循环体内的代码就反复重复词法分析和语法分析。这种方式开销极大。现代主流的解释型语言早已不再采用这种极端低效的模型。Python 在启动执行的第一步,就会将完整的源代码文件解析成内存中的抽象语法树(AST),并立即编译为字节码对象(Code Object)。
二、Python 脚本的完整执行流水线:从源码到 CPU
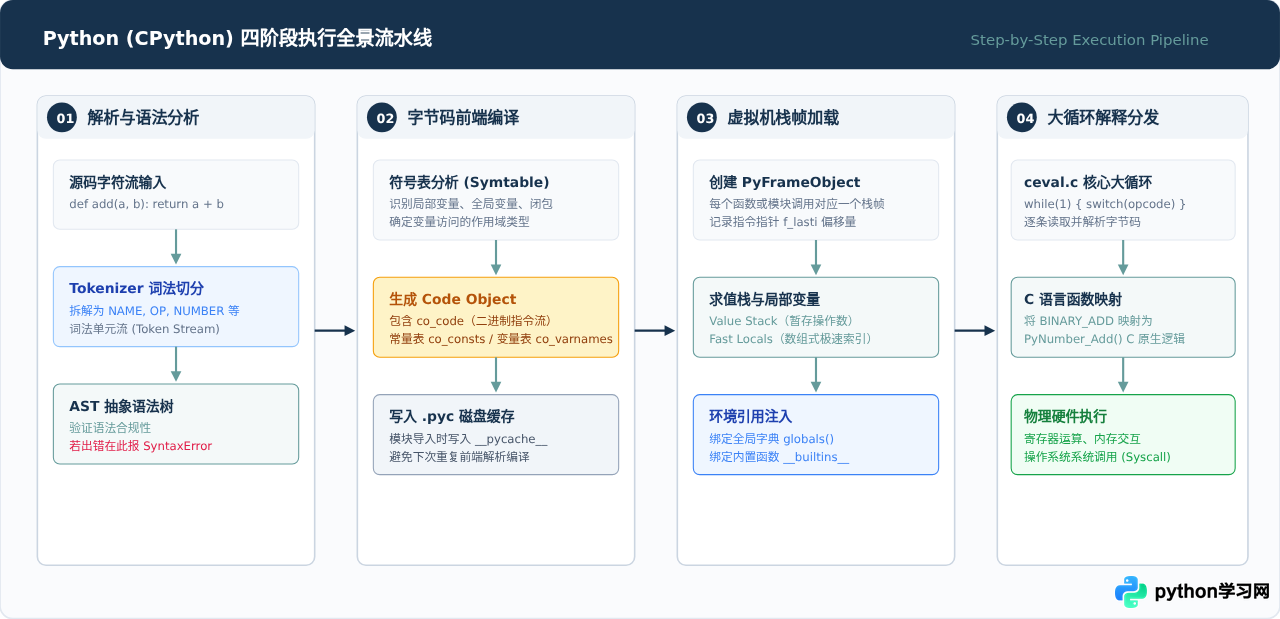
当我们在终端中执行一条命令,例如 python app.py 时,默认的官方实现 CPython 会依次完成以下四个核心步骤:
1. 词法分析与语法分析(Lexing & Parsing)
解释器首先读取 .py 文件的源码字符流。词法分析器将其拆解为由关键字、标识符、字面量和运算符组成的词法单元(Tokens)。紧接着,语法分析器验证这些词法单元是否符合 Python 的语法规范,并在内存中构建出树状结构的抽象语法树(Abstract Syntax Tree, AST)。如果代码中存在括号未闭合或缩进错误,程序会在这一阶段直接抛出 SyntaxError 并立即终止,根本不会进入后续的任何执行阶段。
2. 编译生成字节码(Bytecode Compilation)
一旦语法树通过校验,Python 内部的编译器会将这棵抽象语法树转换成由符号表(Symbol Table)支持的内部对象——代码对象(Code Object)。代码对象中包含了函数名、常量池、局部变量名列表以及最重要的部分:字节码指令序列(Bytecode Instructions)。字节码是一种紧凑的一维指令序列,每条指令包含 1 个字节的操作码(Opcode)和对应操作数(Oparg)。
3. 构建执行上下文与虚拟机加载(PVM Execution Frame)
字节码生成后,Python 虚拟机(Python Virtual Machine, 简称 PVM)启动。PVM 是一个纯软件实现的“虚拟计算机”,采用基于栈(Stack-based)的架构。针对每一个代码块或函数调用,PVM 都会分配一个执行栈帧(PyFrameObject)。每个栈帧中维护三个核心区域:局部变量字典(Fast Locals)、用于暂存中间计算结果的求值栈(Evaluation Stack),以及全局和内置命名空间引用。
4. 评估大循环分发与硬件执行(Evaluation Loop)
CPython 虚拟机的执行核心是位于源码 Python/ceval.c 中的超大函数循环(现代 Python 中名为 _PyEval_EvalFrameDefault)。这个循环包含一个庞大的 switch-case 语句,按顺序读取字节码序列,逐条提取操作码并分发到对应的 C 语言处理逻辑中。最终,通过 C 语言运行时的函数调用和操作系统 API,将计算任务转化为底层 CPU 的机器指令执行。
三、揭开 .pyc 与 __pycache__ 的秘密:缓存机制如何运作
很多开发者在项目中经常能看到一个名为 __pycache__ 的文件夹,里面存放着类似 utils.cpython-311.pyc 的二进制文件。这些文件正是 Python 编译器生成的字节码缓存文件。
1. 为什么直接运行 python main.py 通常不生成 main.pyc?
这里存在一个设计取舍:
- 作为顶层启动入口(Top-level Script):当直接运行一个主脚本时,Python 假设这个文件属于开发者正在频繁修改和测试的代码,因此它只在内存中完成字节码编译并立即执行,默认不花费磁盘 I/O 写入
.pyc缓存。 - 作为导入模块(Imported Modules):当一个文件通过
import utils方式引入时,Python 认为库文件和依赖模块相对稳定,因此会将编译好的字节码写入__pycache__。下次再度导入该模块时,直接读取.pyc即可跳过词法解析和语法树编译,极大提升程序启动速度。
2. Python 如何知道 .pyc 缓存有没有过期?
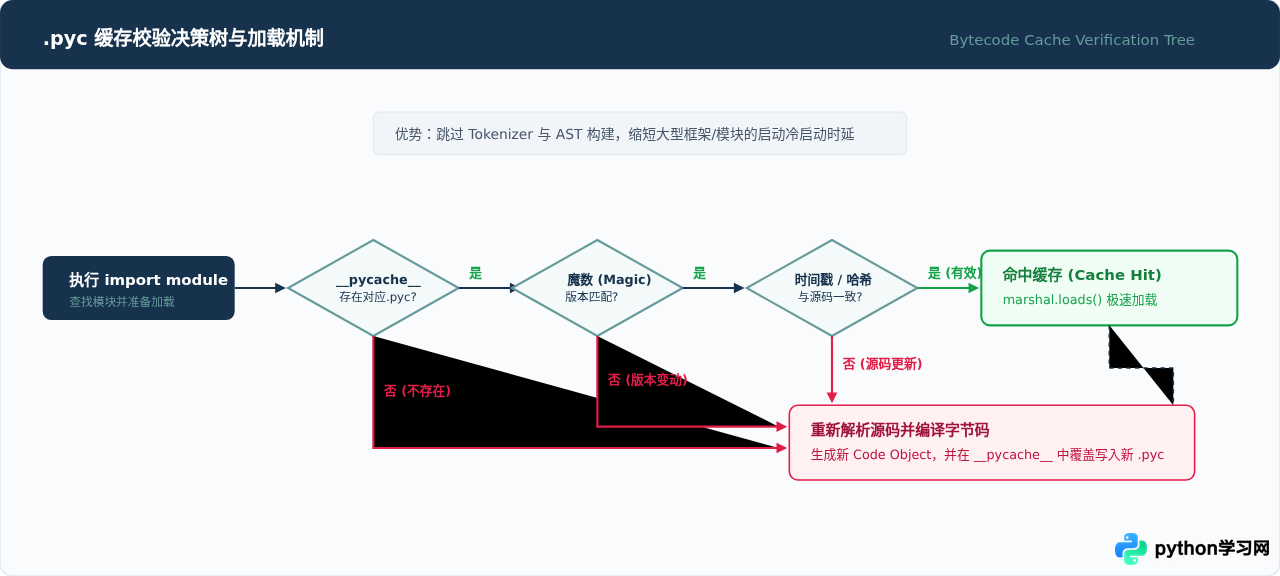
.pyc 文件内部由特定的头部数据(Header)和序列化后的 Code Object 组成。头部包含关键的校验信息:
- Magic Number(魔数):表示创建该
.pyc的 Python 解释器主版本与构建版本号(例如 Python 3.10 与 3.11 的魔数不同)。如果升级了 Python,旧版本魔数直接失效。 - 时间戳模式(Timestamp-based):记录源
.py文件的最后修改时间(mtime)以及文件大小。如果源码的 mtime 比.pyc中记录的时间晚,说明源码已被编辑,缓存失效。 - 哈希校验模式(Hash-based):针对 Docker 构建或可重现构建环境,Python 支持记录源码的 SHA-256 哈希值,避免文件系统时间戳抖动带来的失效。
四、动手实操:亲手查看与拆解 Python 字节码
我们可以通过 Python 标准库自带的 dis 模块(Disassembler 反汇编器)来直观查看 Python 编译器输出的字节码指令。打开 Python 交互式终端(REPL),定义一个简单的数值相加函数并反汇编:
import dis

def add_numbers(a, b):
    result = a + b
    return result

# 打印该函数的内部字节码指令
dis.dis(add_numbers)
在 Python 3.11+ 环境下,该命令会输出类似如下的标准反汇编结果:
  2           0 RESUME                   0

  3           2 LOAD_FAST                0 (a)
              4 LOAD_FAST                1 (b)
              6 BINARY_OP                0 (+)
             10 STORE_FAST               2 (result)

  4          12 LOAD_FAST                2 (result)
             14 RETURN_VALUE
逐行分析这些指令的含义,可以清晰看出栈式虚拟机的运作逻辑:
LOAD_FAST 0 (a):将局部变量a压入 PVM 的求值栈顶。LOAD_FAST 1 (b):将局部变量b同样压入求值栈顶,此时栈中有两个元素。BINARY_OP 0 (+):从栈顶弹出两个元素,调用对应的加法魔法方法(例如__add__),将计算得到的新对象压回栈顶。STORE_FAST 2 (result):弹出栈顶结果,并将其指针保存到局部变量表槽位result中。LOAD_FAST 2 (result)与RETURN_VALUE:将结果再度压栈并作为当前帧的返回值弹出。
我们还可以通过内置函数 compile(),手动将一段字符串源码编译为 Code Object,并检查其属性:
source_code = "total = 100 + 200"
code_obj = compile(source_code, filename="<string>", mode="exec")

print(type(code_obj))        # 输出: <class 'code'>
print(code_obj.co_code)      # 输出: 原生字节码指令流 (二进制 bytes)
print(code_obj.co_consts)    # 输出: 常量元组 (100, 200, 300, None 等)
print(code_obj.co_varnames) # 输出: 变量名元组 ('total',)这无可辩驳地证明:在代码被实际执行之前,Python 已经预先在内存中完成了完整的编译过程。
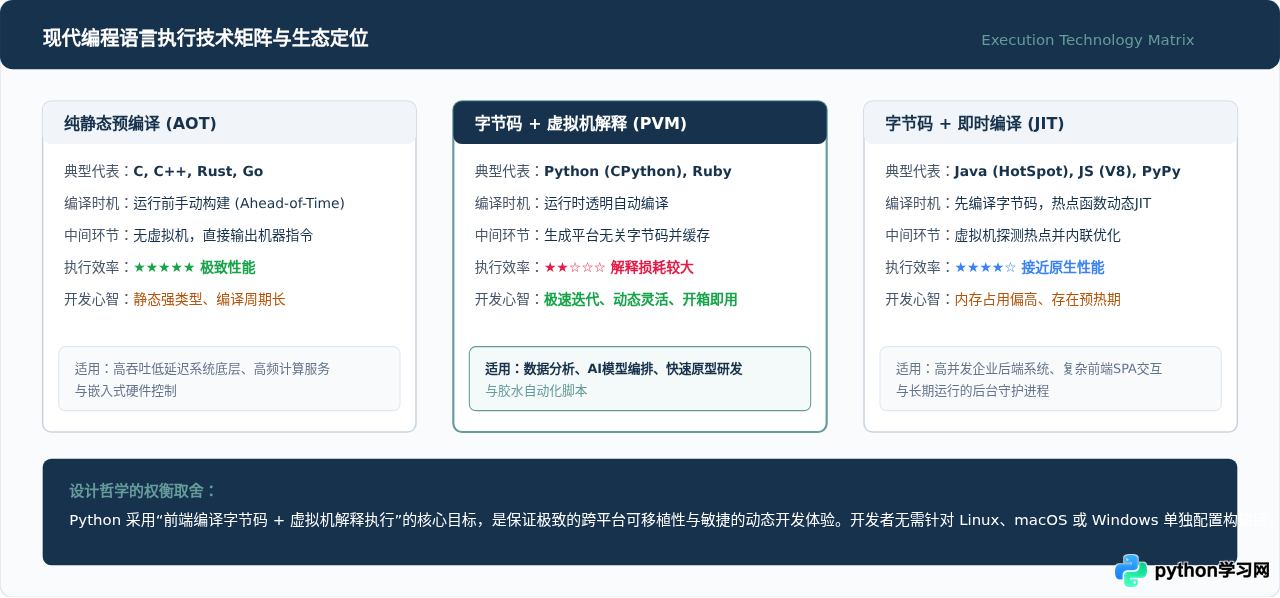
五、横向对比:主流语言执行模式全景总结
为了全面理解 Python 在现代编程语言生态中的位置,我们可以从“源码生成物”、“执行载体”以及“优化时机”等维度,对比当前主流语言的执行机制:
| 分类模式 | 代表语言 | 中间编译产物 | 最终执行载体 | 性能与特点 |
|---|---|---|---|---|
| AOT 静态编译 | C, C++, Rust, Go | 平台原生机器码(ELF/PE) | 物理 CPU 直接运行 | 执行性能极高;但跨平台需在对应系统上重新编译。 |
| 字节码 + 虚拟机解释 | Python (CPython), Ruby | 字节码(.pyc / Code Object) | 软件虚拟机(PVM / YARV) | 开发效率高、平台通用;但虚拟机解释执行较慢。 |
| 字节码 + JIT 即时编译 | Java (JVM), JavaScript (V8), PyPy | 字节码 + 运行时机器码 | 虚拟机 + JIT 编译器 | 热点代码在运行时被动态编译为机器指令,兼顾速度与动态特性。 |
六、高频疑问与实践要点
1. 既然已经编译成了字节码,为什么 Python 仍然比 C 语言慢很多?
很多读者会有这样的疑问:既然 Python 也做了编译,为什么在数值计算或循环处理上与 C 仍有数十倍的速度差距?主要原因在于:
- 字节码并非机器码:C 语言编译输出的是硬件直接识别的指令,而 Python 字节码必须经过 PVM 的
while-switch大循环在内存中逐一分发,每条指令都伴随多次函数调用与栈操作开销。 - 动态类型与属性检查:在 C 语言中,
int a = 1; int b = 2; a + b在编译期就确定了内存偏移量和数据类型,一条汇编add eax, ebx即可完成。而在 Python 中执行a + b,PVM 必须在运行时检查a和b的真实类型、查找是否存在重载的__add__方法、检查溢出并构造新的PyObject,执行成本完全不在一个数量级。 - 全局解释器锁(GIL):在标准 CPython 下,多线程受限于 GIL,无法直接利用多核 CPU 并行执行 Python 字节码。
2. 仅分发 .pyc 文件能否保护商业源码?
很多团队希望通过只分发 .pyc 二进制文件来实现代码闭源商业交付,这并不能提供足够的安全防护。因为 .pyc 中完整保留了函数的变量名、行号信息、字符串字面量以及完整的字节码控制流。社区中诸如 uncompyle6 或 decompyle++ 等逆向工具,能够在数秒内将 .pyc 反编译还原为可读性达到 95% 以上的 Python 源代码。如果需要代码保护,推荐使用 Cython 编译为 C 扩展动态链接库(.so / .pyd),或者结合代码混淆工具。
3. 如何在生产容器中禁止生成 __pycache__?
在构建轻量级 Docker 镜像或受限只读文件系统时,若不希望 Python 在运行时往磁盘写 .pyc 文件,可以通过以下两种方式禁用缓存生成:
- 设置环境变量:
export PYTHONDONTWRITEBYTECODE=1 - 命令行参数传递:
python -B main.py
需要注意的是,禁用 .pyc 写入并不会取消 Python 内部的编译步骤,Python 依然会在每次启动时将源码在内存中编译为 Code Object,仅仅是不向磁盘落盘缓存而已。
总结
回到最初的问题:“Python 脚本需要编译吗?”
答案是非常明确的:需要。Python 从来都不是一行行纯文本直接喂给 CPU 的古老解释型语言。它的标准执行机制分两段进行:第一阶段在内存中透明地完成语法分析与字节码编译;第二阶段由基于栈的 Python 虚拟机逐条解释执行字节码指令。理解了这一点,就能彻底看懂 __pycache__ 文件夹的来历,掌握 dis 模块的调优排查能力,并在架构设计中更游刃有余地发挥 Python 的长处。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















