


Python 2与Python 3基础语法的主要差异有哪些
全面梳理Python 2与Python 3在基础语法上的核心差异,涵盖print语句函数化、除法运算机制、文本与字节模型、迭代器优化及异常处理语法,附带高清内联结构图示与实用对比示例。
在维护旧系统代码、阅读经典算法实现或将遗留脚本升级到现代运行环境时,开发者最常碰到的就是因语法规则不一致导致的 SyntaxError 或运行期隐蔽错误。Python 3 并非 Python 2 的简单打补丁升级,而是打破向后兼容性的一次系统性重构。本文聚焦初学者与进阶开发者最容易混淆的几大核心语法维度——控制台打印、除法计算法则、文本与字节模型、迭代器化机制与异常捕获语法,逐一剖析具体表现、背后的语言设计原因及正确的迁移写法。
一、文本编码与数据类型的底层重塑
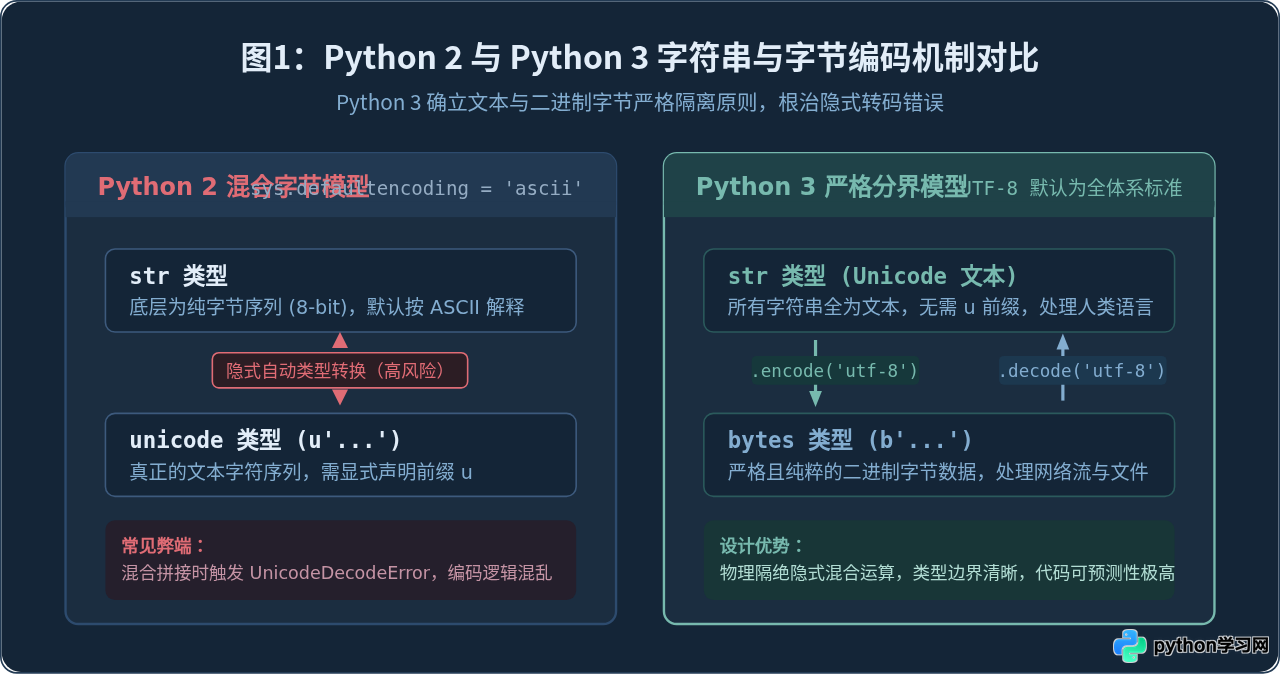
如果要选出 Python 2 迁移到 Python 3 最深刻的变化,必然是字符串与二进制字节的处理机制。在 Python 2 中,默认的 str 类型本质上是 8 位的字节流(byte string),而真正的 Unicode 文本必须显式加上前缀表示为 unicode 类型(如 u"中文")。由于 Python 2 允许二者在许多场景下进行隐式自动转换,一旦程序涉及非 ASCII 字符(例如中文字符),经常在不可预知的时机抛出臭名昭著的 UnicodeDecodeError: 'ascii' codec can't decode byte。
Python 3 彻底根除了这种模糊性,建立了清晰坚固的“Unicode 三明治”模型:
- 所有文本皆为
str:默认即为 Unicode 编码字符序列,无需加u前缀,源码文件也默认采用 UTF-8 编码。 - 二进制数据独立为
bytes:原始字节数组必须显式使用b"..."声明或由类创建。 - 严禁隐式混合拼接与比较:
str与bytes之间不再支持用+进行无缝连接,也不再支持直接大小比较。若需转换,必须明确调用str.encode()与bytes.decode()。
二、输出与输入交互的语法变革
作为几乎所有初学者写出的第一行 Python 代码,print 在版本迭代中经历了从“语句”(Statement)到“内置函数”(Function)的本质转变。
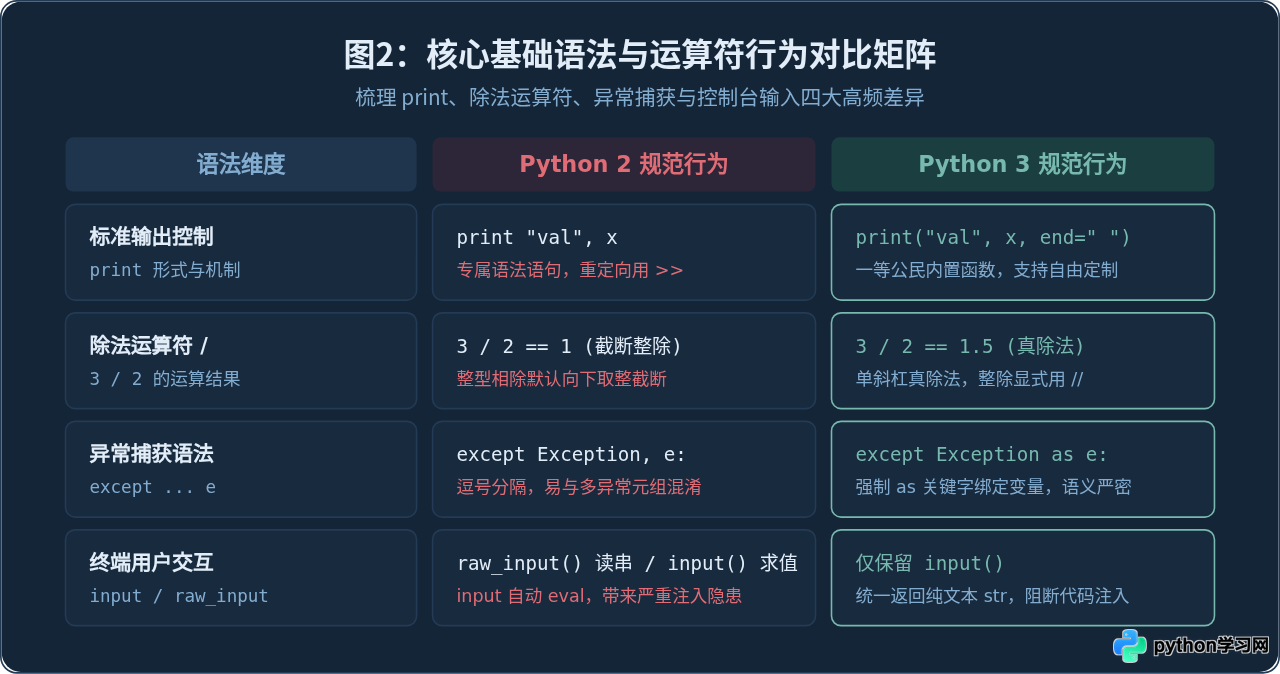
1. print 语句转变为 print() 函数
在 Python 2 中,print 是像 if、return 一样的内置语法关键字。这意味着它可以直接跟随参数,通过逗号分隔:
# 打印单行文本
print "Hello World"

# 不换行输出(结尾加逗号)
print "Loading...",

# 重定向输出到文件句柄
print >> sys.stderr, "Error log"# 必须使用括号调用函数
print("Hello World")
# 通过参数定制结尾字符
print("Loading...", end="")
# 通过 file 参数优雅重定向
print("Error log", file=sys.stderr)
在 Python 2 中,如果写 print("A", "B"),打印出来的实际上是一个包含两个元素的元组 ('A', 'B'),而在 Python 3 中它会按函数位置参数打印为 A B。函数化后的 print() 能够作为一等公民(First-class citizen)参与高阶函数调用、映射操作以及使用关键字参数自由配置 sep、end 与 flush。
2. 输入函数 input() 与 raw_input() 的安全统整
交互式命令行读取在 Python 2 中存在著名的安全陷阱:
raw_input():将用户输入的所有字符作为原始字符串返回。input():等同于eval(raw_input()),即会尝试将用户输入作为 Python 表达式动态求值。若用户输入__import__('os').system('rm -rf /'),程序将直接执行该危险指令。
在 Python 3 中,极易导致安全漏洞的 input() 求值机制被彻底废弃,同时移除了 raw_input() 函数名。现在的 input() 功能与过去的 raw_input() 完全一致,一律安全返回字符串。若需要数值,需由开发者主动显式转换,例如 int(input())。
三、数值计算与运算符特性的改变
除了表面上的函数括号,Python 3 对基础数学运算规则也作出了修正,避免了过去长久困扰科学计算与工程开发者的“隐式整数整除”。
1. 除法运算符 / 与 //
在 Python 2 中,/ 的行为取决于操作数的类型。如果两个操作数均为整数,它会采用“古典除法”(Floor Division),即自动舍去小数部分:
# Python 2 运行表现
print 5 / 2      # 输出: 2
print 5 / 2.0    # 输出: 2.5
这种特性常常在处理几何坐标、百分比换算或数学统计时引发难以察觉的 bug。而在 Python 3 中,规则被重新定义:
/代表真除法(True Division):无论操作数是否为整数,运算结果始终为浮点数(5 / 2 == 2.5,4 / 2 == 2.0)。//代表整除(Floor Division):显式向下取整(5 // 2 == 2)。
2. 长整型 long 的合并与非同类比较限制
在 Python 2 中,数值包含 32/64 位固定大小的 int 和无限精度的 long 类型(字面量结尾带有 L,如 1024L)。Python 3 移除了 long 类型与 L 后缀,将所有整数统一收纳在 int 下,内部实现自动扩展,无需开发者操心内存溢出。
此外,Python 2 允许对完全不相干的类型进行无限制的大小比较(例如 "abc" > 123 会返回 True,因为根据内部类型名排序规则 string 判定大于 number)。在 Python 3 中,异构类型之间直接比较大小会被直接拦截,抛出 TypeError: '>' not supported between instances of 'str' and 'int',有效防止逻辑失控。
四、集合、迭代器与内置函数的优化
Python 3 在数据结构遍历方面全面拥抱惰性求值(Lazy Evaluation),大幅降低了大数据集处理时的内存占用。
1. xrange 的淘汰与 range 的迭代器化
在 Python 2 中生成数列有两个选项:
range(1000000):在内存中瞬间创建并分配一个包含一百万个整数的完整list。xrange(1000000):返回一个惰性计算的生成器对象,按需消耗。
在 Python 3 中,直接移除了 xrange(),而原本的 range() 则被重构为轻量级序列对象。它不占用额外内存空间,即使写 range(10**10) 也只消耗固定少量的元数据开销。如果确实需要得到一个实际列表,只需显式包装为 list(range(...))。
2. 字典方法的视图化改造
在 Python 2 中,字典对象的 d.keys()、d.values() 和 d.items() 均返回一个完整的列表快照;为了避免内存拷贝,Python 2 额外提供了 d.iterkeys()、d.itervalues()、d.iteritems()。
Python 3 删除了带有 iter 前缀的方法,直接让 keys()、values()、items() 返回动态字典视图(Dictionary Views)。视图对象反映字典的实时变更,并且支持类似集合的快速交集、并集等集合操作,极大提升了执行效率。
五、异常处理与作用域语法的规范化
在错误处理方面,Python 3 规范了异常捕获语法,避免因逗号产生歧义:
# Python 2 常见写法(极易引起混淆)
try:
    process_data()
except ValueError, e:    # 逗号既可能表示捕获变量,也可能表示捕获多个异常类型
    print "Error:", e

# Python 3 强制写法
try:
    process_data()
except (ValueError, TypeError) as e:  # 多个异常必须用元组包裹,变量必须通过 as 绑定
    print(f"Error: {e}")
另外,在 Python 2 中,列表推导式中的循环变量会污染外层作用域(如 [x for x in range(5)] 运行后,外部环境变量 x 的值会被更改为 4)。Python 3 修正了这一局部作用域漏洞,列表推导式内的循环变量被严格限制在子作用域中,不再污染外部环境。
六、代码升级与排查四步流程
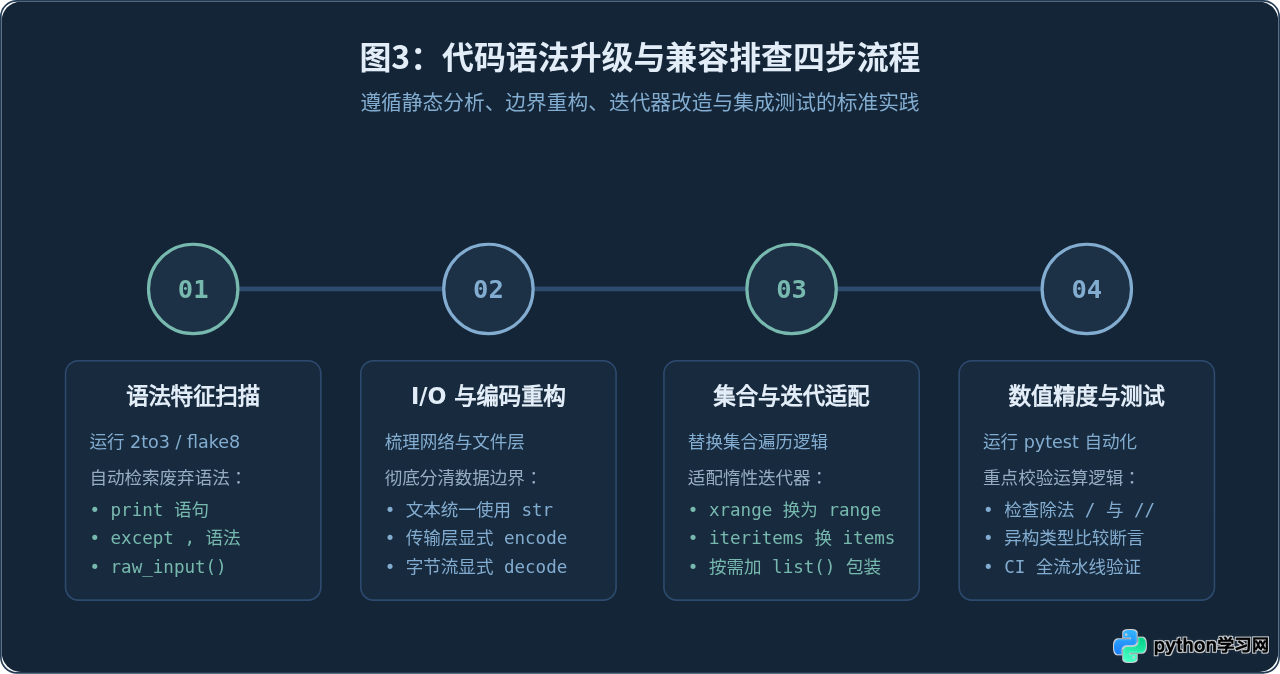
当面对现存的 Python 2 项目时,不应盲目全局替换,而应建立分层排查与渐进式测试验证机制。下图展示了从语法识别到多版本适配的标准升级流程:
七、语法差异核心速查与总结
为了帮助开发者在实际编写和调试代码时快速定位语法特征,下表汇总了高频基础语法的关键对照点:
| 语法特性 | Python 2 实现方式 | Python 3 实现方式 | 主要影响与注意事项 |
|---|---|---|---|
| 打印输出 | print "abc" |
print("abc") |
转为函数,支持 end=""、file=... 参数 |
| 整数除法 | 5 / 2 == 2 |
5 / 2 == 2.5 |
单斜杠为真除法,向下取整必须用 5 // 2 |
| 字符串默认编码 | ASCII (字节流 str) |
UTF-8 (Unicode str) |
彻底杜绝中文字符处理中的隐式转码崩溃 |
| 二进制数据 | 无严格界限,用 str 充当 |
独立类型 bytes (前缀 b) |
str 与 bytes 不可混加,必须显式编解码 |
| 控制台输入 | raw_input() / input() |
仅保留 input() |
统一返回文本字符串,消除了 eval 代码执行隐患 |
| 数值序列生成 | range() (数组) / xrange() |
range() (惰性对象) |
节省大量连续内存空间,xrange 已被彻底废除 |
| 字典遍历方法 | keys() 与 iterkeys() 等 |
keys()、items() 视图 |
废弃 iter* 系列,统一返回动态可迭代视图 |
| 异常语法绑定 | except Error, e: |
except Error as e: |
强化 as 关键字绑定变量,避免与元组参数歧义 |
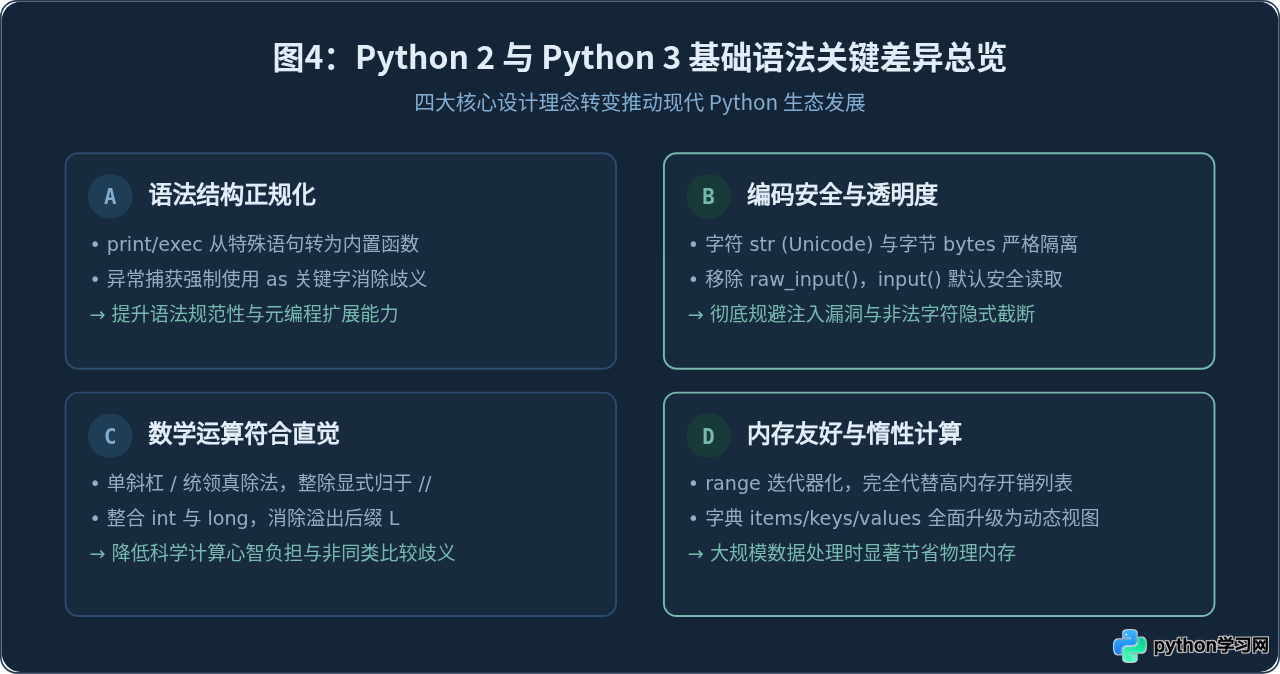
在现代工程项目中,Python 2 已经于 2020 年正式停止支持(EOL)。日常开发中应完全坚持 Python 3 的习惯:始终使用 pathlib 或显式编码打开文件(如 open(..., encoding="utf-8")),充分利用 f-string 字符串插值,养成使用类型提示(Type Hints)的习惯。理解这些基础语法历史差异,能让我们在阅读经典底层库或进行跨版本重构时更加游刃有余。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















