


学习Python能从事哪些工作:后端开发、爬虫与运维岗位分析
深入分析学习Python后能够从事的三大核心技术岗位:后端开发、网络爬虫与自动化运维。解析各岗位的工作职责、技能要求、技术栈差异与学习进阶路径,帮助学习者根据自身背景合理规划职业方向。
假设你刚刚学完了 Python 的变量、循环、函数与面向对象语法,能够独立写出几十行处理本地文件的脚本,但打开招聘软件搜索“Python”时,却发现岗位名称五花八门,不知道自己的代码究竟能对接到什么商业应用中。在软件开发领域,掌握 Python 语法仅仅是基础,企业招聘看重的是结合具体业务场景的工程化交付能力。在主流技术分工中,围绕 Python 形成核心商业需求的主要有三大方向:Web 后端开发、网络爬虫开发与自动化运维(DevOps/SRE)。本文从职责界定、核心技术栈、工程实施流程与职业进阶四个维度,对这三大岗位展开系统分析,帮助你理清技能要求与定位差异。
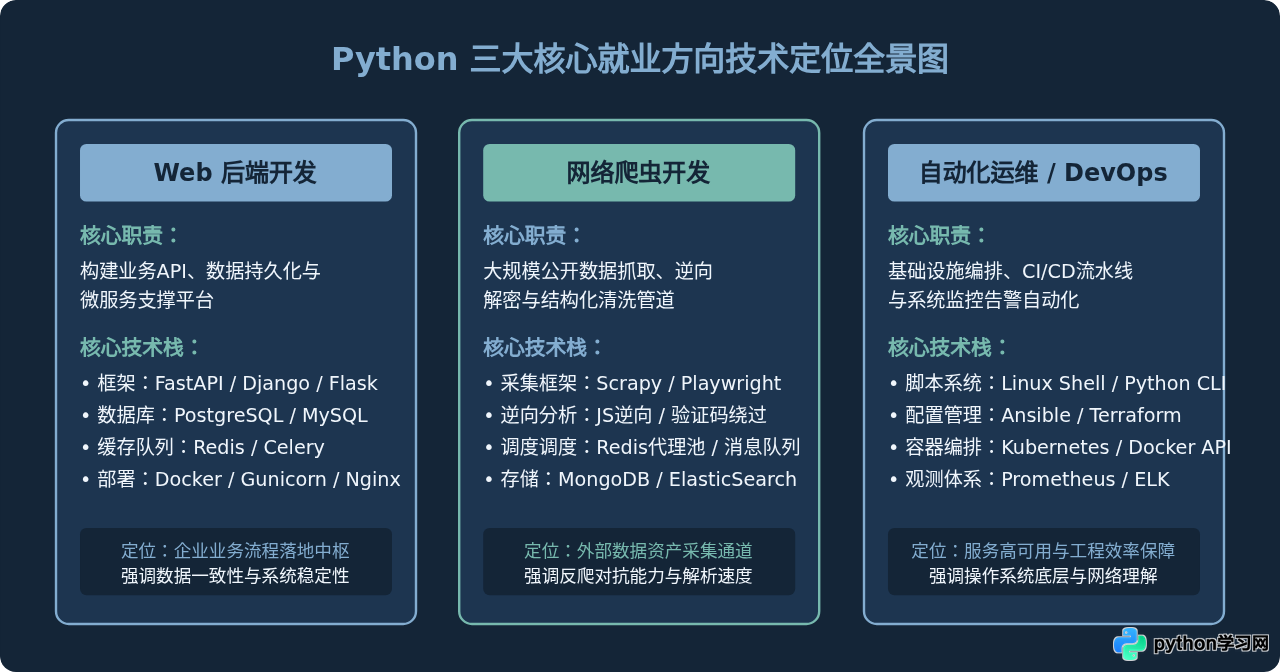
一、Python Web 后端开发:业务逻辑中枢与接口架构
Web 后端开发是 Python 招聘量最为庞大且成熟的领域之一。后端工程师的主要任务,是接收来自前端(Web 浏览器、移动端 App、小程序)的网络请求,完成身份校验、业务逻辑计算,并将结果与数据库进行安全读写后返回给客户端。
1. 核心技术栈构成
从事 Python 后端开发,仅掌握语法远远不够,必须掌握完整的现代 Web 体系:
- Web 框架:主流包括高并发异步框架
FastAPI、企业级全功能框架Django以及轻量级微框架Flask。目前新项目普遍倾向采用 FastAPI,因其基于类型注解并原生支持异步 I/O。 - 数据持久化与 ORM:熟练编写原生 SQL 并在 Python 中使用
SQLAlchemy或Django ORM映射数据库表。掌握 MySQL 或 PostgreSQL 的索引设计、慢查询分析与事务隔离机制。 - 缓存与异步任务队列:使用
Redis处理会话缓存与热点数据,使用Celery配合 RabbitMQ 或 Redis 执行邮件发送、视频转码等耗时后台任务。 - 工程化部署规范:掌握基于 Linux 环境的
Gunicorn/Uvicorn + Nginx部署架构,熟练使用Docker完成应用容器化打包。
2. 典型后端接口开发范式
以下为一个基于 FastAPI 的标准 RESTful 接口示例,展示现代 Python 后端如何通过异步处理与 Pydantic 模型完成参数校验与响应封装:
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field
from typing import Optional

app = FastAPI(title="用户任务管理系统", version="1.0.0")

# 数据传输对象(DTO)定义
class TaskCreateRequest(BaseModel):
    title: str = Field(..., min_length=2, max_length=50, description="任务标题")
    priority: int = Field(default=1, ge=1, le=5, description="优先级 1-5")
    description: Optional[str] = Field(None, max_length=200)

class TaskResponse(BaseModel):
    task_id: int
    title: str
    priority: int
    status: str = "pending"

# 内存模拟数据库
task_database = {}
current_id = 1000

@app.post("/api/v1/tasks", response_model=TaskResponse, status_code=status.HTTP_201_CREATED)
async def create_task(payload: TaskCreateRequest):
    global current_id
    current_id += 1
    new_task = {
        "task_id": current_id,
        "title": payload.title,
        "priority": payload.priority,
        "status": "pending"
    }
    task_database[current_id] = new_task
    return new_task

@app.get("/api/v1/tasks/{task_id}", response_model=TaskResponse)
async def get_task(task_id: int):
    task = task_database.get(task_id)
    if not task:
        raise HTTPException(
            status_code=status.HTTP_404_NOT_FOUND,
            detail=f"ID 为 {task_id} 的任务不存在"
        )
    return task
二、网络爬虫开发:数据采集、逆向对抗与管道工程
网络爬虫开发专注于从公开互联网自动化、规范化地采集结构化数据。该岗位广泛存在于舆情监测、比价平台、市场调研、AI 训练语料采集等业务中。随着现代网站反爬机制的增强,爬虫工程师的核心工作早已从简单的 HTML 解析转移到了高维度的协议破解与自动化风控绕过。
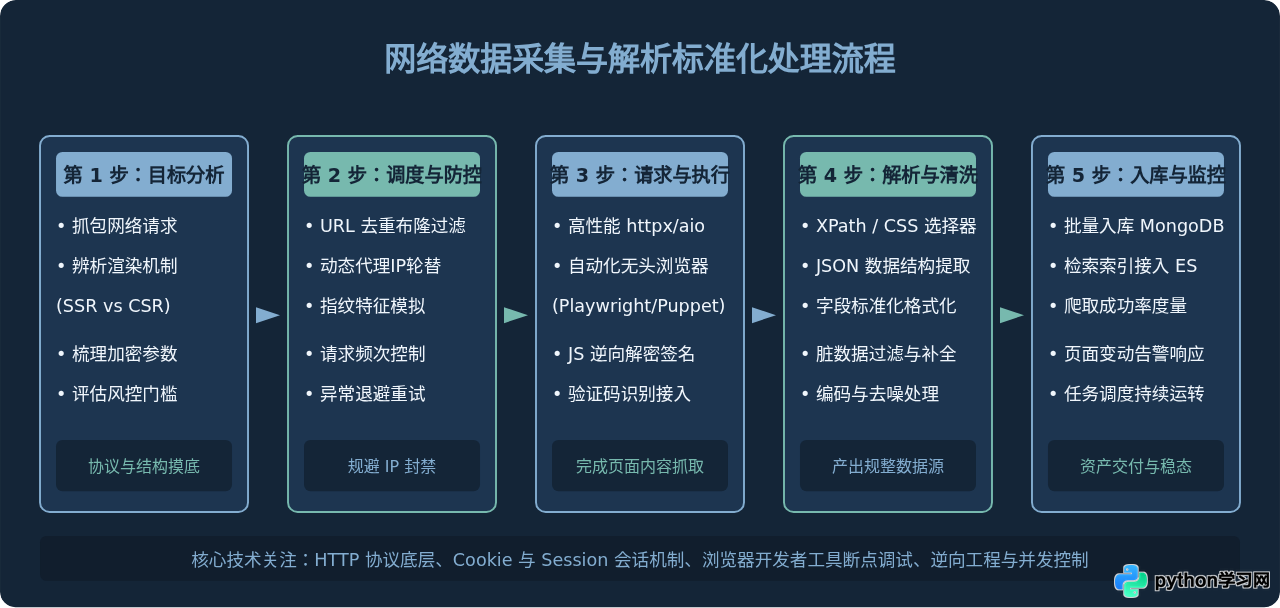
1. 爬虫工作流的标准执行环节
一个合格的生产级爬虫系统需要经历目标分析、调度控制、请求分发、逆向解密、数据解析与存储等严密环节:
2. 核心技术栈与代码示例
现代爬虫开发高度重视异步网络 I/O。下面的代码展示了一个生产环境中常见的异步采集模版,包含了自定义请求头模拟、网络超时设置、状态码校验以及针对不稳定网络环境的重试逻辑:
import asyncio
import httpx
from bs4 import BeautifulSoup
from typing import Optional, Dict

HEADERS = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
}

async def fetch_target_page(client: httpx.AsyncClient, url: str, max_retries: int = 3) -> Optional[str]:
    for attempt in range(1, max_retries + 1):
        try:
            response = await client.get(url, headers=HEADERS, timeout=10.0)
            if response.status_code == 200:
                return response.text
            elif response.status_code == 403:
                print(f"[告警] 触发目标站点风控拦截 (403 Forbidden),终止重试: {url}")
                return None
            else:
                print(f"[重试 {attempt}/{max_retries}] 状态码异常: {response.status_code}")
        except httpx.RequestError as exc:
            print(f"[重试 {attempt}/{max_retries}] 网络请求错误: {exc}")
        await asyncio.sleep(1.5 * attempt)
    return None

def parse_page_content(html: str) -> Dict[str, str]:
    soup = BeautifulSoup(html, "html.parser")
    title_node = soup.find("h1")
    title = title_node.get_text(strip=True) if title_node else "未获取到标题"

    # 提取正文内容并清理多余空行
    body_node = soup.find("article") or soup.find("div", class_="content")
    content = body_node.get_text(separator="\n", strip=True) if body_node else ""
    return {"title": title, "content": content}
robots.txt 协议及数据使用规范。
三、自动化运维与 SRE:系统稳定性与交付效率基石
自动化运维(DevOps 工程师 / SRE 站点可靠性工程师)是保障系统在线服务7×24小时高可用的核心技术角色。传统的运维依赖手工登录终端输入命令,而在大规模集群和云原生环境下,运维人员必须借助 Python 的胶水语言特性与丰富的系统级库,将巡检、发布、配置下发和故障恢复转化为代码。
1. 核心技术栈构成
该方向对操作系统的理解深度要求极高,其核心技术栈包括:
- 操作系统与网络基础:精通 Linux 文件系统、进程模型、TCP/IP 协议栈(三次握手、四次挥手、TIME_WAIT 处理)、DNS 解析以及系统调用。
- Python 系统交互库:熟练使用
os、sys、subprocess、shutil处理进程与文件流;使用psutil实时采集系统 CPU、内存、磁盘与网络 I/O 状态。 - 自动化与云原生工具链:结合
Ansible编写自动化 Playbook,调用Docker SDK for Python或Kubernetes Client Python实现容器生命周期动态控制。 - 监控与告警闭环:使用 Python 开发自定义 Exporter 上报指标至 Prometheus,结合企业微信、钉钉或邮件 Webhook 实现自动化告警与故障自愈脚本。
2. 系统指标自动化巡检与告警脚本
以下为一个在生产环境中监控服务器资源并在超出阈值时自动触发告警的运维脚本示例:
import psutil
import socket
import datetime
import json
import urllib.request

CPU_THRESHOLD = 85.0     # CPU 使用率告警阈值 (%)
MEM_THRESHOLD = 90.0     # 内存使用率告警阈值 (%)
DISK_THRESHOLD = 90.0    # 磁盘根目录使用率告警阈值 (%)

def collect_system_metrics():
    cpu_percent = psutil.cpu_percent(interval=1)
    virtual_mem = psutil.virtual_memory()
    disk_usage = psutil.disk_usage('/')
    hostname = socket.gethostname()

    return {
        "hostname": hostname,
        "timestamp": datetime.datetime.now().strftime("%Y-%m-%d %H:%M:%S"),
        "cpu_usage": cpu_percent,
        "memory_usage": virtual_mem.percent,
        "disk_usage": disk_usage.percent
    }

def evaluate_and_notify(metrics, webhook_url=None):
    alerts = []
    if metrics["cpu_usage"] > CPU_THRESHOLD:
        alerts.append(f"CPU 使用率过高: {metrics['cpu_usage']}% (阈值: {CPU_THRESHOLD}%)")
    if metrics["memory_usage"] > MEM_THRESHOLD:
        alerts.append(f"内存使用率过高: {metrics['memory_usage']}% (阈值: {MEM_THRESHOLD}%)")
    if metrics["disk_usage"] > DISK_THRESHOLD:
        alerts.append(f"根分区磁盘空间紧张: {metrics['disk_usage']}% (阈值: {DISK_THRESHOLD}%)")

    if alerts:
        payload = {
            "title": f"【紧急服务器预警】主机: {metrics['hostname']}",
            "time": metrics["timestamp"],
            "details": alerts
        }
        print(f"[告警触发] {json.dumps(payload, ensure_ascii=False, indent=2)}")
        # 生产环境中在此处通过 urllib.request 发送 POST 请求至监控中心 Webhook
    else:
        print(f"[健康巡检正常] 主机 {metrics['hostname']} 各项指标在安全阈值内")

if __name__ == "__main__":
    current_metrics = collect_system_metrics()
    evaluate_and_notify(current_metrics)
四、学习路径与技能进阶推导
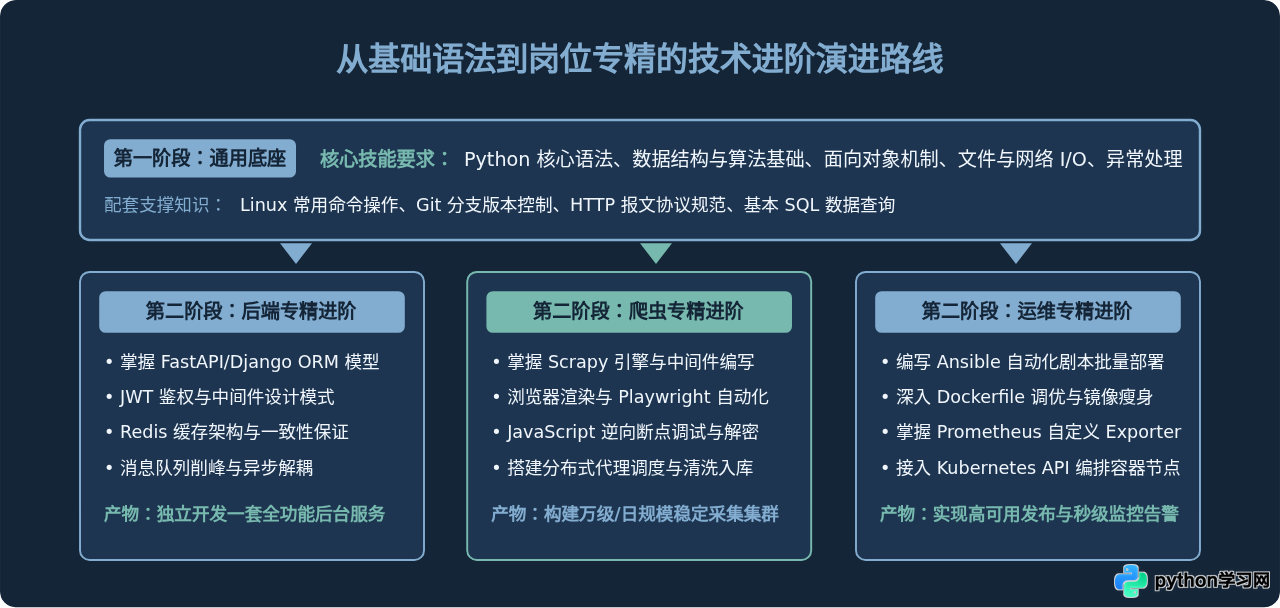
初学者切忌在没有建立通用技术底座之前就直接钻入某个特定方向的细枝末节。合理的学习路线应当是“倒 T 型”结构:先夯实通用的计算机与 Python 语言基础,随后根据个人兴趣与优势进行垂直领域的专项突破,最后在生产级复杂业务中完成工程化沉淀。
五、三大岗位综合对比与选型决策分析
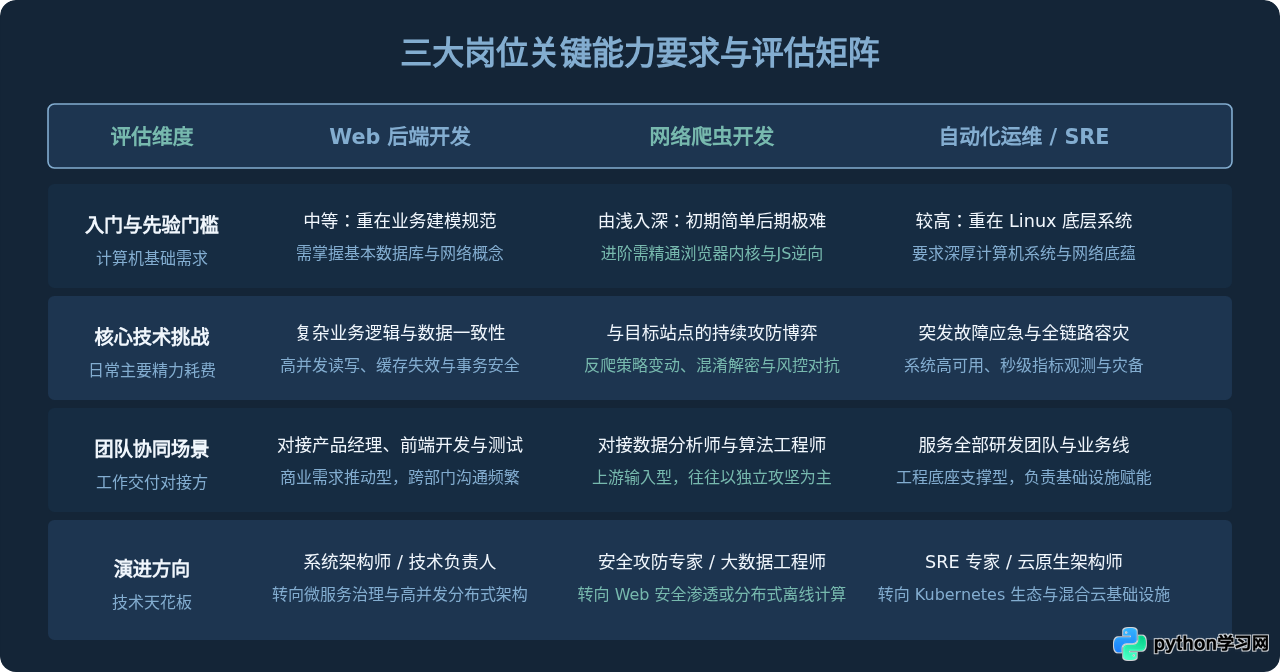
为了帮助读者根据自身的专业背景、技术偏好以及职业诉求做出理性的选择,下表将三大岗位在准入门槛、核心难点、协同场景及长期演进空间上做综合对比:
常见困惑解答(FAQ)
- 问题 1:初学阶段能否同时兼顾后端开发与爬虫?
在入门阶段可以并行了解,因为二者都建立在 HTTP 协议和网络通信基础上。后端开发是学习“如何正确构造并返回响应”,爬虫则是学习“如何解析响应并模拟请求”。但在进入求职冲刺阶段时,必须根据简历意向聚焦一个方向,集中火力打磨对应的项目深度。 - 问题 2:运维岗位为什么必须要学 Python,只写 Shell 不行吗?
Shell 脚本适合处理单机环境下几十行以内的简单文本流管道操作,但在面对跨系统 API 调用、解析复杂的 JSON/YAML 结构、接入云服务 SDK 或编写模块化单元测试时,Shell 缺乏完善的面向对象抽象和异常捕获机制,极易形成维护灾难。Python 是目前云原生时代自动化运维的首选胶水语言。 - 问题 3:求职面试中最常被追问的核心能力是什么?
面试官极少单纯考查 Python 的基础语法(如列表推导式怎么写),而是深入考查异常场景的处理经验。对于后端,常问“数据库死锁或慢查询如何排查”;对于爬虫,常问“目标网站修改签名算法或遭遇 IP 封锁如何自愈”;对于运维,常问“服务器出现大量 TIME_WAIT 状态如何定位优化”。这要求学习者在平时练习中不仅要写通代码,更要关注边界异常与排错链路。
综上所述,Python 为开发者提供了宽广的职业通道。选择后端开发意味着深耕商业系统与高并发架构;选择网络爬虫意味着专注于数据挖掘与逆向对抗;选择自动化运维则意味着执掌系统的稳定性与交付效率。清晰识别各方向的技能要求,针对性地完成工程化实践,是学完 Python 顺利走向职场的关键路径。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















