


Python内置sqlite3无需安装:直接操作本地数据库的方法
详细讲解如何利用Python自带的标准库sqlite3直接操作本地SQLite数据库,包括连接创建、建表、增删改查、事务管理及实用注意事项。
在日常数据处理与应用程序开发中,很多开发者习惯在需要存储结构化数据时首先考虑部署 MySQL 或 PostgreSQL 等服务。然而,Python 标准库中自带的 sqlite3 模块无需任何 pip install 安装步骤,也不需要启动独立数据库后台进程,直接调用即可在本地管理单文件数据库或内存数据库。本文将详细介绍如何通过 sqlite3 建立数据库连接、设计数据表、执行增删改查(CRUD)操作以及管理事务,帮助你在开发脚本、测试工具或小型项目时快速落地本地数据持久化。
1. 什么是 sqlite3 与它的适用边界
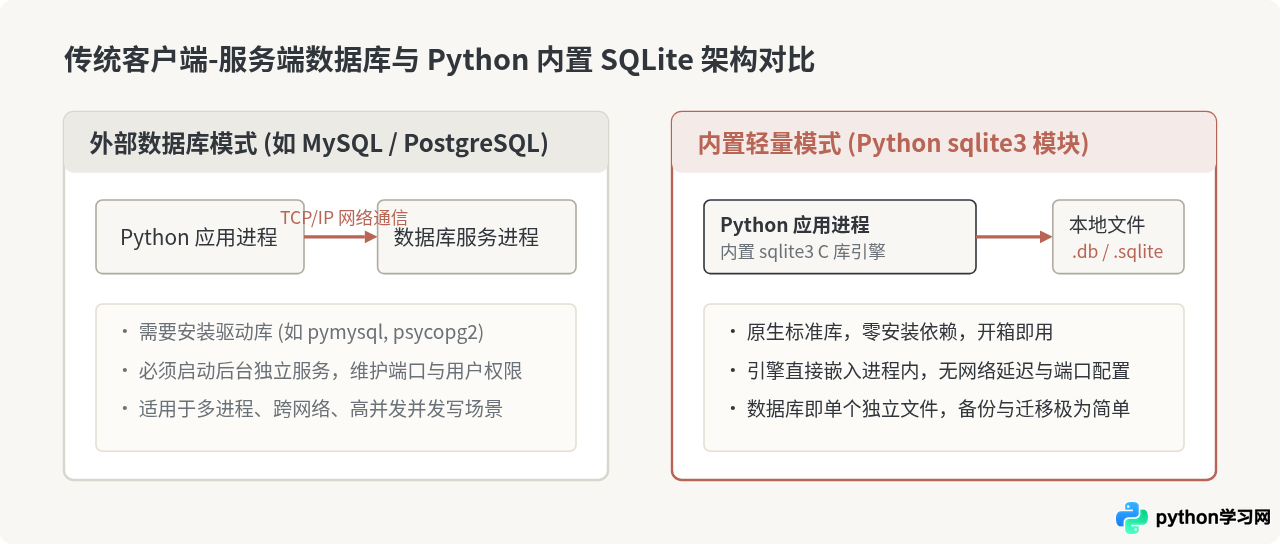
SQLite 是一款轻型、嵌入式的关系型数据库引擎,其核心代码由 C 语言写成。Python 将其封装成了标准库模块 sqlite3。这意味着只要你的系统正常安装了标准 Python 解释器,无论是 Windows、macOS 还是 Linux,都可以直接通过 import sqlite3 载入,不需要单独下载或安装外部第三方模块。
在适用场景上,SQLite 的主要优势在于“零配置”与“自给自足”。整套数据库完整保存在一个普通的磁盘文件中,移动或备份只需拷贝该文件。同时,它也支持在内存中建立临时数据库(:memory:),在程序退出时自动释放。不过需要注意其适用边界:SQLite 适合读多写少、单机本地持久化、桌面端软件及自动化分析脚本;若系统面临多服务器跨网络并发写操作,或需要细粒度多租户权限隔离,仍应选用外部关系型数据库服务。
2. 核心操作步骤:从建库到完成查询
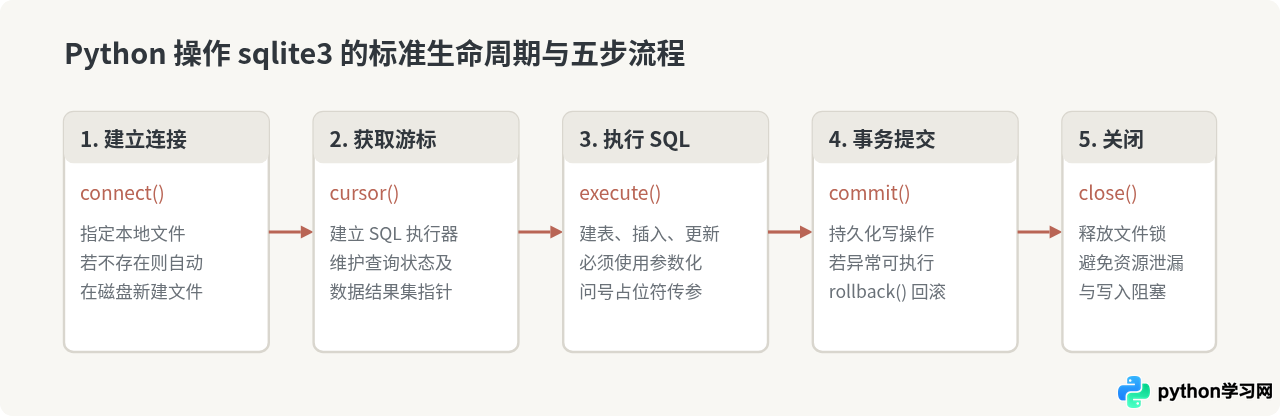
使用 sqlite3 操作本地数据库遵循标准数据库接口生命周期。完整流程可以抽象为五个确定性阶段:导入模块与建立连接、创建游标执行 SQL、提交事务、读取与处理结果、最后关闭资源。
第一步:创建数据库连接与游标
调用 sqlite3.connect("app.db") 时,若当前目录下不存在 app.db,SQLite 会自动创建该文件;若文件已存在,则直接打开。随后通过 conn.cursor() 获取游标对象,用于执行具体 SQL 语句。
第二步:创建数据表
通过执行 DDL 语句定义表结构。为了防止重复建表导致报错,推荐使用 CREATE TABLE IF NOT EXISTS 语法:
import sqlite3

# 1. 建立连接并获取游标
conn = sqlite3.connect("project_records.db")
cursor = conn.cursor()

# 2. 创建用户记录表
cursor.execute("""
CREATE TABLE IF NOT EXISTS users (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    name TEXT NOT NULL,
    email TEXT UNIQUE NOT NULL,
    age INTEGER,
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
)
""")
conn.commit()
第三步:安全插入数据(参数化查询)
在向数据库插入数据时,切忌使用 Python 的字符串格式化(如 f-string 或 %s)直接拼接 SQL。拼接不仅容易因为单引号、换行符引发语法错误,更会直接暴露 SQL 注入漏洞。正确的做法是使用占位符 ?,并将参数作为元组传入:
# 单条数据插入
new_user = ("张三", "zhangsan@example.com", 28)
cursor.execute("INSERT INTO users (name, email, age) VALUES (?, ?, ?)", new_user)
conn.commit()

# 批量数据插入:使用 executemany 高效执行
batch_users = [
    ("李四", "lisi@example.com", 24),
    ("王五", "wangwu@example.com", 31),
    ("赵六", "zhaoliu@example.com", 29)
]
cursor.executemany("INSERT INTO users (name, email, age) VALUES (?, ?, ?)", batch_users)
conn.commit()
第四步:查询与读取数据
执行 SELECT 语句后,可通过游标的 fetchone()、fetchall() 或直接对游标进行迭代来读取记录:
cursor.execute("SELECT id, name, email, age FROM users WHERE age >= ?", (25,))

# 方式一:一次性获取所有结果(返回列表,元素为元组)
rows = cursor.fetchall()
for row in rows:
    print(f"ID: {row[0]}, 姓名: {row[1]}, 邮箱: {row[2]}, 年龄: {row[3]}")
示例输出:
ID: 1, 姓名: 张三, 邮箱: zhangsan@example.com, 年龄: 28
ID: 3, 姓名: 王五, 邮箱: wangwu@example.com, 年龄: 31
ID: 4, 姓名: 赵六, 邮箱: zhaoliu@example.com, 年龄: 29
第五步:更新与删除操作
修改与删除语法同样遵循标准 SQL,执行后需要调用 conn.commit() 确保改动被持久化至磁盘:
# 更新记录
cursor.execute("UPDATE users SET age = ? WHERE name = ?", (25, "李四"))

# 删除记录
cursor.execute("DELETE FROM users WHERE email = ?", ("zhaoliu@example.com",))

# 统一提交修改并关闭连接
conn.commit()
cursor.close()
conn.close()
注意:SQLite 默认开启事务机制。对数据的修改操作(INSERT、UPDATE、DELETE)若不执行 conn.commit(),连接关闭后数据更改将直接丢失。
3. 进阶技巧:行字典转换与上下文管理器
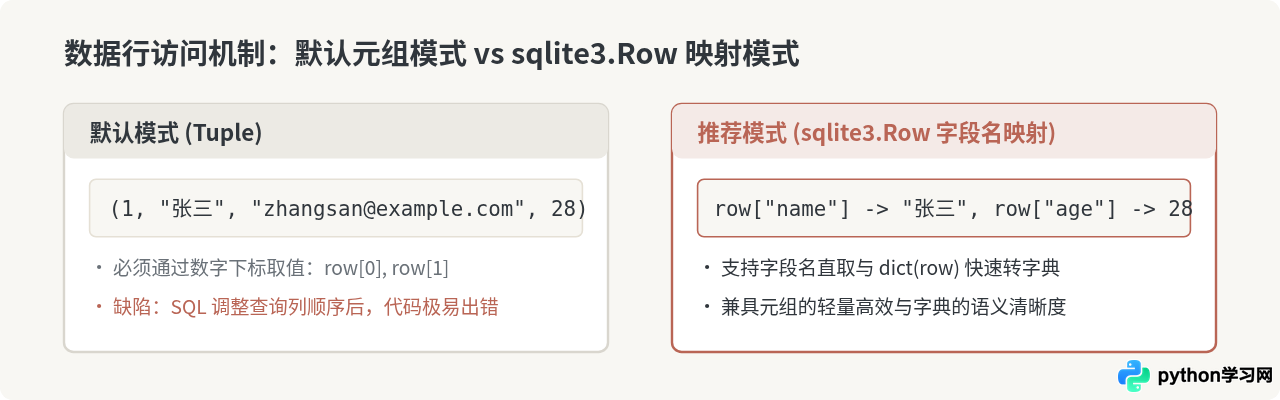
在默认情况下,游标返回的每一行数据都是只包含字段值的普通元组(Tuple),访问字段必须通过 row[0]、row[1] 下标方式,可读性较低。通过配置 conn.row_factory = sqlite3.Row,可以使返回的每行数据既支持索引访问,又支持通过字段名键值访问:
此外,使用 Python 的 with 语句(上下文管理器)管理数据库连接,可以在语句块正常退出时自动提交事务,在发生未捕获异常时自动回滚,大幅提升程序的健壮性:
import sqlite3

# 使用上下文管理器自动管理事务提交与异常回滚
with sqlite3.connect("project_records.db") as conn:
    conn.row_factory = sqlite3.Row  # 开启字段名访问
    cursor = conn.cursor()
    cursor.execute("SELECT id, name, email, age FROM users WHERE id = ?", (1,))
    row = cursor.fetchone()
    if row:
        print(f"用户姓名: {row['name']}, 邮箱地址: {row['email']}")
        # 也可以轻松转为标准 Python 字典
        user_dict = dict(row)
        print("字典数据:", user_dict)
4. 常见问题排查与使用建议
- 数据库被锁定(database is locked):这是 SQLite 最常见的报错。原因通常是另一个线程或进程持有了写锁而未提交/关闭,或者当前程序开启了事务却长时间占用。可以通过在
connect()中设置timeout参数(如sqlite3.connect("app.db", timeout=10.0))增加锁等待重试时间,并养成及时提交或关闭游标的习惯。 - 动态类型特性(Type Affinity):SQLite 采用了弱类型存储机制,即字段类型声明仅作为建议(类型亲和性),即使将文本存入 INTEGER 字段也可能不会报错。因此,在业务逻辑层仍需保持类型检查与校验。
- 内存数据库用于快速测试:若只需在自动化测试或算法验证中临时使用数据库,可传入路径
":memory:"。数据完全常驻内存,速度极快,连接关闭后自动清理,无需清理磁盘临时文件。
5. 总结与决策导图
综上所述,Python 内置的 sqlite3 模块完全省去了依赖管理与环境配置成本。它不仅具备完整的 ANSI-SQL 支持与 ACID 事务保障,而且单文件架构使得打包与分发变得轻巧可靠。
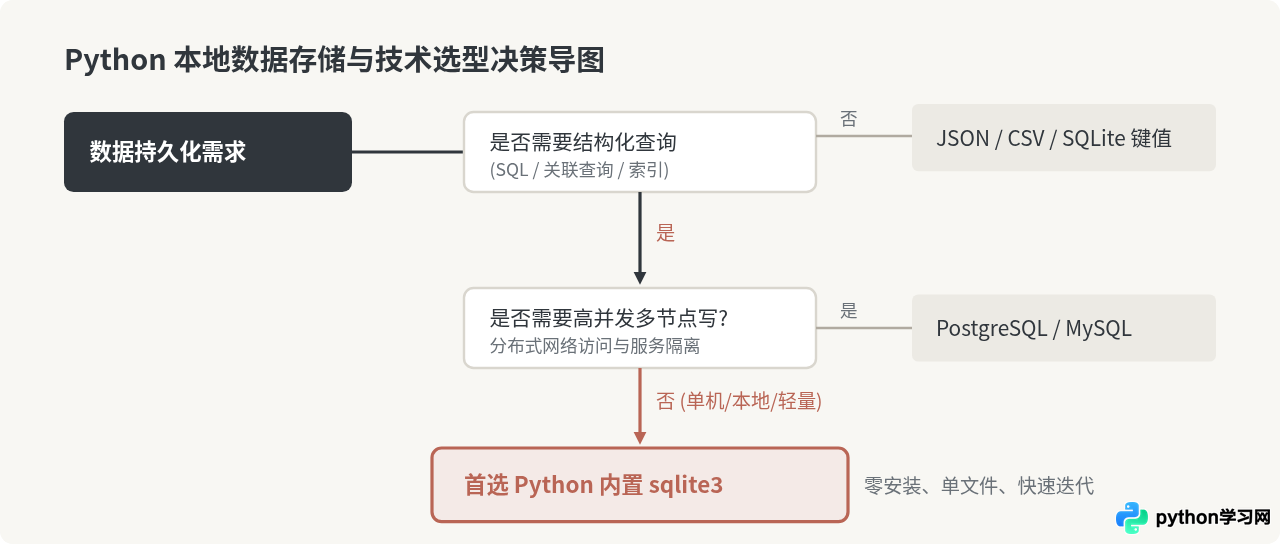
只要合理使用参数化占位符预防 SQL 注入,配合 sqlite3.Row 增强字段语义,并通过上下文管理器做好事务提交与关闭,sqlite3 就能以极高的开发效率和极低的系统开销,为你解决绝大部分中小型项目的本地存储需求。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















