


Python爬虫项目全流程实战:从代码编写到服务器定时部署
系统讲解Python爬虫项目从本地代码编写、数据清洗存储、依赖管理,到Linux服务器虚拟环境配置、Crontab自动化定时调度与日志监控的全流程实战指南。
一、项目全生命周期架构概览
常规的爬虫脚本往往止步于在本地编辑器里按下运行键并看到终端打印数据。然而在生产场景中,任何未捕获的网络抖动、内存泄漏、环境版本漂移或机器重启都会导致采集工作停摆。
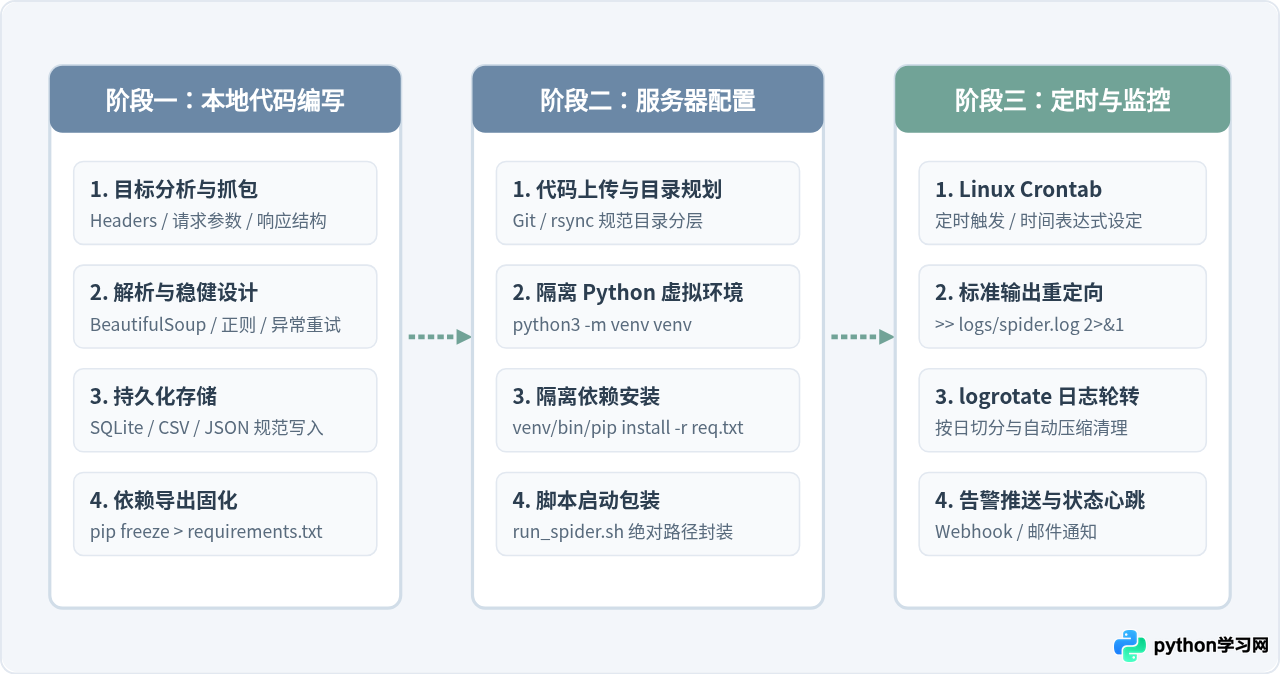
一个完整的爬虫工程闭环包含三个核心阶段:第一阶段是本地代码稳健性设计,包含规范的请求重试、反爬标头管理与结构化本地存储;第二阶段是环境解耦与工程迁移,通过依赖清单与隔离目录杜绝环境冲突;第三阶段是服务器守护与自动化调度,利用 Linux 系统内置的定时服务与日志机制,实现自动触发与故障追溯。
二、编写高健壮性的爬虫核心代码
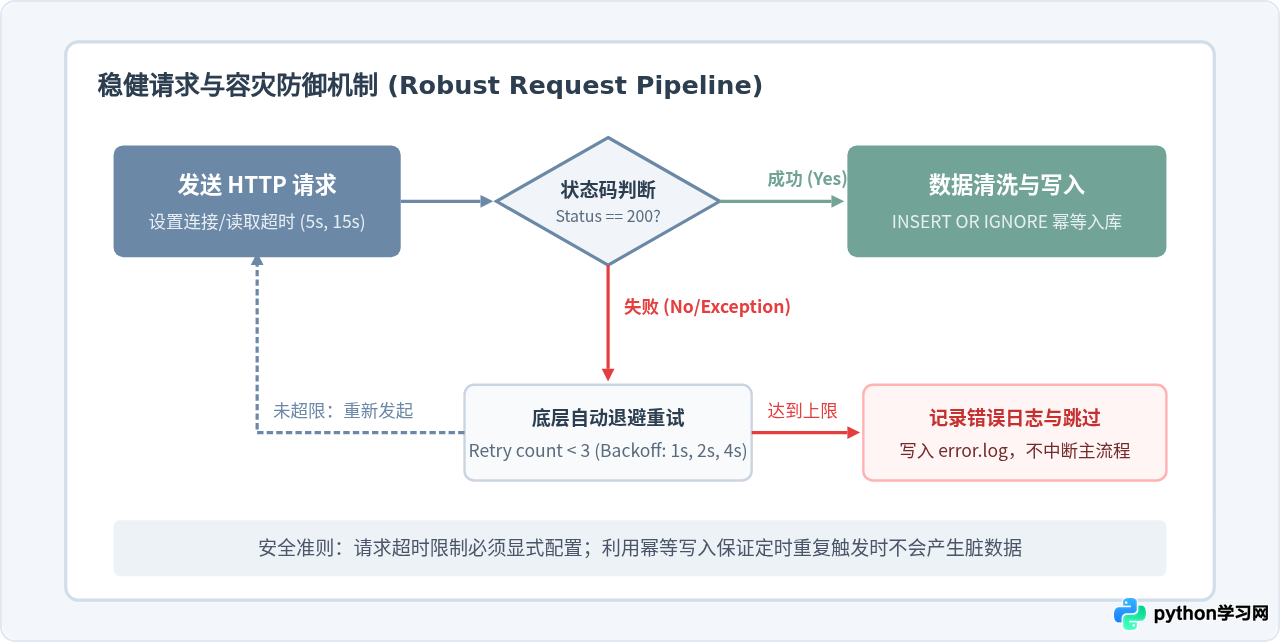
很多初学者在编写爬虫时习惯使用简单的循环配合单次 requests.get(),一旦远端服务器出现 502 错误或响应超时,整个进程就会异常退出。在生产代码中,必须引入超时控制、指数退避重试以及结构化安全落盘机制。
1. 稳健采集模块设计规范
以下是一个经过生产验证的单文件爬虫核心骨架 spider.py。它涵盖了 Session 会话复用、请求头随机轮换、指数退避重试机制以及 SQLite 事务化写入。
import os
import sys
import time
import random
import logging
import sqlite3
import requests
from bs4 import BeautifulSoup
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

# 1. 规范日志配置,保证服务器环境可追溯
LOG_DIR = os.path.join(os.path.dirname(os.path.abspath(__file__)), "logs")
os.makedirs(LOG_DIR, exist_ok=True)
logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] %(message)s",
    handlers=[
        logging.FileHandler(os.path.join(LOG_DIR, "spider.log"), encoding="utf-8"),
        logging.StreamHandler(sys.stdout)
    ]
)

class RobustSpider:
    def __init__(self, db_path="data.db"):
        self.db_path = db_path
        self.session = self._create_robust_session()
        self._init_db()

    def _create_robust_session(self):
        """配置支持连接池与底层重试的 HTTP Session"""
        session = requests.Session()
        retries = Retry(
            total=3,
            backoff_factor=1,
            status_forcelist=[429, 500, 502, 503, 504],
            raise_on_status=False
        )
        adapter = HTTPAdapter(max_retries=retries, pool_connections=10, pool_maxsize=10)
        session.mount("http://", adapter)
        session.mount("https://", adapter)
        session.headers.update({
            "User-Agent": "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
            "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8"
        })
        return session

    def _init_db(self):
        """初始化存储库结构"""
        with sqlite3.connect(self.db_path) as conn:
            cursor = conn.cursor()
            cursor.execute("""
                CREATE TABLE IF NOT EXISTS articles (
                    id TEXT PRIMARY KEY,
                    title TEXT NOT NULL,
                    url TEXT NOT NULL,
                    crawled_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
                )
            """)
            conn.commit()

    def fetch_page(self, url):
        try:
            # 必须设置超时时间,防止进程由于挂起连接而永久假死
            response = self.session.get(url, timeout=(5, 15))
            if response.status_code == 200:
                return response.text
            logging.warning(f"请求非200响应: {response.status_code} URL: {url}")
            return None
        except requests.exceptions.RequestException as e:
            logging.error(f"网络异常导致获取失败: {url}, 错误: {e}")
            return None

    def parse_and_save(self, html_content):
        if not html_content:
            return 0
        soup = BeautifulSoup(html_content, "html.parser")
        items = []
        for item in soup.select(".post-item"):
            title_node = item.select_one(".post-title")
            link_node = item.select_one("a")
            if title_node and link_node:
                post_id = link_node.get("href", "").strip().split("/")[-1]
                items.append((post_id, title_node.get_text(strip=True), link_node.get("href", "")))

        with sqlite3.connect(self.db_path) as conn:
            cursor = conn.cursor()
            cursor.executemany("""
                INSERT OR IGNORE INTO articles (id, title, url)
                VALUES (?, ?, ?)
            """, items)
            conn.commit()
        return len(items)

    def run(self, max_pages=3):
        logging.info("===== 爬虫任务启动 =====")
        total_saved = 0
        for page in range(1, max_pages + 1):
            target_url = f"https://example.com/posts?page={page}"
            logging.info(f"正在抓取第 {page} 页: {target_url}")
            html = self.fetch_page(target_url)
            count = self.parse_and_save(html)
            total_saved += count
            # 随机休眠防封控
            time.sleep(random.uniform(1.5, 3.5))
        logging.info(f"===== 任务完成,累计保存新增记录 {total_saved} 条 =====")

if __name__ == "__main__":
    spider = RobustSpider()
    spider.run()
三、依赖固化与服务器环境搭建
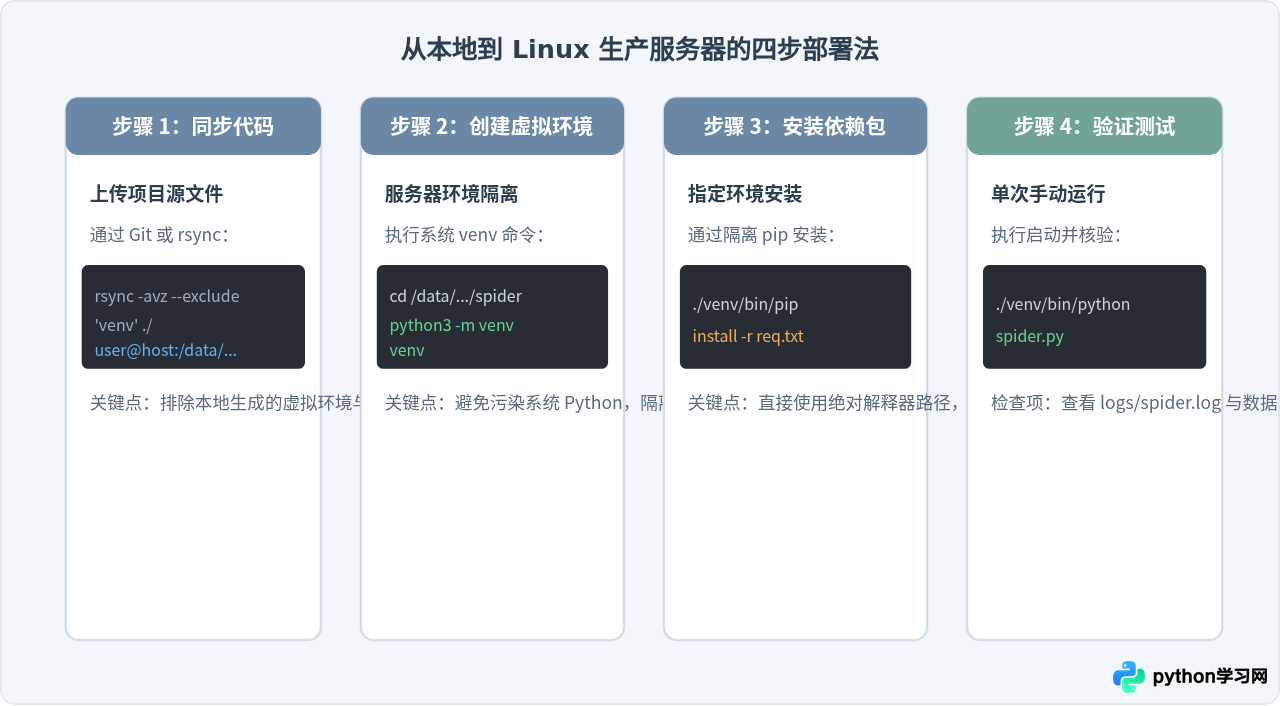
在本地开发时,很多依赖可能直接安装在全局 Python 解释器中。若不进行依赖固化与虚拟环境隔离,部署到服务器后常会出现诸如 ModuleNotFoundError 或版本不兼容等问题。
1. 导出精准依赖文件
在本地项目根目录中,不要盲目使用全局 pip freeze,这会将无关的全局开发包全部导出。建议利用隔离环境或明确记录核心依赖:
# 在本地项目根目录下生成依赖列表
pip freeze > requirements.txt
一个精简清晰的 requirements.txt 示例:
requests==2.31.0
beautifulsoup4==4.12.3
urllib3==2.2.1
2. 服务器规范目录结构
将项目放置在服务器标准的应用程序目录(如 /opt 或 /var/www,个人服务器常用 /data/projects/ 或 ~/projects/)。标准目录规划如下:
/data/projects/my_spider/
├── venv/                 # 独立的 Python 虚拟环境(由服务器本地生成,不提交代码库)
├── logs/                 # 运行日志存放目录
├── data/                 # 数据库或生成的数据文件目录
├── spider.py             # 爬虫核心源码
├── run_spider.sh         # 定时任务执行的包装 Shell 脚本
└── requirements.txt      # 依赖清单
四、编写启动脚本与配置 Crontab 定时调度
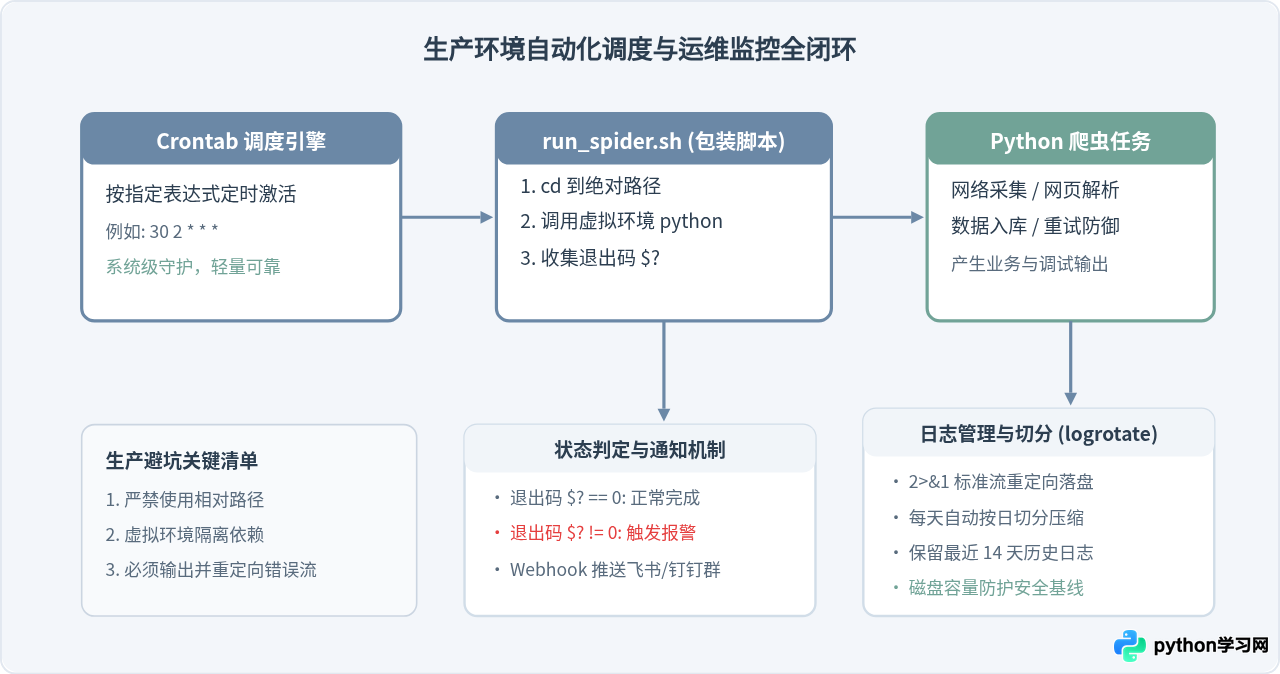
许多开发者在配置 Crontab 时常犯一个错误:直接在 Crontab 中写 python spider.py。这会导致任务执行失败,因为 Crontab 执行时的系统环境变量(PATH)非常匮乏,不仅找不到自定义的 Python,且当前工作目录默认是用户家目录,相对路径读取文件必然抛出 FileNotFoundError。
1. 编写运行包装脚本 run_spider.sh
在项目根目录下创建 run_spider.sh,利用 Shell 脚本明确工作路径与依赖解释器:
#!/bin/bash

# 1. 切换工作目录到爬虫项目根目录(解决相对路径问题)
PROJECT_DIR="/data/projects/my_spider"
cd "$PROJECT_DIR" || exit 1

# 2. 定义虚拟环境 Python 的绝对路径
PYTHON_BIN="$PROJECT_DIR/venv/bin/python"

# 3. 输出任务触发时间戳
echo "=========================================="
echo "Job triggered at $(date '+%Y-%m-%d %H:%M:%S')"
echo "=========================================="

# 4. 执行爬虫主程序
"$PYTHON_BIN" "$PROJECT_DIR/spider.py"

# 5. 捕获并输出退出状态码
EXIT_CODE=$?
echo "Job finished with exit code: $EXIT_CODE"
exit $EXIT_CODE
编写完成后,为脚本赋予执行权限:
chmod +x /data/projects/my_spider/run_spider.sh
2. 配置 Crontab 调度任务
执行 crontab -e 打开当前用户的计划任务配置文件,在文件末尾添加定时任务规则。
Crontab 时间格式由 5 个字段组成:
| 字段 | 含义 | 允许取值 | 示例说明 |
|---|---|---|---|
| 第 1 位 | 分钟 (Minute) | 0 - 59 | 0 表示整点 |
| 第 2 位 | 小时 (Hour) | 0 - 23 | 2 表示凌晨两点 |
| 第 3 位 | 日期 (Day of Month) | 1 - 31 | * 表示每日 |
| 第 4 位 | 月份 (Month) | 1 - 12 | * 表示每月 |
| 第 5 位 | 星期 (Day of Week) | 0 - 7 (0与7均代表周日) | * 表示不限星期 |
假设需要每天凌晨 02:30 自动运行爬虫,且将标准输出与错误输出重定向追加到每日汇总日志中,配置如下:
# 每天凌晨 02:30 执行爬虫脚本
30 2 * * * /data/projects/my_spider/run_spider.sh >> /data/projects/my_spider/logs/cron_output.log 2>&1
>> file.log 表示以追加模式写入标准输出;2>&1 表示将标准错误(文件描述符 2)重定向合并到标准输出(文件描述符 1)。这样无论是 Python 打印的正常日志还是未捕获的报错栈,都会完整记录在日志中。
五、生产级运维:日志轮转与状态监控
爬虫长期运行会产生庞大的日志文件,若不加干涉,单日志文件可膨胀至数 GB 甚至耗尽磁盘空间。此外,定时任务在静默中崩溃往往很难被察觉。建立自动日志轮转与监控告警机制是项目工程化的最后一步。
1. 使用 logrotate 实现日志自动切分与清理
Linux 内置了 logrotate 工具。在系统 /etc/logrotate.d/ 目录下创建配置文件 spider_logrotate:
/data/projects/my_spider/logs/*.log {
    daily
    missingok
    rotate 14
    compress
    delaycompress
    notifempty
    copytruncate
}
daily: 每天轮转切分一次。rotate 14: 最多保留 14 天的归档日志,逾期自动清理。compress: 旧日志启用 gzip 压缩,大幅节约磁盘。copytruncate: 在切分时复制原文件并截断,避免因文件句柄占用导致 Python 进程无法继续写入日志。
六、项目上线后的检查与维护清单
在项目正式交付进入无人值守状态前,建议对照以下检查清单进行逐项核实:
- 时区一致性检查:通过
date命令确认服务器系统时区是否为Asia/Shanghai(CST)。若服务器默认为 UTC 时区,会导致定时任务与预期的本地时间偏差 8 小时。 - 反爬虫频率与礼貌限制:检查代码中的休眠时间间隔与并发线程数。切忌无间隔狂刷,遵循目标站点的
robots.txt规范,避免被目标服务器直接屏蔽 IP。 - Crontab 权限与环境变量:确保编辑 Crontab 的用户拥有读写项目目录及数据库文件的读写权限。在调试定时任务时,可先配置每两分钟执行一次(
*/2 * * * *),确认日志正常生成且有数据写入后再改为目标运行时间。 - 数据清理与备份:若数据持续增长,应定期配置备份脚本将数据库快照归档至冷存储或远程对象存储中。
通过以上全流程的标准化实施,Python 爬虫便脱离了脆弱的本地手动调试模式,演进为具备独立容错、自主调度、完整审计与日志维护能力的稳健数据采集服务。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















