


Python数据类型分哪两大类:可变与不可变类型详解
深入解析Python数据类型的两大核心分类:可变类型与不可变类型。通过内存模型原理、验证方法、代码示例与图解,系统掌握两者的区别及开发中的避坑要点。
在 Python 中,所有数据都是以对象的形式存在的,而根据对象创建后其内部状态与值是否允许被直接修改,Python 的内置数据类型被严格划分为两大类:不可变类型(Immutable Types)与可变类型(Mutable Types)。理解这一核心划分机制,是写出健壮代码、规避参数传递陷阱与准确掌握内存管理的关键基础。
一、核心机制:什么是可变与不可变?
在 Python 运行环境中,每一个对象在内存中都由三个核心要素构成:身份标识(Identity,由内存地址决定,可通过 id() 获取)、数据类型(Type,决定对象支持的操作,可通过 type() 获取)以及数值内容(Value)。
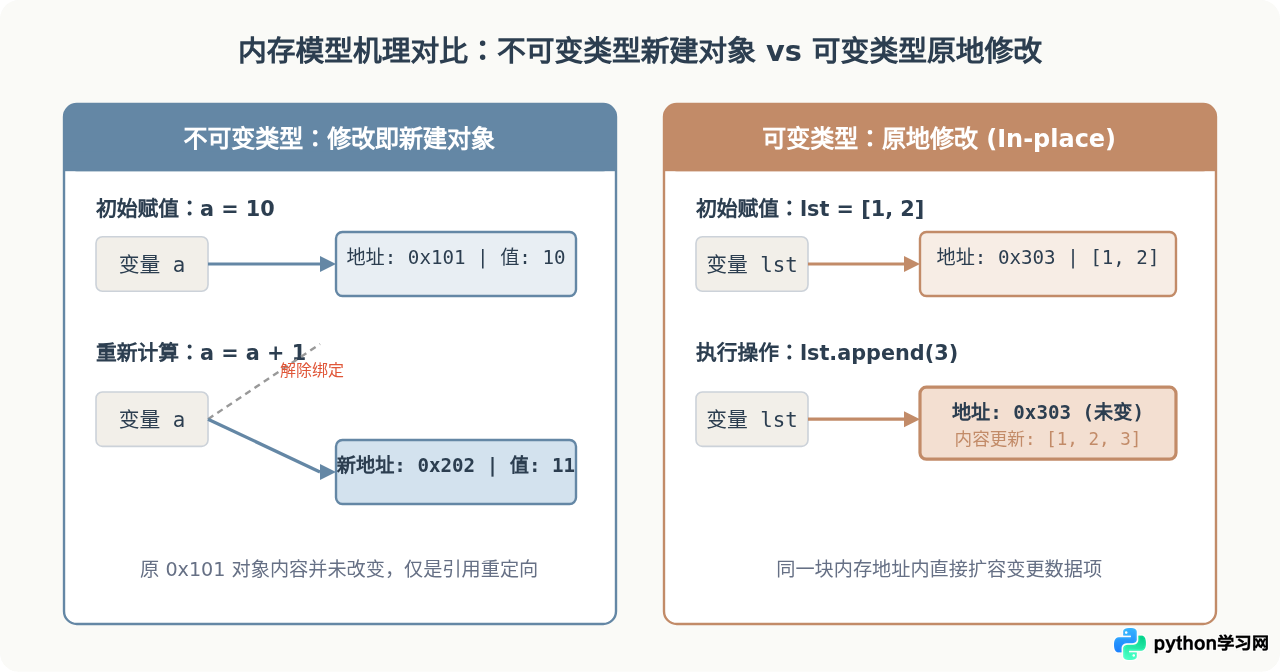
区分可变与不可变的核心标准,在于“当尝试修改其内容时,该对象的内存地址是否发生变化”:
- 不可变类型(Immutable):对象一旦在内存中分配,其包含的值就不能被原地改变。如果对该变量进行修改操作(如重新赋值或字符串拼接),Python 解释器并不会修改原内存区域中的内容,而是开辟一块新的内存地址存放新值,并将变量重新指向这个新地址。原对象若无其他引用,将由垃圾回收器回收。
- 可变类型(Mutable):对象创建后,其在内存中的地址保持不变,但允许通过其内置方法(如追加、删除或键值替换)在原内存空间内直接修改其包含的数据元素。这种修改方式被称为就地修改(In-place Modification)。
二、Python 数据类型归属分类清单
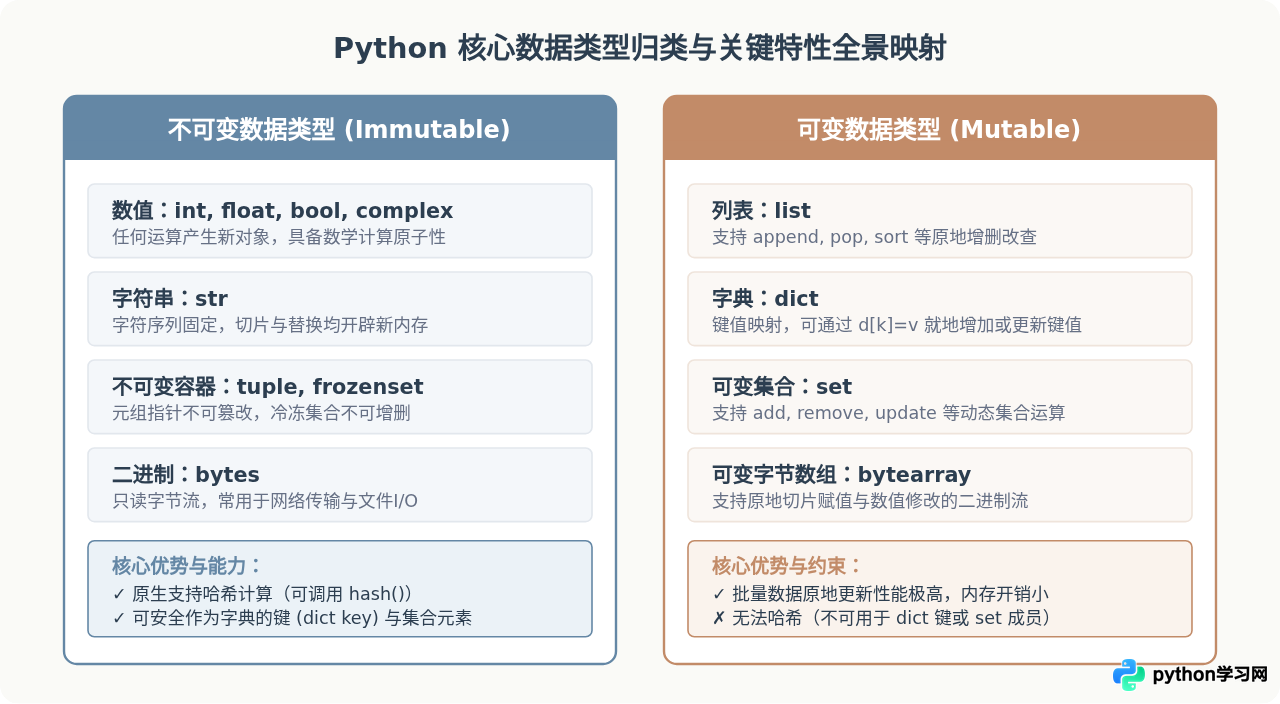
在日常开发中,常用的内置数据类型可明确归入以下两个阵营:
1. 不可变类型清单
- 数值类型(Number):包含整型
int、浮点型float、复数complex和布尔型bool。数值运算产生的新结果均存放在新对象中。 - 字符串(str):字符的有序不可变序列。任何字符串的
replace()、strip()、upper()等方法均返回全新字符串对象,原字符串绝不改变。 - 元组(tuple):不可变的通用序列。元组中各个元素引用的指针在创建后即被锁定,不支持元素的增、删、改。
- 冻结集合(frozenset):集合的不可变版本,具备集合的唯一性特性,但不能添加或删除元素。
- 字节序列(bytes):由不可变二进制字节组成的序列,用于处理原始数据。
2. 可变类型清单
- 列表(list):有序可变的通用序列。提供
append()、extend()、insert()、pop()等就地修改方法。 - 字典(dict):键值对构成的无序(Python 3.7+ 保证插入顺序)可变映射容器。可通过键直接赋值、修改或删除键值对。
- 集合(set):无序且不重复的元素容器。提供
add()、remove()、discard()等方法直接操作内部元素集合。 - 字节数组(bytearray):
bytes的可变对等物,支持原地修改二进制字节。
3. 特性对比总览
| 类型类别 | 典型代表 | 能否原地修改内容 | 哈希支持(可否被 hash() 计算) | 能否作为 dict 的 Key |
|---|---|---|---|---|
| 不可变类型 | int, str, tuple, frozenset |
否(修改生成新对象) | 是(元素亦需不可变) | 可以 |
| 可变类型 | list, dict, set, bytearray |
是(直接在原地址更新) | 否(报 TypeError: unhashable) | 禁止(会报错) |
三、实操演练:如何验证数据类型的可变性?
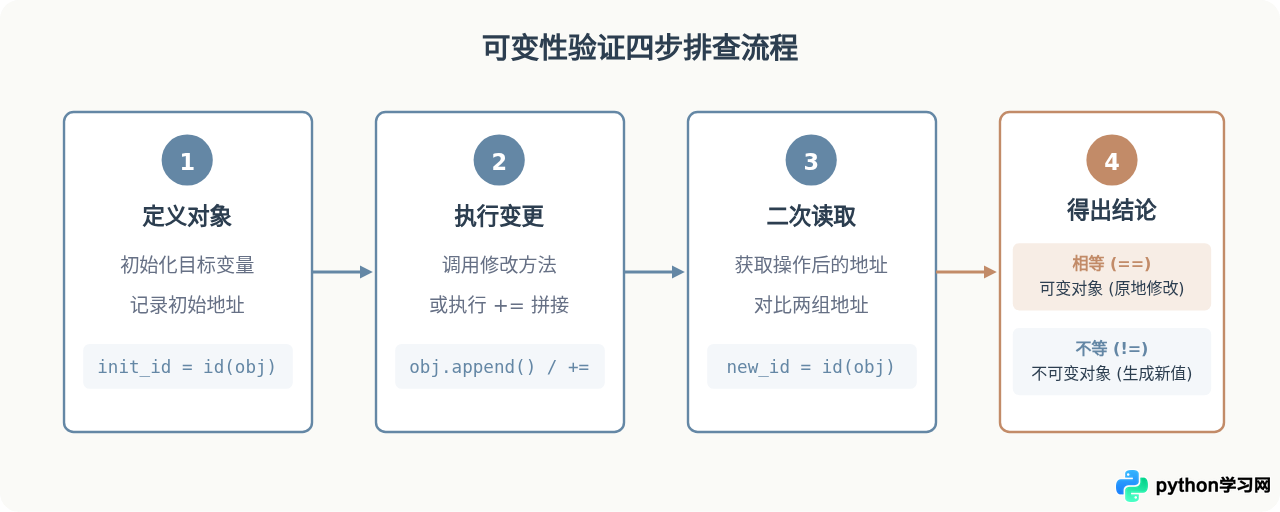
验证一个对象是可变还是不可变,核心手段是观察变更操作前后的内存地址(id())是否一致,或使用 is 关键字比对对象身份。
1. 验证不可变类型示例:字符串与整数
以下代码展示对字符串执行拼接操作时,内存地址的变化:
# 示例代码:验证字符串的不可变性
text = "hello"
addr_before = id(text)
print(f"修改前内容: {text}, 内存地址: {addr_before}")

# 进行拼接赋值
text += " world"
addr_after = id(text)
print(f"修改后内容: {text}, 内存地址: {addr_after}")
print(f"地址是否相同: {addr_before == addr_after}")修改后内容: hello world, 内存地址: 140321749822448
地址是否相同: False
从输出中可以清晰看到,对 text 拼接后,内存地址发生了变化。原有的 "hello" 对象并未被修改,解释器创建了一个新的 "hello world" 对象并将 text 变量指向该新对象。
2. 验证可变类型示例:列表
通过对比列表的 append() 方法操作前后的地址,验证就地修改特性:
# 示例代码:验证列表的可变性
numbers = [1, 2, 3]
addr_before = id(numbers)
print(f"修改前列表: {numbers}, 内存地址: {addr_before}")

# 就地追加元素
numbers.append(4)
addr_after = id(numbers)
print(f"修改后列表: {numbers}, 内存地址: {addr_after}")
print(f"地址是否相同: {addr_before == addr_after}")修改后列表: [1, 2, 3, 4], 内存地址: 140321749673984
地址是否相同: True
列表在追加元素后,内存地址完全一致,确认其为原地修改的可变类型。
四、实际开发中的三大核心陷阱与注意事项
陷阱一:元组中包含可变对象(不可变的相对性)
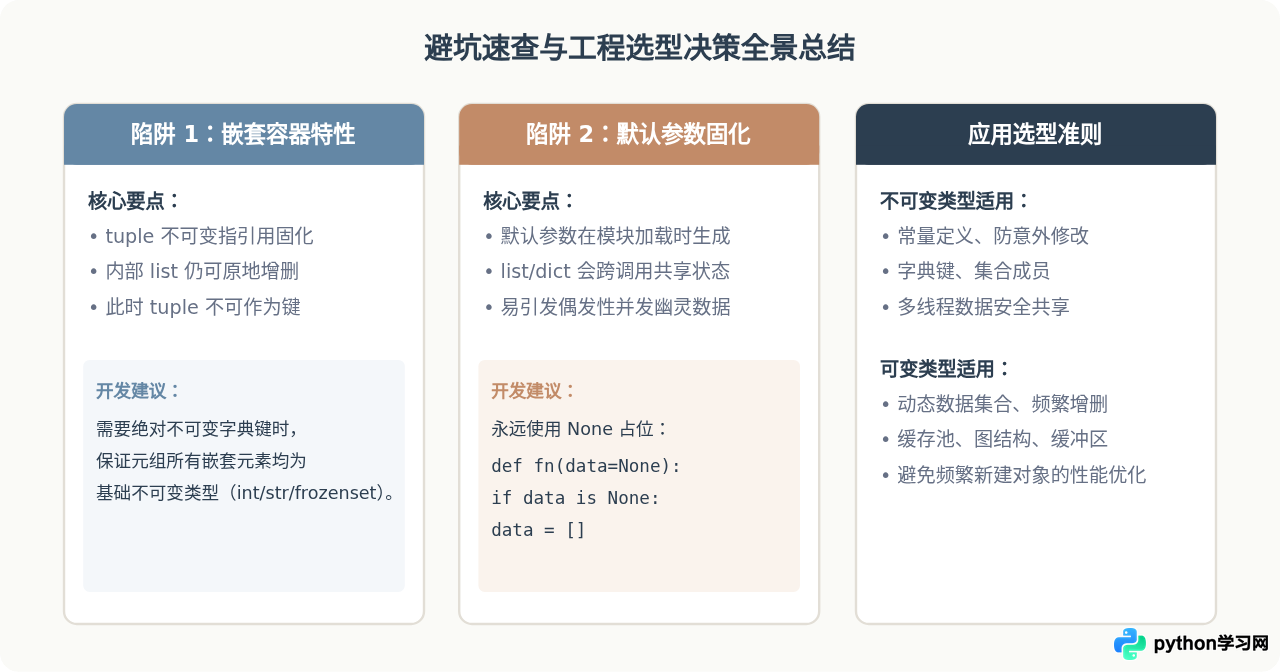
元组本身是不可变类型,意味着元组内部存放的元素引用指针无法被替换。但如果元组内某个元素是可变对象(例如列表),那么该列表本身所包含的数据是可以被改变的。
# 示例代码:元组内的可变元素修改
nested_tuple = ("admin", [80, 90])
print(f"初始元组: {nested_tuple}")

# 尝试替换元组元素会抛出异常
try:
    nested_tuple[0] = "root"
except TypeError as e:
    print(f"直接修改元组元素报错: {e}")

# 但修改列表中间的内容是完全允许的
nested_tuple[1].append(100)
print(f"修改列表后元组: {nested_tuple}")直接修改元组元素报错: 'tuple' object does not support item assignment
修改列表后元组: ('admin', [80, 90, 100])
此时元组内部保存的列表引用地址并没有发生变动,变动的是该列表自身维护的内部存储。这也是为什么包含可变对象的元组不能作为字典的键(因为无法计算稳定的哈希值)。
陷阱二:函数的默认参数陷阱
在定义函数时,如果将默认参数指定为可变对象(如 def func(data=[])),该默认参数对象仅在函数定义时创建一次,而不是每次函数调用时新建。
# 错误示例:使用可变对象作为默认参数
def add_user(name, user_list=[]):
    user_list.append(name)
    return user_list

print(add_user("Alice"))  # 输出 ['Alice']
print(add_user("Bob")) # 预期 ['Bob'],实际输出 ['Alice', 'Bob']!正确写法:使用 None 作为默认值,在函数体内部按需初始化。
# 正确规范写法
def add_user_safe(name, user_list=None):
    if user_list is None:
        user_list = []
    user_list.append(name)
    return user_list
陷阱三:赋值引用与浅拷贝、深拷贝
在 Python 中,直接使用等号赋值(b = a)仅仅是创建了一个新引用指向同一个对象。当 a 是可变对象时,修改 b 会直接联动影响 a。若需要解绑关系,需要使用 copy 模块进行浅拷贝或深拷贝:
b = a.copy()或copy.copy(a):浅拷贝,仅复制顶层容器,容器内的子对象依然共享引用。b = copy.deepcopy(a):深拷贝,递归复制容器及其中所有各层级的子对象,完全实现内存物理隔离。
五、全文总结
归结起来,Python 将数据类型划分为可变与不可变两大体系,背后是内存安全性与操作效率的权衡:
- 不可变类型(数值、str、tuple、frozenset、bytes):修改即开辟新内存并重定向指针,天生具备线程安全性和哈希稳定性,适合用作常量、字典键及防篡改的数据传递。
- 可变类型(list、dict、set、bytearray):修改在原内存地址原地完成,执行效率高且避免重复创建内存开销,适合在需要频繁增删查改的数据处理场景中使用。
在编写代码时,结合 id() 识别对象本质,并在函数参数、对象赋值及元组使用中谨防共享引用问题,便能够自如驾驭 Python 的对象模型。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















