


MySQL事务与索引核心机制解析

本文详细解析MySQL数据库的核心组件:事务机制与索引策略。内容涵盖事务的ACID特性、并发隔离级别(如可重复读)对数据一致性的影响,以及InnoDB与MyISAM在B+树索引结构上的本质差异。通过理解脏读、不可重复读等并发问题及索引设计准则,帮助开发者有效优化查询性能并保障数据完整性。
一、MySQL事务机制
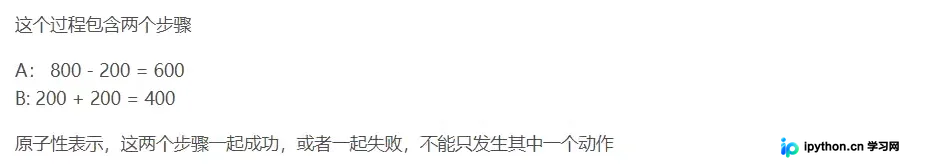
事务是逻辑上的一组操作,这些操作作为一个整体执行,要么全部成功提交,要么全部失败回滚。例如在银行转账场景中,从账户A扣除200元与向账户B增加200元必须作为一个原子操作,确保资金总额不变。若其中一个步骤失败,整个事务应回退到初始状态。
事务的ACID四大特性
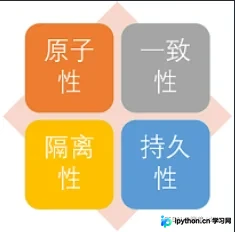
事务处理的核心依赖于ACID原则,这是保证数据库稳定运行的基石。
- 原子性 (Atomicity):事务是最小的执行单元,不可分割。它确保事务中的所有操作要么全部完成,要么完全不起作用。任何中间状态的失败都会导致事务回滚。
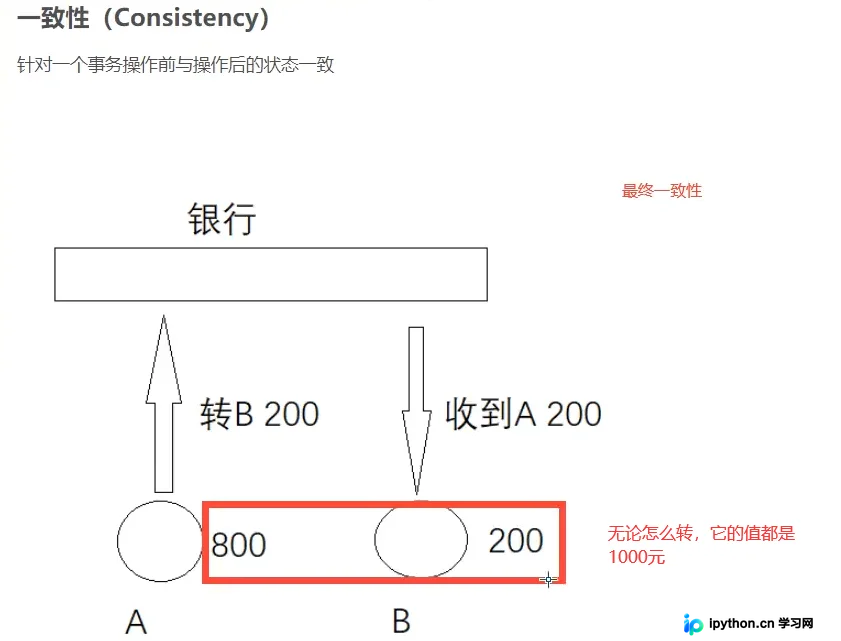
- 一致性 (Consistency):事务执行前后,数据必须保持一致性状态。即事务不能破坏数据库的完整性约束,多个并发事务对同一数据的读取结果应符合预期逻辑。
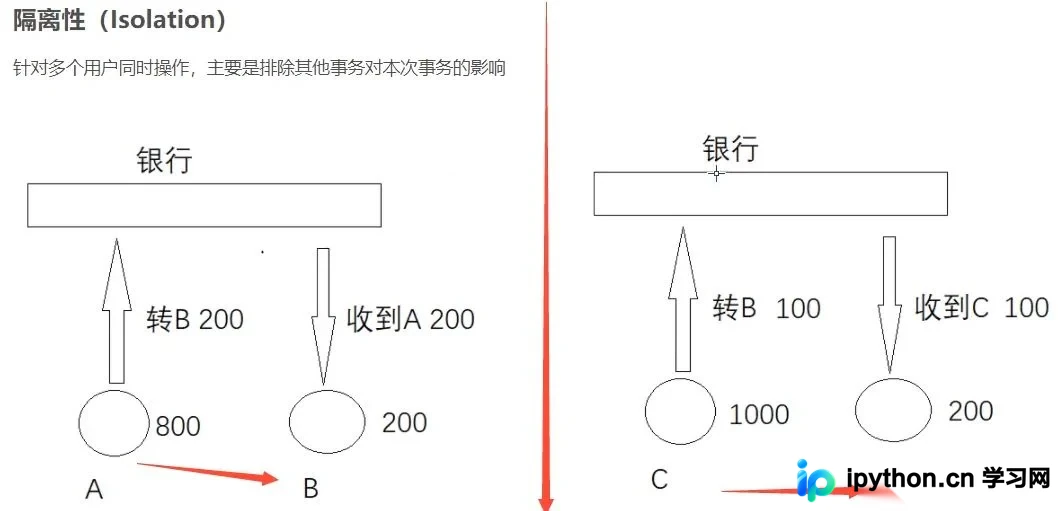
- 隔离性 (Isolation):在并发访问时,一个用户的事务不应被其他事务干扰,各事务之间应当相互独立,如同串行执行一般。
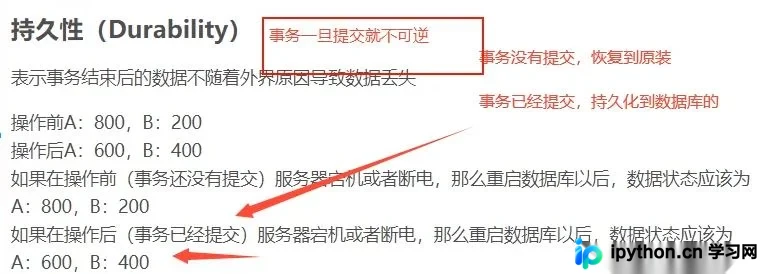
- 持久性 (Durability):一旦事务提交,其对数据库中数据的修改就是永久性的,即使后续发生系统故障(如断电、崩溃),数据也不会丢失。
事务的最终成功提交意味着所有更改已持久化存储。
并发事务带来的问题
当多个事务并发运行且操作相同数据时,缺乏适当隔离可能导致以下异常:
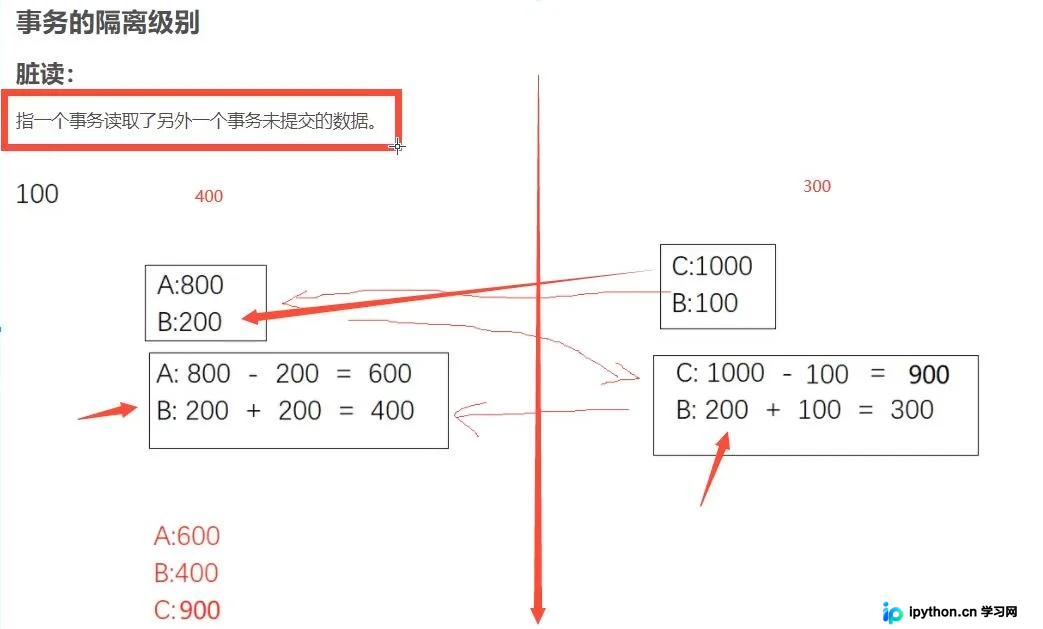
- 脏读 (Dirty Read):一个事务读取了另一个事务尚未提交的“中间状态”数据。若后续该事务回滚,第一个事务读取的数据即为无效数据(脏数据),基于此做出的操作是错误的。
- 丢失修改 (Lost Update):两个事务同时读取同一数据并进行修改。后提交的事务会覆盖先提交事务所做的修改,导致先前的修改结果丢失。例如,两笔交易同时基于余额20元各扣1元,最终余额可能错误地变为19元而非18元。
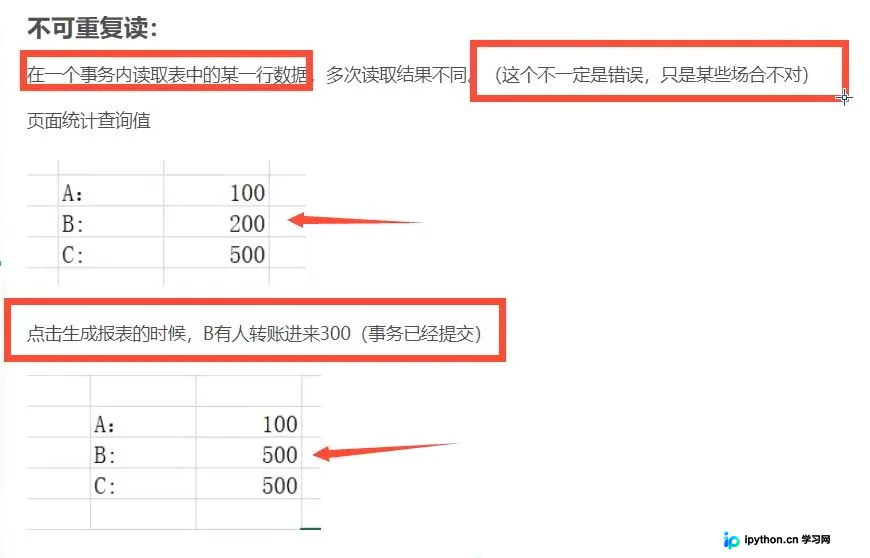
- 不可重复读 (Non-repeatable Read):在同一事务内,多次读取同一字段的结果不一致。这是因为在第一次读取后,另一个并发事务修改并提交了对该字段的更改,导致当前事务再次读取时数据发生变化。
- 幻读 (Phantom Read):在一个事务内,两次查询范围条件相同的数据集,但结果行数不同。通常是因为另一个并发事务在该事务执行期间插入了符合查询条件的新记录,导致前一个事务感觉像是出现了“幻影”。
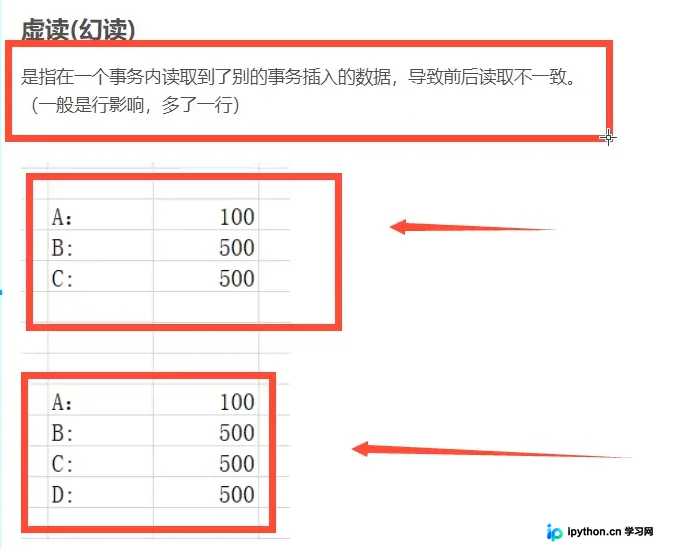
区别辨析:不可重复读侧重于“行内列值”的修改,即多次读取同一条记录的某些列发现值变了;幻读侧重于“行数量”的变化,即多次查询发现记录条数因插入或删除而增减。
事务隔离级别
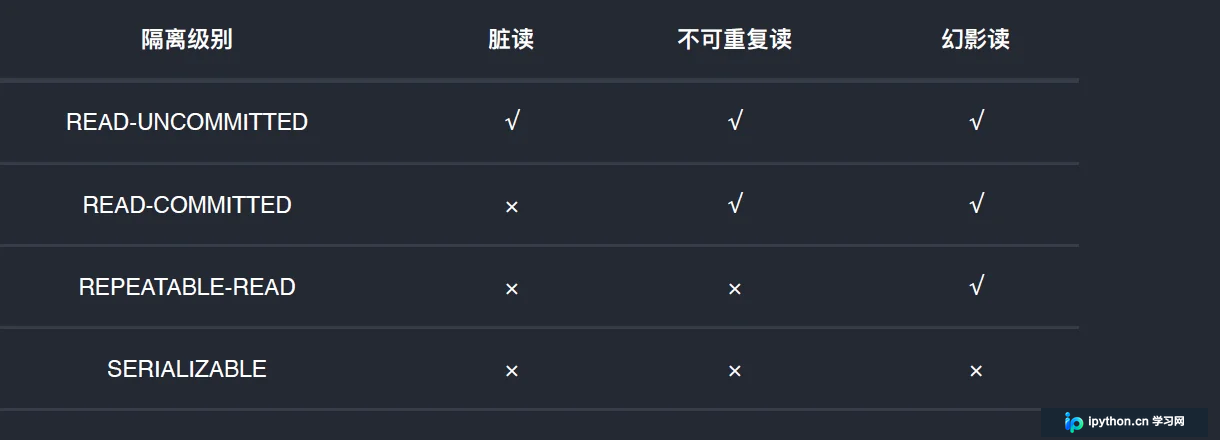
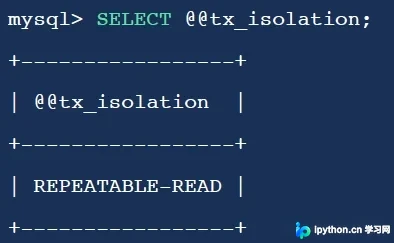
SQL标准定义了四种隔离级别,用于解决上述并发问题。MySQL InnoDB默认使用 REPEATABLE-READ(可重复读)。
READ-UNCOMMITTED(读取未提交):最低级别,允许读取未提交的数据。可能发生脏读、不可重复读和幻读。READ-COMMITTED(读取已提交):只允许读取已提交的数据。可防止脏读,但无法防止不可重复读和幻读。REPEATABLE-READ(可重复读):确保同一事务内多次读取同一数据结果一致。可防止脏读和不可重复读,但在标准SQL下仍可能存在幻读(InnoDB通过MVCC和Next-Key Lock优化了大部分情况)。SERIALIZABLE(可串行化):最高级别,强制事务串行执行。可完全防止脏读、不可重复读和幻读,但并发性能最低。
可通过 SQL 命令查看当前会话或全局的隔离级别:
二、MySQL索引详解
索引是帮助MySQL高效获取数据的数据结构。其本质是一种特殊的数据组织形式。MySQL主要支持两种索引结构:哈希索引和B树索引。哈希索引适合单条记录的精确查询,速度极快但不适合范围查询;而在大多数生产环境中,B+Tree索引因其优秀的范围查询能力和平衡性成为主流选择。
存储引擎与索引结构差异
不同的存储引擎对索引的实现方式存在显著差异,理解这一点对于性能优化至关重要:
- MyISAM:采用非聚簇索引。索引文件和数据文件分离。B+树的叶子节点(Data域)存储的是数据记录的物理地址。检索时需先查索引找到地址,再根据地址回表查询数据,这被称为“二次查找”。(注:MyISAM已不再作为主流推荐引擎)
- InnoDB:采用聚簇索引(聚集索引)。表数据文件本身就是按B+Tree组织的主索引结构,叶子节点存储完整的数据记录。主键即为索引Key。其他非主键索引为辅助索引,叶子节点仅存储主键值。因此,在InnoDB中根据主键查询只需一次IO,而根据辅助索引查询需先拿到主键再走一遍主索引(“回表”)。为避免频繁分裂,不建议使用过长或非单调字段作为主键。
索引的作用与分类
主要作用:
- 显著提高数据查询速度。
- 通过唯一索引确保数据的唯一性。
- 加速表与表之间的连接,实现参照完整性约束。
- 大幅减少GROUP BY和ORDER BY操作的分组与排序时间。
- 支持全文检索优化。
常见分类:
- 主键索引 (Primary Key):标识表中的每一行,不可重复且非空,每个表只能有一个。
- 唯一索引 (Unique):避免重复列出现,值必须唯一,但允许有空值(NULL),一个表可有多个。
- 常规索引 (Index/Key):最基本的索引类型,无限制条件。
- 全文索引 (FullText):用于在大规模文本中快速定位关键词。传统上主要在MyISAM中支持,较新版本的InnoDB也支持。
索引的设计准则
- 并非越多越好:索引虽然提升查询速度,但会降低写入(Insert/Update/Delete)效率,因为每次修改都需要更新索引。
- 避免高频变动字段加索引:频繁更新的字段会导致索引页频繁分裂和重组,消耗大量资源。
- 小数据量无需索引:对于数据量极小的表,全表扫描的速度可能与索引查找相当,甚至更快。
- 选择合适字段:索引应建立在经常用于WHERE过滤、JOIN关联和ORDER BY排序的字段上。
索引数据结构底层逻辑
在创建索引时,可以指定具体的索引类型,不同存储引擎的支持情况如下:
-- 常用索引类型说明
-- Hash索引:适合等值查询,速度快;不适合范围查询,无序。
-- BTree(B+Tree)索引:层数随数据量指数级增长,IO次数少;支持范围查询、排序,是InnoDB默认且最常用的索引。
各引擎索引支持对照:
- InnoDB:支持事务、行锁。支持 B-tree、Full-text(新版);不支持 Hash 索引。
- MyISAM:不支持事务、表锁。支持 B-tree、Full-text;不支持 Hash 索引。
- Memory:不支持事务、表锁。支持 B-tree、Hash;不支持 Full-text。
- NDB:支持事务、行锁。支持 Hash;不支持 B-tree、Full-text。
- Archive:不支持事务、表锁。不支持 B-tree、Hash、Full-text,主要用于存归档日志。
总结
掌握MySQL事务的ACID特性和隔离级别,是保障业务数据一致性的关键;而深入理解InnoDB的聚簇索引原理及B+树结构,则是进行SQL调优和表结构设计的核心能力。合理运用索引并结合适当的隔离级别,能有效提升系统的高并发处理能力和响应速度。以上就是关于MySQL数据库事务和索引详解的详细内容,更多关于MySQL数据库优化配置的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















