



面对 50 万行以上的 C/C++ 项目,真正难的往往不是“能不能编译过”,而是运行起来之后到底走了哪些路径、跨了哪些模块、在哪一层开始变慢。`-finstrument-functions` 的价值,就在于它能让编译器自动为函数入口和出口加上探针,把原本只能靠断点一点点追的调用关系,变成可持续收集的运行时日志。
下面按“为什么值得用、底层怎么工作、最小可用实现怎么落地、性能和工程化怎么控制”的顺序展开。看完你可以判断两件事:一是这套方法是否适合你当前的项目规模与诊断目标,二是怎样避免递归、乱序、性能暴涨这类常见坑。
为什么在复杂 C/C++ 项目里用它
维护大型遗留项目时,最常见的问题不是单个函数看不懂,而是调用链太深、模块边界太多,静态阅读很难还原真实执行路径。尤其在以下场景里,传统方法成本会迅速升高:
- 函数调用层级深达 20+ 层
- 跨模块交互逻辑复杂
- 运行时行为难以静态分析
- 文档缺失或与实际代码脱节
和 GDB、静态分析、手写业务日志相比,这类编译期插桩有几个直接优势:
- 无需修改业务代码,侵入性低
- 可以自动记录运行时函数调用栈
- 日志可继续转换为调用图、火焰图等可视化结果
- 能够扩展到时间统计、热路径分析、内存问题排查
当然,它不是零成本方案。源文中明确提到,生产环境性能下降可达 300%,因此更适合作为调试、测试、诊断和 CI 分析工具,而不是默认常驻在线上环境。
底层原理:编译器插桩、符号解析与调用栈管理
编译器如何自动插入探针
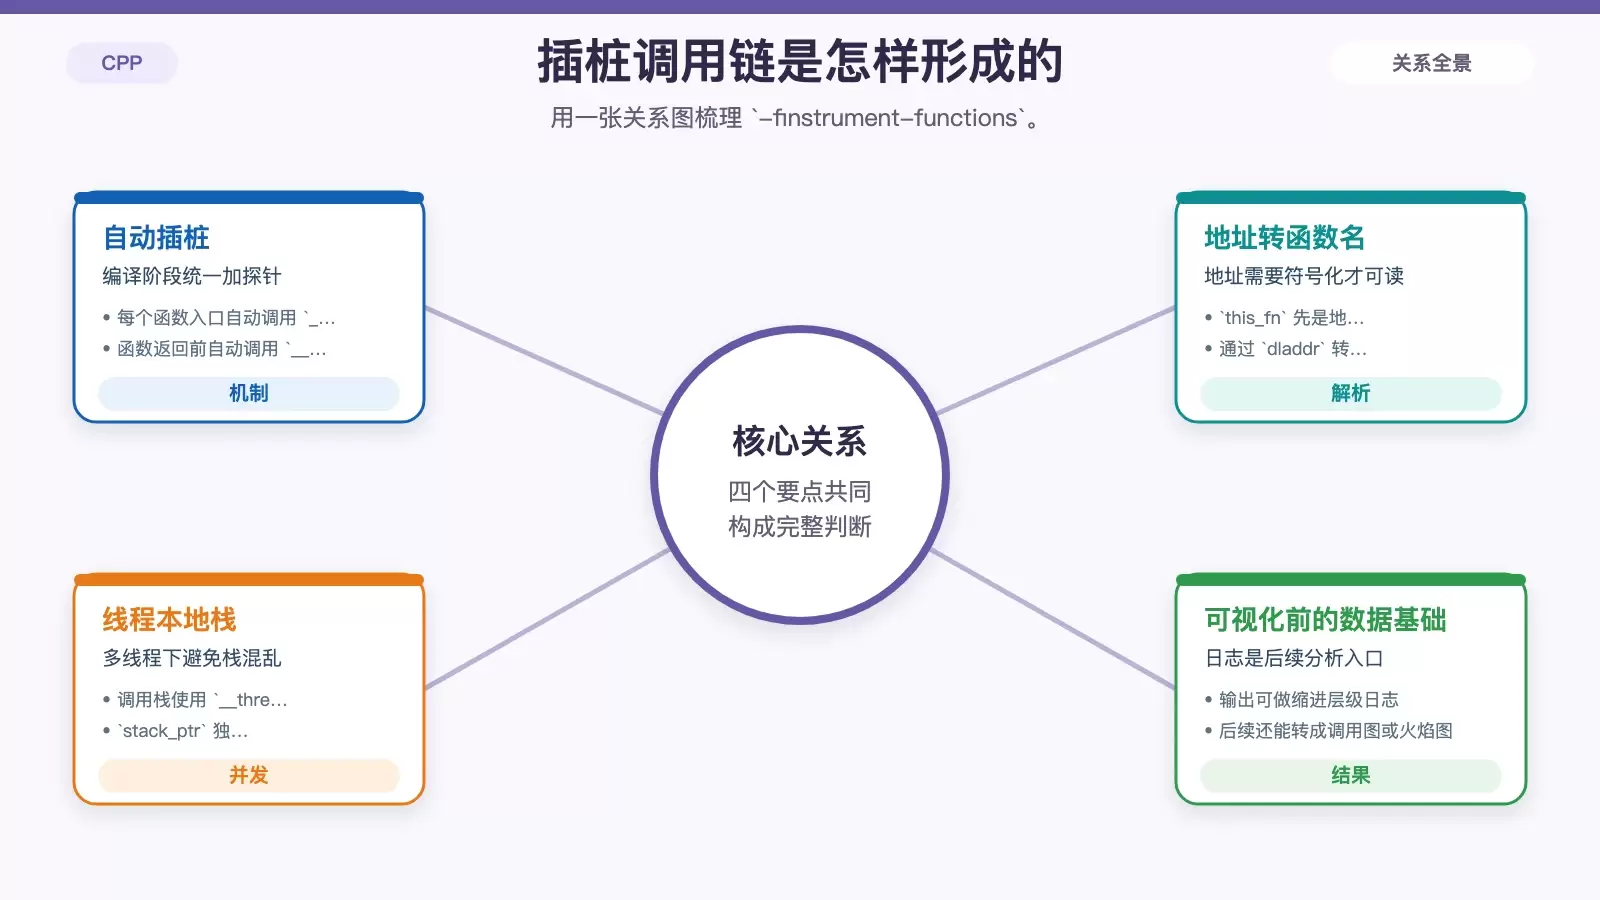
GCC 的 -finstrument-functions 会在编译阶段,为每个函数自动插入入口和出口回调。效果可以理解为:
// 编译后函数伪代码示意
void original_function() {
    __cyg_profile_func_enter(this_fn, call_site);
    /* 原函数体 */
    __cyg_profile_func_exit(this_fn, call_site);
}
这意味着你不需要手动改每个函数,也不用在业务代码里加日志。只要目标代码以这个选项重新编译,探针就会统一生效。
为什么还要配合 dladdr
探针函数拿到的首先是地址,而不是可读的函数名。要把 this_fn 这种地址转成符号,通常要借助 dladdr:
typedef struct {
    const char *dli_fname;  // 文件路径
    void       *dli_fbase;  // 加载基址
    const char *dli_sname;  // 符号名称
    void       *dli_saddr;  // 符号地址
} Dl_info;

int dladdr(void *addr, Dl_info *info);
有了它,日志里就不再只是裸地址,而可以显示为 SSL_connect、malloc 之类的函数名。如果符号缺失,常见现象就是输出为 ??,后文会给出处理办法。
调用栈为什么要用线程本地存储
如果程序是多线程的,所有线程共用一个全局栈几乎一定会乱。更稳妥的方式是为每个线程维护独立调用栈:
#define MAX_DEPTH 128
static __thread void *stack[MAX_DEPTH];
static __thread int stack_ptr = 0;

void push_call(void *addr) {
    if (stack_ptr < MAX_DEPTH)
        stack[stack_ptr++] = addr;
}

void *pop_call() {
    return (stack_ptr > 0) ? stack[--stack_ptr] : NULL;
}
__thread 让每个线程拥有自己的 stack 和 stack_ptr,这样缩进层级、耗时记录和日志组织才不会互相污染。
最小可用实现:Linux 下怎样把日志打出来
基础插桩代码
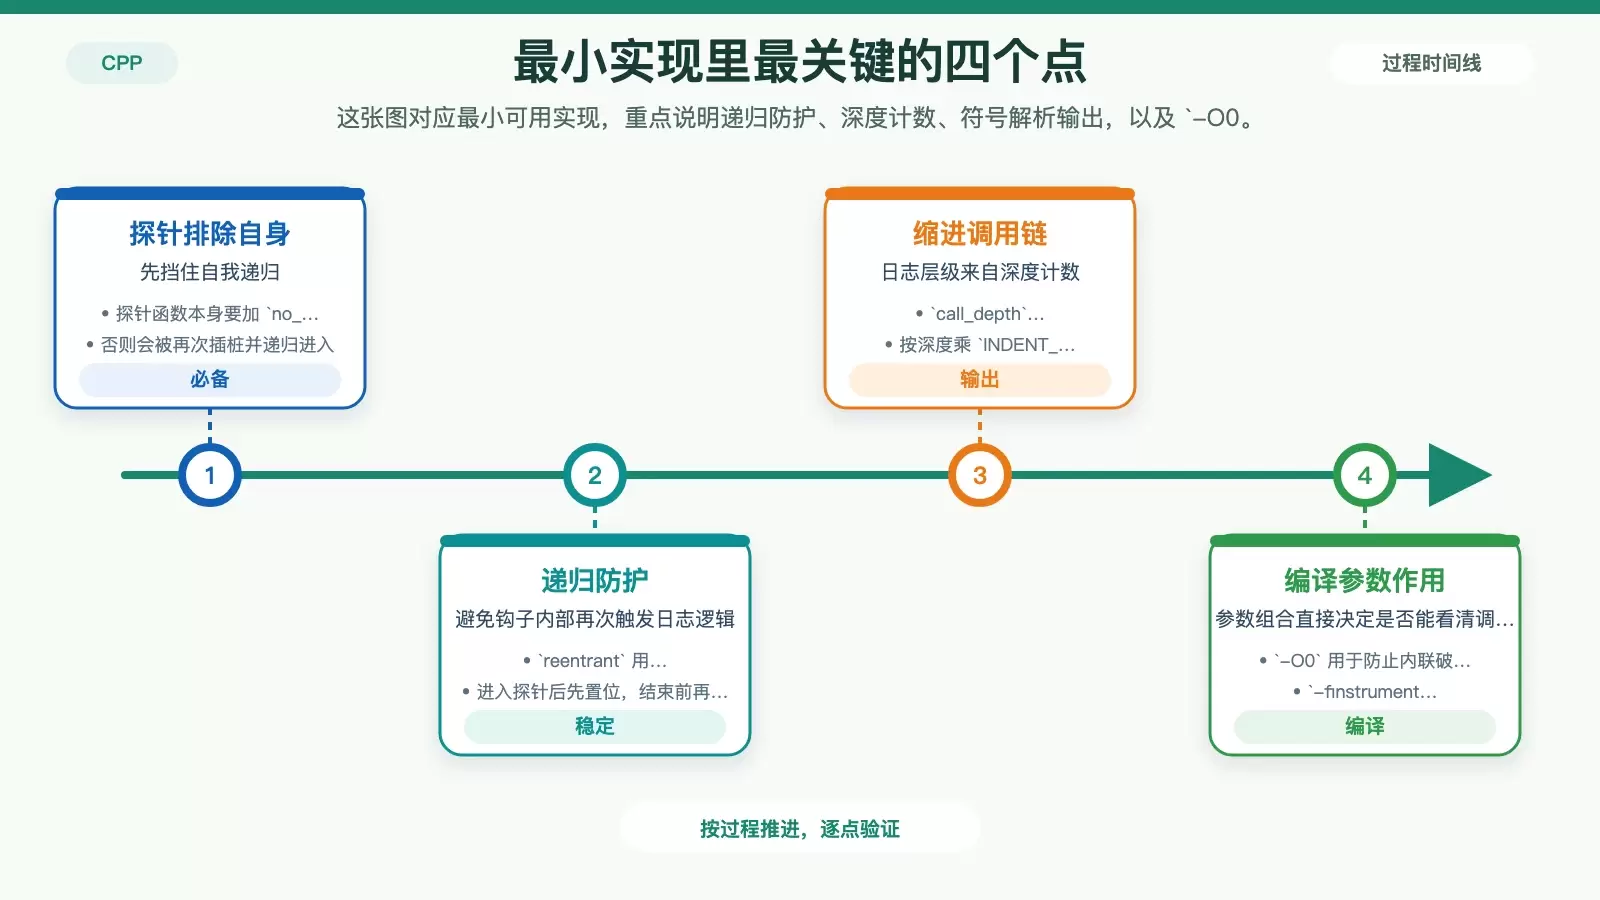
下面这份基础实现保留了源文中的关键点:线程局部深度计数、递归防护、符号解析和带缩进输出。
#include <stdio.h>
#include <stdlib.h>
#include <dlfcn.h>
#include <string.h>
#include <pthread.h>

#define INDENT_SIZE 4

static __thread int call_depth = -1;  // 初始化为-1避免enter/exit匹配错误

void __attribute__((no_instrument_function))
print_indent(int depth) {
    printf("%*s", depth * INDENT_SIZE, "");
}

void __attribute__((no_instrument_function))
__cyg_profile_func_enter(void *this_fn, void *call_site) {
    Dl_info info;
    static __thread int reentrant = 0;

    if (reentrant) return;
    reentrant = 1;

    call_depth++;

    if (dladdr(this_fn, &info)) {
        print_indent(call_depth);
        printf("--> %s [%p]n", info.dli_sname ? : "???", this_fn);
    }

    reentrant = 0;
}

void __attribute__((no_instrument_function))
__cyg_profile_func_exit(void *this_fn, void *call_site) {
    Dl_info info;
    static __thread int reentrant = 0;

    if (reentrant) return;
    reentrant = 1;

    if (dladdr(this_fn, &info)) {
        print_indent(call_depth);
        printf("<-- %s [%p]n", info.dli_sname ? : "???", this_fn);
    }

    call_depth--;

    reentrant = 0;
}
这里最容易被忽略的是 __attribute__((no_instrument_function))。如果不给探针函数本身加这个属性,它们自己也会被插桩,结果就是递归调用,严重时直接崩溃。
编译命令与参数含义
源文给出的编译方式如下:
# 编译插桩库
gcc -shared -fPIC instrument.c -o libinstrument.so -ldl

# 编译目标程序(示例)
gcc -O0 -finstrument-functions test.c -o test -L. -linstrument -Wl,-rpath=.

# 关键参数说明:
# -O0 禁用优化防止函数被内联
# -finstrument-functions 启用插桩
# -Wl,-rpath=. 指定运行时库搜索路径
这组参数里,-O0 很关键。原因不是“调试时惯例加一下”,而是为了尽量避免函数被优化或内联,导致调用关系和你看到的源码结构不一致。另一个常见补充参数是 -g -rdynamic,它对符号解析更友好,特别是在你看到函数名变成 ?? 时。
从调用日志到耗时分析和火焰图
给每次调用加上时间维度
如果只是打印 enter/exit,你能看到层级,但不容易立刻判断哪个函数最耗时。源文给出的扩展方式,是在进入和退出时记录时间戳:
struct call_record {
    void *func;
    struct timespec start;
    double duration;
};

void __cyg_profile_func_enter(...) {
    clock_gettime(CLOCK_MONOTONIC, &record.start);
}

void __cyg_profile_func_exit(...) {
    struct timespec end;
    clock_gettime(CLOCK_MONOTONIC, &end);
    record.duration = (end.tv_sec - start.tv_sec) * 1e9 +
                     (end.tv_nsec - start.tv_nsec);
}
CLOCK_MONOTONIC 适合做耗时统计,因为它不会受系统时间调整影响。文中提到的纳秒级分析,本质上就是基于这类时间差计算实现的。
把文本日志转换成火焰图输入
当调用日志变大之后,纯文本已经不适合人工逐行看。这时可以把堆栈展开成火焰图格式。源文给了一个简单日志处理脚本:
# 日志处理脚本示例
import re
from collections import defaultdict

stack = []
profile = defaultdict(int)

with open('trace.log') as f:
    for line in f:
        if '-->' in line:
            func = line.split()[1]
            stack.append(func)
        elif '<--' in line:
            if stack:
                key = ';'.join(stack)
                profile[key] += 1
                stack.pop()

# 输出火焰图格式
for key, count in profile.items():
    print(f"{key} {count}")
这里的核心思路很简单:进入函数时压栈,退出函数时把当前完整路径拼成 funcA;funcB;funcC count 的形式,再交给 FlameGraph 一类工具做可视化。
两个典型实战:OpenSSL 路径跟踪与内存泄漏排查
OpenSSL 握手流程跟踪
对深层调用最直观的价值,是你能直接看见真实执行顺序和每层耗时,例如:
--> SSL_connect [0x7f8e5a132a40]
    --> ssl3_connect [0x7f8e5a1432d0]
        --> ssl3_setup_buffers [0x7f8e5a145a10]
        <-- ssl3_setup_buffers [1.2ms]
        --> ssl3_do_write [0x7f8e5a1467b0]
            --> ssl3_write_bytes [0x7f8e5a148e30]
            <-- ssl3_write_bytes [5.7ms]
        <-- ssl3_do_write [6.1ms]
    <-- ssl3_connect [15.3ms]
<-- SSL_connect [15.9ms]
像这种日志,几眼就能看出握手主路径、嵌套深度以及慢点集中在哪一层。对于网络库、协议栈、插件链式调用,这种效果尤其明显。
用调用关系辅助定位内存泄漏
同样的思路也可以拿来跟踪 malloc/free,帮助判断“谁申请了内存、谁负责释放、哪段路径丢了配对关系”:
--> malloc [0x401230] size=1024
    --> parse_config [0x4021a0]
        --> load_plugins [0x402e10]
<-- parse_config
--> free [0x401410] ptr=0x7fffe00008c0
    <-- 无对应malloc调用
这类日志不一定能替代专用内存分析器,但在“泄漏发生在复杂业务路径里”这种场景下,它能提供非常有价值的上下文。
性能代价与工程化落地怎么控制
先解决日志写入开销
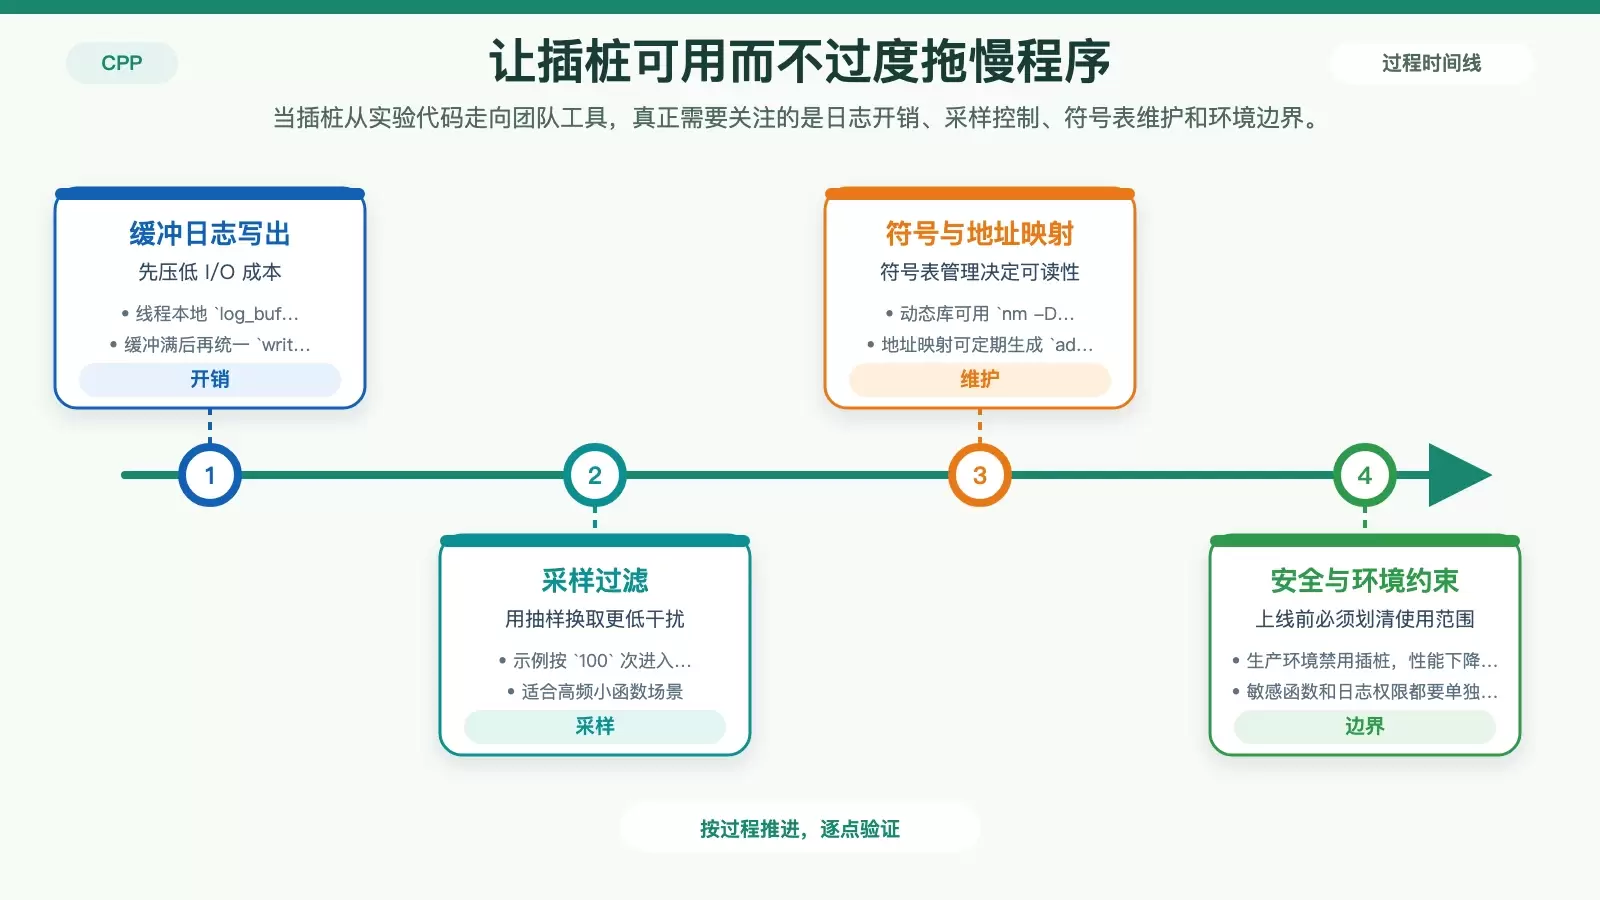
探针本身已经增加了函数调用成本,如果每次都直接 printf,I/O 代价会继续放大。源文建议用线程本地缓冲做异步或批量写出:
#define BUFFER_SIZE 4096
static __thread char log_buffer[BUFFER_SIZE];
static __thread int buffer_pos = 0;

void flush_buffer() {
    write(2, log_buffer, buffer_pos);
    buffer_pos = 0;
}

void buffered_print(const char *msg) {
    int len = strlen(msg);
    if (buffer_pos + len >= BUFFER_SIZE) {
        flush_buffer();
    }
    memcpy(log_buffer + buffer_pos, msg, len);
    buffer_pos += len;
}
这样做的目的,是减少高频函数里反复触发系统调用的次数,降低日志写入对程序行为的干扰。
再用采样过滤控制总体成本
对于大量短小高频函数,完整记录每一次进入和退出,通常意义不大,成本却很高。源文给出的采样方式是:
static int sample_counter = 0;

void __cyg_profile_func_enter(...) {
    if (++sample_counter % 100 != 0) return;
    // 记录逻辑
}
这类做法适合“先粗看热点,再决定是否扩大范围”的诊断流程。代价是精度下降,但换来的是更可控的性能影响。
符号表、CI/CD 与安全边界
如果要把这套方案变成团队可复用工具,至少要补齐下面几类工程化措施:
- 符号表管理策略
- 动态库:使用
nm -D lib.so > symbols.txt - 静态函数:编译时添加
-ffunction-sections - 地址映射:定期生成
addr2line缓存表
- CI/CD 集成方案
steps:
- name: Build with Instrumentation
  run: |
    make CFLAGS="-finstrument-functions"
    ./generate_flamegraph.sh
- name: Archive Reports
  uses: actions/upload-artifact@v2
  with:
    name: callgraph-report
    path: report.html
- 安全注意事项
- 生产环境禁用插桩(性能下降可达300%)
- 敏感函数过滤(加密操作等)
- 日志文件权限控制
如果你的目标是长期观测,而不是临时诊断,那就需要更明确地区分“调试构建”和“正式构建”,避免插桩逻辑误入生产路径。
常见问题与使用判断
源文最后的诊断表,基本覆盖了初次落地时最常见的几类问题:
| 现象 | 原因分析 | 解决方案 |
|---|---|---|
| 函数名显示为?? | 未链接调试符号 | 添加-g -rdynamic编译选项 |
| 日志输出乱序 | 多线程竞争写入 | 改用线程本地缓冲+原子操作 |
| 程序运行崩溃 | 钩子函数递归调用 | 检查no_instrument_function属性 |
| 性能下降严重 | 高频小函数过多 | 启用采样过滤机制 |
| 地址无法解析 | 静态函数未导出 | 使用objdump -t生成符号表 |
如果你当前面对的是遗留系统理解、协议流程跟踪、热路径定位、多模块联调,这套方案非常实用;如果你需要的是线上低损耗持续观测,那就要谨慎评估性能影响,并优先加入采样、过滤和异步写出机制。
它的核心价值并不神秘:把“运行时到底发生了什么”这件事,用编译器原生能力稳定地记录下来,再把文本日志继续转换成可读、可筛选、可视化的分析结果。















