


深入理解 MySQL InnoDB B+树索引的三大底层机制

MySQL InnoDB 引擎基于 B+树构建索引,其内部运作机制直接影响数据写入与查询效率。本文将解析三个关键知识点:根节点页面的全局稳定性、二级索引中如何处理重复值以确保定位唯一性,以及页面存储空间的最小利用策略。
B+树根节点的固定性与创建过程
B+树索引的构建并非从叶子节点开始,而是从根节点页面启动。理解这一过程对于把握索引的结构演变至关重要。
第1步:初始化根节点页面
当一个新索引被创建时,InnoDB 会为其分配一个唯一的根节点页面。此时表中尚无用户数据,该根页面既不包含用户记录(实际数据),也不包含目录项(内节点指向子页的指针)。
第2步:初期数据存储
初始阶段,所有插入的用户记录直接存储在根节点页面中。由于根节点兼具“目录”和“数据页”的双重身份,直到空间即将耗尽前,无需划分层级。
第3步:首次分裂与层级升级
当根节点页面填满后,继续插入新的用户记录将触发页分裂操作:
- InnoDB 创建一个新页面(如页A),并将原根节点中的部分记录迁移至页A。
- 再次分裂得到另一个新页面(如页B)。
- 新生成的记录根据键值大小分配到页A或页B。
- 关键变化:原有的根节点页面不再存储用户数据,而是升级为纯粹的“目录节点”。它包含指向页A和页B的目录项记录。
这一过程确立了 B+树的核心特性:一旦索引建立,根节点页面的页号(Page ID)即被固定并记录在全局位置(如数据字典)。后续所有针对该索引的操作,无论树结构如何变化,都会首先访问这个固定的根节点。
二级索引目录项记录的唯一性保障
在 B+树的内节点中,目录项通常由“索引列值 + 页号”组成。然而,对于二级索引而言,这种结构存在逻辑漏洞,需要通过引入主键来修正。
问题场景:非唯一值的定位歧义
假设表中有主键 c1 和二级索引列 c2。若为 c2 建立索引,且 c2 存在重复值(例如多个记录 c2=1),则仅凭 c2 的值无法确定该条记录属于哪个数据页。
如下示意数据结构:
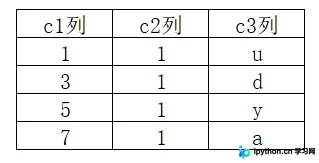
当试图通过 c2=1 查询时,若索引层仅存储 c2 值和页号,系统无法判断应跳转至页4还是页5。
解决方案:复合目录项
为解决此问题,InnoDB 在二级索引的内节点目录项中引入了主键值。完整的目录项结构变为:索引列值 + 主键值 + 页号。
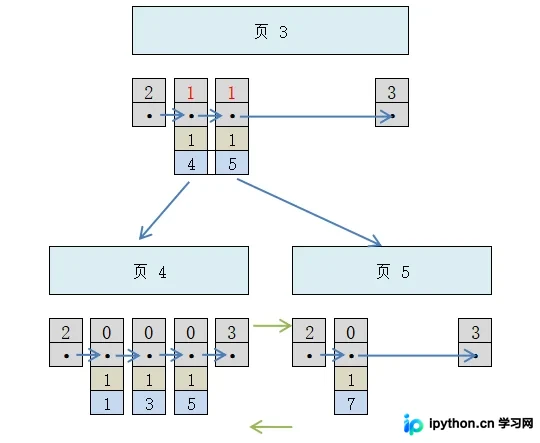
以插入新记录 (c1=9, c2=1) 为例,索引层的查找逻辑变为:
- 首先比较 c2 列的值。
- 若 c2 值相同(如当前目录项 c2=1,待插记录 c2=1),则继续比较主键值(c1)。
- 根据主键值的大小决定向左子页还是右子页移动。
这意味着,在 InnoDB 的逻辑实现中,二级索引的内节点排序逻辑等同于建立一个以“二级索引列+主键”为键的联合索引。这保证了即使在二级索引列值重复的情况下,每个目录项也是唯一的,从而能精确定位到目标数据页。
页面容量约束:为何至少容纳两条记录
B+树的高效性依赖于其低高度(通常为3-4层即可覆盖数亿数据)。若单页只能存放极少数据,树的层级将无限膨胀,导致 I/O 开销剧增。
设计约束的目的
InnoDB 强制要求每个数据页(Page)在正常情况下至少容纳两条记录。这一约束旨在防止以下情况发生:
- 层级过高:如果每页只存一条数据,B+树将退化为类似链表的结构,失去多路查找的优势。
- 存储碎片化:确保页面有足够的数据密度,提高缓存命中率。
虽然极端删除操作可能导致页面半空,但在写入平衡过程中,InnoDB 会尝试合并相邻的低占用页,以维持整体结构的紧凑性。
以上就是 MySQL InnoDB 中 B+树索引底层机制的详细内容,更多关于 MySQL InnoDB 索引优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















