


MySQL中超键、候选键与主键的区别及实际应用

在MySQL数据库设计中,理解超键、候选键和主键的概念及其层级关系是构建规范数据模型的基础。本文将通过定义解析与实例演示,阐明三者如何在保证数据唯一性与完整性方面各司其职。
核心概念解析
在关系型数据库中,为了准确识别每一行数据(元组),系统引入了不同层级的“键”的概念。它们并非同一事物,而是具有包含与被包含的层级关系。
- 超键 (Super Key):任意一个能唯一标识关系中元组的属性或属性组。只要该集合中的数据组合起来不会重复,即为超键。超键可能包含多个属性,甚至包含冗余属性。
- 候选键 (Candidate Key):不含有多余属性的超键。也就是说,如果去掉候选键中的任意一个属性,它将不再具备唯一标识能力。候选键必须是“最小”的超键。
- 主键 (Primary Key):用户从候选键中选定用来唯一标识表中元组的那个特定候选键。一个表只能有一个主键,但可以有多个候选键。
简而言之,逻辑关系为:主键 ⊂ 候选键 ⊂ 超键。
第1步:识别超键
首先需要找出所有能唯一确定一行数据的字段组合。例如,在一个用户信息表中,如果 id 列本身不重复,那么 id 是一个超键;如果 username 也不重复,username 也是一个超键;而 (id, username) 组合同样是唯一确定的,因此也是超键,尽管它包含了冗余信息。
第2步:筛选候选键
在所有的超键中,剔除那些包含“多余”字段的组合。回到上面的例子,(id, username) 虽然是超键,但 id alone 就足以确定身份,因此 username 在此处是多余的,(id, username) 就不是候选键。只有 id 和 username 单独作为集合时,若都能唯一标识且不可再分,它们才是候选键。
第3步:确立主键
数据库设计者根据性能、稳定性、业务语义等因素,从候选键中选择一个作为主键。通常选择短小、不易变更且数值型的字段(如自增ID)作为主键,以利于索引效率和维护。
直观对比与案例演示
为了更清晰地理解,我们可以通过具体的表格结构进行观察。
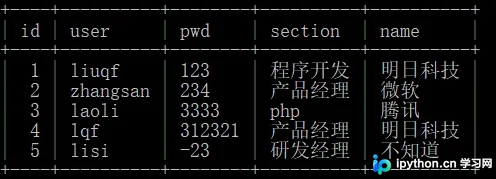
案例情境
假设我们有一张学生信息表,包含以下字段:
- 学号 (Student ID)
- 姓名 (Name)
- 性别 (Gender)
- 年龄 (Age)
- 系别 (Department)
- 专业 (Major)
a. 确定超键:
任何能唯一锁定一个学生的属性组合都是超键。例如:{学号}、{姓名}(假设无同名)、{姓名, 性别, 年龄} 等,只要能确保组合值不重复,即为超键。
b. 确定候选键:
在超键中筛选出没有冗余属性的。如果 “学号” 唯一且简洁,则 {学号} 是候选键。如果系统中规定 “姓名+性别+年龄” 也能唯一确定一人且无法再精简,则该组合也是候选键。注意,如果 {学号, 姓名} 被提出,因为 学号 已足够,姓名 成了多余属性,所以这不是候选键。
c. 选择主键:
在实际的 MySQL 建表语句中,我们通常会指定其中一个候选键为主键。鉴于 “学号” 比 “姓名+... ” 更稳定、更简短,通常会将 {学号} 设为主键。
排错指南:如何判断非候选键?
在处理复杂业务场景时,常需判断某属性集是否能作为候选键。以下是常见的错误陷阱:
- 存在重复数据:如果属性集中包含的值在某几行中完全相同,则该集合不能作为超键,进而不能成为候选键或主键。例如在上述学生表中,
{年龄, 系别}很可能对应多个学生(同系同届同龄多人),因此它不是超键,自然也不是候选键。 - 存在冗余属性:如果属性集 A 能唯一标识,而 B 是 A 的子集且也能唯一标识,那么 A 包含冗余属性,A 是超键但不是候选键。
- 逻辑冲突:某些看似唯一的组合,随着时间推移可能产生重复(如姓名),因此在长期运行的系统中,基于自然键(如姓名)做主键风险较大,建议使用代理键(如自增ID)。
以上关于超键、候选键与主区别的详细内容,更多关于MySQL数据库设计规范的知识资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















