


MySQL SQL执行流程与生命周期解析

本文详细拆解MySQL中一条SQL语句从发出到返回结果的完整生命周期,分析连接池、查询缓存、SQL解析器、查询优化器及执行器等核心组件的作用,帮助读者理清底层逻辑以优化数据库性能。
结果与目标
优化SQL和数据库的前提是理解其执行路径。通过分析MySQL内部处理SQL的各个步骤,可以明确瓶颈所在,从而进行针对性的调优。本文将梳理从客户端请求到最终数据返回的完整链条。
准备条件
MySQL架构可宏观划分为三个部分:MySQL客户端、MySQL服务端以及存储层(硬件层面)。本次讨论聚焦于前两者,即客户端与服务端之间的交互及服务端内部的模块流转。
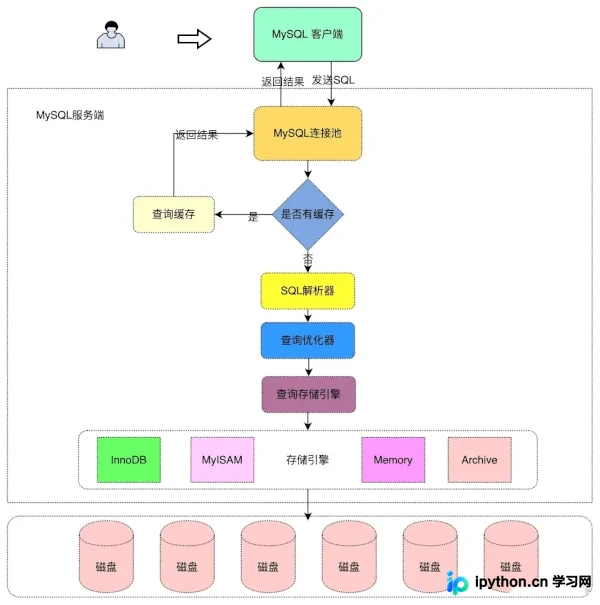
真实操作顺序
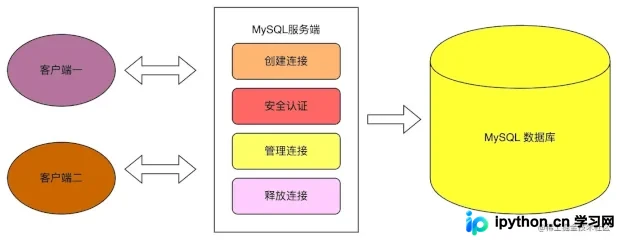
第1步:客户端建立连接与权限验证
目的:建立稳定的通信通道并验证访问合法性,避免频繁创建连接带来的资源消耗。
操作与原理:
- 客户端通过编程语言的API或命令行工具(如
mysql -u$username -p$password -h$host -P$port)向服务端发起请求。 - 此阶段网络环境直接影响连接速度,但非本次重点。
- 服务端通过连接池模块处理连接。连接池的作用是复用已建立的TCP连接,对后续客户端请求不再重复进行耗时的权限验证和网络握手,仅记录连接状态。这在高并发场景下能显著降低内存溢出风险并减少延时。
第2步:查询缓存命中检查
目的:若存在完全相同的历史查询结果,直接返回以提升性能。
操作与原理:
- MySQL开启查询缓存后,会将查询条件(SQL语句、数据库名、协议Hash值)作为Key存储在内存哈希表中。
- 命中缓存:跳过后续所有解析、优化和执行步骤,直接返回结果。
- 未命中或失效:继续后续流程。
- 缓存失效场景:
- 相关表的数据发生变更(更新、删除、插入)。
- 查询中包含动态变化的数据(如
now()),此类查询不生成缓存。
可通过以下命令查看缓存配置项:
-- 查询缓存配置项
mysql> SHOW VARIABLES LIKE '%query_cache%';
+------------------------------+---------+
| Variable_name                | Value   |
+------------------------------+---------+
| have_query_cache             | YES     |
| query_cache_limit            | 1048576 |
| query_cache_min_res_unit     | 4096    |
| query_cache_size             | 1048576 |
| query_cache_type             | OFF     |
| query_cache_wlock_invalidate | OFF     |
+------------------------------+---------+
6 rows in set (0.01 sec)
配置选项说明:
OFF:关闭缓存。ON:全部查询开启缓存。DEMAND:按需缓存,需显式使用SQL_CACHE关键字。
在 my.cnf 中配置:query_cache_type = 1 开启全局缓存,query_cache_type = 2 开启按需缓存。示例如下:
mysql> select SQL_CACHE * from info;
+----+--------------+
| id | name         |
+----+--------------+
|  1 | 小仙女       |
|  2 | 小帅哥       |
|  3 | 铁锤妹妹     |
+----+--------------+
3 rows in set, 1 warning (0.00 sec)
第3步:SQL解析器处理
目的:识别SQL语句类型并检查语法正确性。
操作与原理:
当缓存未命中时,SQL进入解析器。解析器将字符串形式的SQL转换为词法和语法树,判断其属于SELECT、INSERT、UPDATE还是DELETE等操作。若语法错误(如拼写失误),解析器将立即报错,例如 ERROR 1064 (42000): You have an error in your SQL syntax;。常见错误排查应关注提示中的最后部分,如 “near 'elect' at line 1” 暗示少了’s’。
mysql> elect * from info;
ERROR 1064 (42000): You have an error in your SQL syntax; check the manual that corresponds to your MySQL server version for the right syntax to use near 'elect * from info' at line 1
第4步:查询优化器决策
目的:寻找当前SQL的最高效执行方案。
操作与原理:
优化器主要工作在逻辑层面,通过算法评估不同执行计划的成本。例如在多表关联查询时,优化器会决定先扫描哪张表、使用何种Join算法或索引策略。
示例SQL:
mysql> select * from province inner join city on city.fid = province.id where province.id = 1;
对于上述语句,优化器可能对比两种路径:
1. 先查 province 表过滤ID=1,再查 city 表匹配fid。
2. 先获取 city 全表,再筛选fid=1并反查 province。
优化器根据统计信息和索引情况选择代价最小的一种。
第5步:SQL执行器执行
目的:落实最终的执行动作并返回数据。
操作与原理:
在执行具体IO操作前,执行器会再次确认用户对该表的权限(若之前走了缓存,此处仍会进行权限校验)。权限通过后,调用具体的存储引擎接口(如InnoDB)读取数据或写入磁盘,并将结果集打包返回给客户端。
完成判断与排错
- 缓存建议:实际生产中,默认关闭全局缓存或设为按需开启(DEMAND)。因为任何单表的更新操作都会导致该表相关的缓存全部失效,高写入场景下缓存失效带来的重建开销可能超过其带来的查询加速收益。
- 权限报错:若执行器阶段无数据返回且无SQL语法错误,需检查用户是否具有对应表的
SELECT/INSERT等具体权限。 - 慢查询定位:若某SQL执行缓慢,通常瓶颈在优化器选择的索引不当或执行器触发的全表扫描,可通过
EXPLAIN分析执行计划。
简要总结
一条SQL在MySQL中的生命周期依次经过:客户端连接与权限验证 → 连接池复用 → 查询缓存命中判断 → SQL语法解析 → 逻辑优化器选型 → 执行器权限校验与存储引擎调用。理解这一流程有助于避开无效的缓存配置陷阱,并通过优化SQL写法配合索引来发挥优化器的最大效能。
以上就是MySQL一条SQL从客户端到存储引擎的完整执行流程详解,更多关于SQL执行原理与优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















