


MySQL联合索引最左匹配原则:原理与失效排查

在MySQL中建立联合索引时,为何必须严格遵循字段顺序?这是因为B+树索引基于“最左前缀”原则构建,仅当查询条件包含索引定义的最左侧字段时才能生效。本文将剖析其底层原理,详解全表扫描、范围查询中断等索引失效场景,并提供避免性能瓶颈的实战建议。
为什么需要指定联合索引的顺序
在创建联合索引(例如在 a, b, c 三个字段上)时,必须明确字段的优先级。虽然理论上三个字段组合在一起,但数据库引擎会根据指定的顺序构建搜索树。如果顺序随意,会导致查询优化器无法有效利用索引结构。
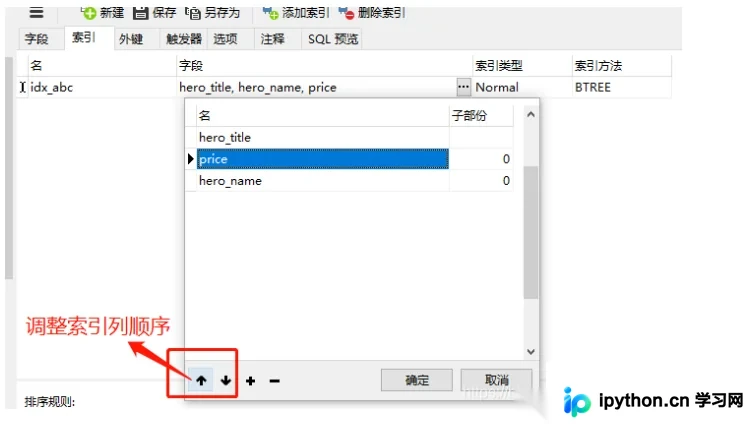
这种机制引出了MySQL中最关键的原则之一:**最左匹配原则**。
在实际开发中,常出现建了联合索引却未被使用的情况。以联合索引 abc_index: (a, b, c) 为例:
- 不走索引的情况:
select * from table where c = '1';select * from table where b ='1' and c ='2';
由于缺少最左侧的a字段,B+树无法确定起始搜索方向。 - 走索引的情况:
select * from table where a = '1';select * from table where a = '1' and b = '2';select * from table where a = '1' and b = '2' and c='3';
可以看出,只有当 WHERE 条件中包含 (a)、(a,b) 或 (a,b,c) 的组合时,索引才会被触发。值得注意的是,即使查询条件为 (a, c),虽然能用到索引进行初步筛选,但由于跳过了 b,此时仅依靠 a 字段命中索引,c 字段无法直接参与B+树的有序查找,需回表后过滤。
最左匹配原则的底层原理
B+树是一种多路平衡查找树,MySQL 中的联合索引正是基于此结构。当创建一个 (a, b, c) 的联合索引时,实际上是在 B+ 树中建立了针对 (a)、(a, b) 和 (a, b, c) 的索引路径。
假设存在一张表 LOL (id, sex, price, name),物理数据无序排列。若创建联合索引 abc_index: (sex, price, name),生成的索引文件会在逻辑上按照 sex → price → name 的顺序进行分级排序:
- 首先按
sex排序; - 当
sex相同时,按price排序; - 当
sex和price均相同且,按name排序。
这种层级排序结构使得索引树能够快速定位到符合条件的数据区间。
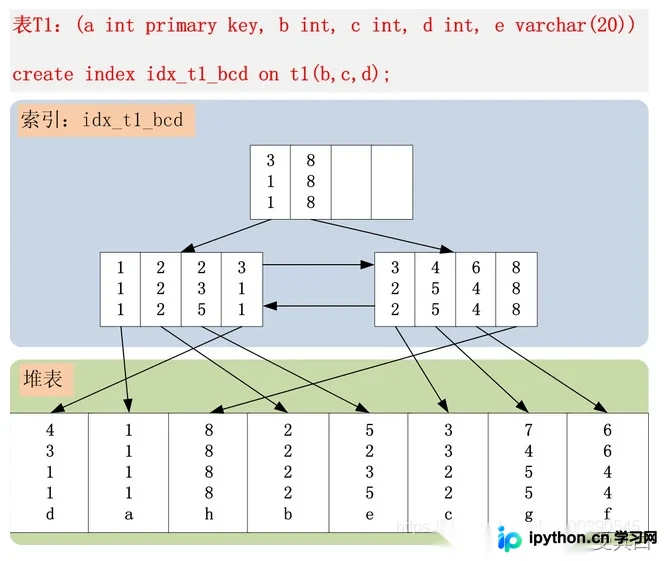
以查询为例:SELECT sex, price, name FROM LOL WHERE sex = 2 AND price = 6300 AND name = 'JJJ疾风剑豪';
B+ 树会先比较 sex=2 确定分支方向,再在该分支内比较 price=6300,最后通过 name 定位具体节点。整个过程如同翻字典,必须先找到首字母对应的章节,再找页码,最后找页面上的行。
违背最左原则导致索引失效的场景
理解原理后,我们可以清晰地识别出哪些 SQL 写法会导致索引失效:
第1步:缺失最高优先级索引字段(缺头)
如果查询条件未包含联合索引的第一个字段,例如 WHERE price = 6300 AND name = 'JJJ...。此时 B+ 树不知道从哪个子树开始遍历,因为所有不同 sex 值的记录都可能满足条件,因此只能进行全表扫描。
第2步:缺失中间优先级索引字段(断链)
如果跳过中间字段,例如 WHERE sex = 1 AND name = 'JJJ...。此时 MySQL 可以利用 sex=1 快速定位到对应的大区间,但由于 price 字段缺失,区间内的数据在 price 维度上是无序的。因此,对于 name 的匹配,数据库无法直接在索引树上进行二分查找,只能将符合 sex=1 的主键 ID 全部取出,通过回表查询完整数据后进行过滤。虽然这比全表扫描快,但效率远低于完整索引覆盖。
查询优化器的行为与优化技巧
在实际应用中,还有一些特殊情况需要注意,了解这些可以避免误判:
1. 查询条件的顺序并不影响索引使用
即使索引定义为 (a, b),查询语句写成 WHERE b = 1 AND a = 'aaa',MySQL 的查询优化器会自动调整 WHERE 子句的顺序,使其变为 a = 'aaa' AND b = 1,从而正常利用索引。但这并不代表可以忽视书写规范,清晰的代码有助于维护。
2. 范围查询会中断后续索引匹配
当查询中包含范围条件(如 >, <, BETWEEN, LIKE 'xx%')时,该列及其之后的列将无法使用索引进行精确查找。
例如:WHERE a = 2 AND b > 1000 AND c = 'Name';
在上述语句中,a 精确匹配,b 范围查询。一旦遇到 b 的范围判断,索引的连续性就被打断。此时 c 字段虽然在索引中存在,但在当前范围内是无序的,优化器通常会选择忽略对 c 的索引查找,直接回表扫描或重新计算。
优化方案: 如果遇到此类查询,可考虑调整联合索引的顺序,将范围查询的字段放在最后,或者拆分为多个单列索引(视数据分布而定)。例如将索引改为 (a, c, b),可能能同时利用 a 和 c 的索引特性。
其他相关知识点总结
利用有序索引避免 Filesort
当 ORDER BY 字段出现在 WHERE 条件中,且顺序与索引一致时,MySQL 可直接读取已排序的索引数据,无需额外排序操作(Filesort)。例如:SELECT ... WHERE sex = 1 ORDER BY sex;
此处 sex 已是索引顺序,无需二次排序。但如果查询的是范围外的字段,或者 WHERE 未指定 sex,则通常需要进行额外的排序。
Like 语句的通配符陷阱
LIKE 'value%':前缀固定,可利用最左匹配原则走索引。LIKE '%value'或'%value%':开头模糊匹配,破坏了最左前缀规则,导致全表扫描。
避免在索引列上进行运算
如果对索引列使用函数或表达式,会导致索引失效。
错误示例:SELECT * FROM users WHERE YEAR(birthday) < 1990;
正确改写:SELECT * FROM users WHERE birthday < '1990-01-01';
NULL 值与区分度
- NULL 值: MySQL 索引(尤其是 B+Tree)不包含值为 NULL 的行。设计中应避免字段默认值为 NULL。
- 区分度:
区分度 = count(distinct col) / count(*)。区分度越高,索引效果越好。状态类字段(如性别,区分度约 0.5)索引价值较低,而唯一标识符(区分度接近 1)索引价值极高。一般建议在 Join 或过滤频繁字段上建立高区分度的索引。 - 覆盖索引: 如果查询的所有字段都包含在索引中,无需回表查询聚簇索引,称为覆盖索引。这是提升性能的利器,应尽量避免使用
SELECT *,而是只选取需要的字段以尝试命中覆盖索引。
以上就是关于 MySQL 最左匹配原则及索引优化的详细内容,更多关于数据库调优与 SQL 编写规范的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















