


MySQL索引原理详解与SQL创建优化策略

索引是提升MySQL数据库性能的核心机制。本文系统讲解B+树索引的工作逻辑,通过对比B-Tree结构阐明其在IO次数控制上的优势,并整理各类索引(主键、唯一、普通)的SQL创建与删除标准写法,帮助开发者建立科学的索引设计与优化思维。
索引的核心概念与作用
索引是一种特殊的文件,包含指向数据表中所有记录的引用指针。其作用类似于书籍目录或书架上的分类标签,能够极大缩短数据库查找数据的时间。若无索引,数据库只能进行全表扫描,数据量越大性能损耗越严重。
在实际应用中,索引不仅限于单列,还可基于多列组合创建。不同的应用场景需要匹配不同类型的索引结构,以平衡读写性能与存储成本。
何时应该创建索引
- 查询频繁:该列经常出现在
WHERE条件、JOIN连接或排序分组中。 - 数据量大:表记录数达到万级或以上时,索引的收益才显著。
- 更新频率低:索引虽加速读取,但会降低写操作(插入、更新、删除)的速度,因为每次修改都需同步更新索引文件。
- 选择性高:列的重复值越少,索引的过滤能力越强。
B-Tree 与 B+Tree 的底层原理
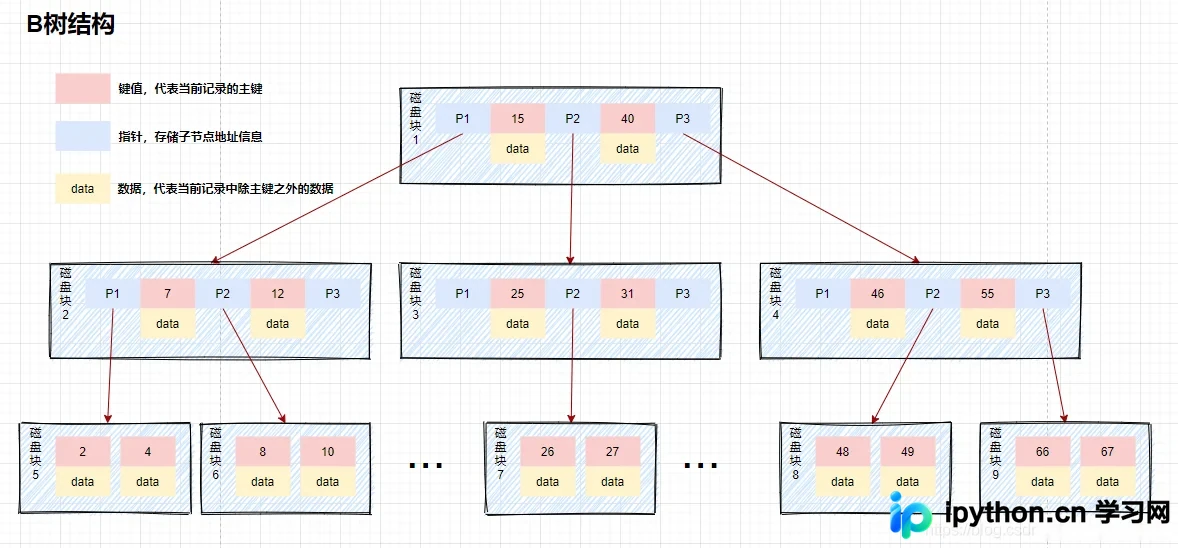
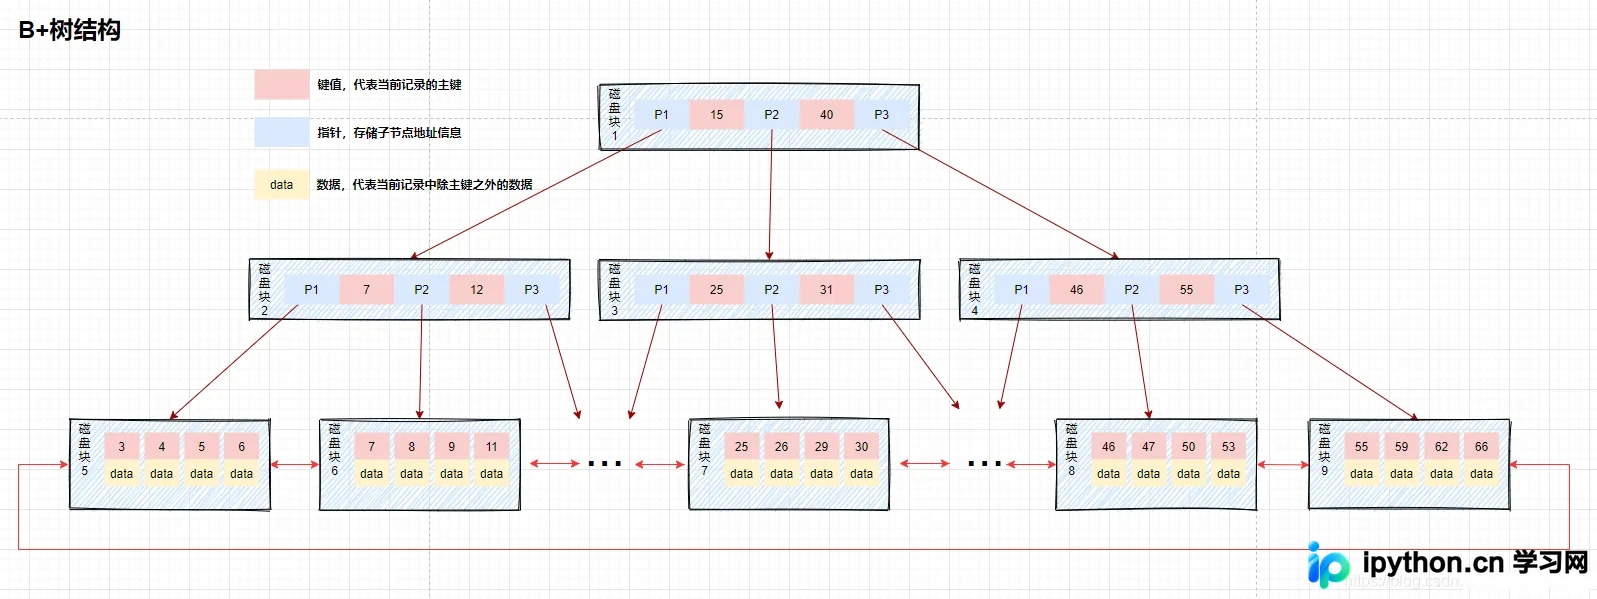
MySQL InnoDB 引擎默认使用 B+Tree 作为索引结构。理解其与 B-Tree 的区别是掌握 MySQL 优化的基础。
B+Tree 的核心优势
1. 减少 I/O 操作次数: B-Tree 的非叶子节点也存储数据,而 B+Tree 的非叶子节点仅存储键值(Key)和指针。这意味着单个页面能容纳更多的键值,从而降低树的深度。更矮的树意味着在相同数据量下,从根节点遍历到叶子节点所需的磁盘 I/O 次数更少。
2. 查询性能稳定: B+Tree 的所有查询都必须走到叶子节点才能获取完整数据,路径长度一致,时间复杂度固定为 O(log(n))。相比之下,B-Tree 可能在非叶子节点就命中数据,导致平均查询性能波动。
3. 高效支持范围查询: B+Tree 的叶子节点之间通过双向链表指针相连。在进行范围查询(如 BETWEEN、>、<)时,定位到起点后只需顺序遍历链表即可,无需像 B-Tree 那样反复进行复杂的回溯搜索。
MySQL 索引的分类体系
根据存储结构和业务用途,MySQL 索引可分为多个维度:
- 按存储结构:B-Tree(默认)、Hash(仅适用等值查询)、Fulltext(全文检索)、RTree(空间索引)。
- 按数据逻辑:聚集索引(Clustered Index,即主键索引,数据行存在叶子节点)、二级索引/辅助索引(Secondary Index,叶子节点存的是主键值)。
- 按约束关系:主键索引、唯一索引、普通索引、复合索引。
索引的标准 SQL 操作
以下演示如何在不同阶段创建和管理常用索引。建议在开发环境中验证后再应用于生产环境,涉及大表操作前务必做好数据备份。
第 1 步:创建主键索引
目的:确定表的唯一标识,InnoDB 依赖主键构建聚簇索引。
动作:在建表时定义或在表创建后添加。
-- 方式一:在字段定义时直接指定
CREATE TABLE user1 (id INT PRIMARY KEY, name VARCHAR(30));

-- 方式二:在表定义末尾统一指定
CREATE TABLE user2 (
  id INT,
  name VARCHAR(30),
  PRIMARY KEY(id)
);

-- 方式三:表已存在,追加主键(若原表无主键)
ALTER TABLE user3 ADD PRIMARY KEY(id); -- 假设 user3 已存在且 id 无重复
注意:一个表只能有一个主键;主键列不可为空(NOT NULL)且必须唯一。通常使用自增整数(INT/BIGINT)以提升插入效率。
第 2 步:创建唯一索引
目的:保证列数据的唯一性,常用于邮箱、手机号等业务字段。
动作:利用 UNIQUE 关键字。
-- 在字段属性中指定
CREATE TABLE user4 (
  id INT PRIMARY KEY,
  name VARCHAR(30) UNIQUE
);

-- 在表结构末尾指定
CREATE TABLE user5 (
  id INT PRIMARY KEY,
  name VARCHAR(30),
  UNIQUE(name)
);

-- 已有表中添加
ALTER TABLE user6 ADD UNIQUE INDEX idx_name ON user6(name); -- 推荐使用显式命名
特点:允许 null 值,但不能有重复数据。如果唯一索引列同时设为 NOT NULL,其效果等同于主键。
第 3 步:创建普通索引
目的:加速常见查询条件,允许数值重复。
入口:任意字段均可设置,建议结合业务场景命名。
-- 建表时指定
CREATE TABLE user8 (
  id INT PRIMARY KEY,
  name VARCHAR(20),
  email VARCHAR(30),
  INDEX idx_email(email) -- 显式命名索引有利于后期维护
);

-- 对已有表添加
CREATE TABLE user9 (id INT, name VARCHAR(20));
ALTER TABLE user9 ADD INDEX idx_name(name);

-- 或直接在现有表上建立
CREATE INDEX idx_user9_name ON user9(name);
第 4 步:查看与管理索引
查询索引信息:
使用 SHOW KEYS 或 SHOW INDEX 查看索引名称、类型、列名及统计信息。
SHOW INDEX FROM goods;删除冗余索引: 长期不用的索引会占用空间并拖慢写入速度,应及时清理。
-- 删除特定普通索引
DROP INDEX idx_name ON user8;

-- 或删除主键
ALTER TABLE tbl_name DROP PRIMARY KEY;

-- 通用语法
ALTER TABLE tbl_name DROP INDEX index_name;
索引设计的避坑原则
正确的索引设计需要权衡“读”与“写”。以下是关键的决策准则:
- 最左前缀匹配:如果是复合索引(如
(a,b,c)),查询条件必须从左侧开始连续使用才会走索引。例如用到了b而没有a,则索引失效。 - 避免过度索引:不要为每个小表的所有字段都加索引。这会显著增加磁盘 I/O 负担和维护成本。
- 低区分度不加索引:如性别(男女两种值)、状态码等。即使加了索引,优化器往往也会因为回表代价过高而放弃使用。
- 索引覆盖:尽可能让查询只涉及索引列(Covering Index),这样无需回主键查原始数据,性能极佳。
以上就是关于 MySQL 数据库索引原理及 SQL 优化策略的详细内容,更多关于 MySQL 高性能调优的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















