


MySQL数据库性能优化:15条实用技巧与避坑指南

深入掌握MySQL优化的核心在于理解执行机制与合理设计。本文系统梳理了从查询编写到存储结构的15项关键技术,包括正确使用查询缓存、利用EXPLAIN排查瓶颈、采用LIMIT 1优化唯一行检索,以及防范SQL注入的预处理语句方案。
查询执行与缓存优化
高效的SQL编写是提升性能的第一步。许多性能瓶颈源于对MySQL引擎特性的误解,例如查询缓存的使用限制和随机排序的计算开销。
第1步:正确利用查询缓存
目的:针对完全相同的SELECT语句,减少磁盘IO和解析时间。
注意:MySQL查询缓存对含有非确定性函数(如 CURRENT_DATE())的查询可能失效,且受数据更新影响大。建议在写入频繁的场景中谨慎使用或禁用。
// 尝试使用变量替代函数,以便命中缓存
$date = date("Y-m-d");
$sql = "SELECT username FROM user WHERE signup_date >= '$date'";
$result = mysqli_query($conn, $sql); // 假设已迁移至mysqli

// 避免直接使用CURDATE()在缓存敏感场景中
$sql_no_cache_risk = "SELECT username FROM user WHERE signup_date > '2023-01-01'";
第2步:使用 EXPLAIN 分析查询
目的:透视SQL执行细节,发现全表扫描或缺失索引的问题。
操作:在 SELECT 语句前加上 EXPLAIN,观察 type(访问类型)、key(实际使用的索引)和 rows(预估扫描行数)。当发现类型为 ALL 或 key 为 NULL 时,需检查WHERE条件和JOIN字段是否有索引。
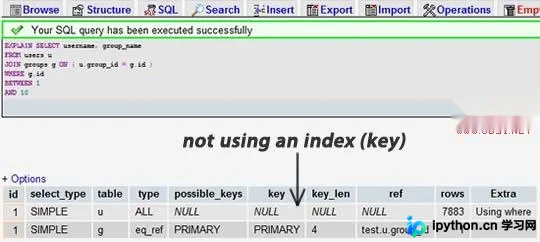
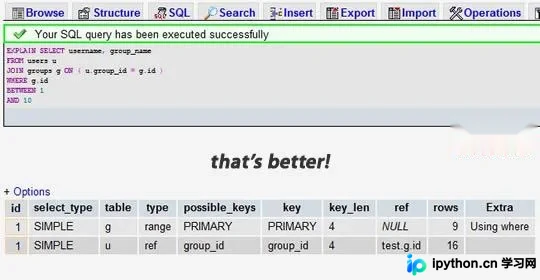
上图展示了添加索引前后的查询对比,添加合适的索引能显著降低扫描行数,提升检索速度。
第3步:检索唯一行使用 LIMIT 1
目的:提前终止扫描,节省资源。
场景:当你仅需要判断是否存在记录,或只需取一行特定数据时。
// 错误示范:检查所有满足条件的行
$result = mysqli_query($conn, "SELECT * FROM users WHERE state='Alabama'");
if (mysqli_num_rows($result) > 0) { ... }

// 正确示范:找到即停
$result = mysqli_query($conn, "SELECT 1 FROM users WHERE state='Alabama' LIMIT 1");
第4步:避免 ORDER BY RAND()
目的:避免全表排序导致的CPU高负载。
原理:ORDER BY RAND() 会为每行生成随机数并排序,复杂度极高。若仅需随机获取少量数据,应先在应用层获取总条数,计算随机偏移量后使用 LIMIT offset, 1。
// 获取总记录数
$count_sql = "SELECT COUNT(*) FROM users";
$total = mysqli_fetch_row(mysqli_query($conn, $count_sql))[0];
$rand_offset = mt_rand(0, $total - 1);

// 随机取一行
$sql = "SELECT username FROM users LIMIT $rand_offset, 1";
第5步:避免 SELECT *
目的:减少网络传输流量和内存占用。
说明:只选取需要的列,尤其是在数据量大或跨服务器调用时。这不仅加快响应速度,也有助于覆盖索引(Covering Index)生效,避免回表查询。
索引与连接优化
合理的索引设计和关联条件是数据库查询性能的核心支撑。
第6步:确保连接列类型一致
目的:保证JOIN操作能利用索引。
条件:在进行表连接时,参与连接的字段必须是相同的数据类型(如都是 INT 或 VARCHAR),且字符集一致。如果类型不匹配,MySQL可能会进行隐式转换导致索引失效。
-- users.state 和 companies.state 应当同类型且有索引
SELECT company_name
FROM users
LEFT JOIN companies ON users.state = companies.state
WHERE users.id = 123;
第7步:索引中的检索字段规范
说明:除了主键,任何经常用于 WHERE、ORDER BY 或 JOIN 的列都应考虑建立索引。如上图所示 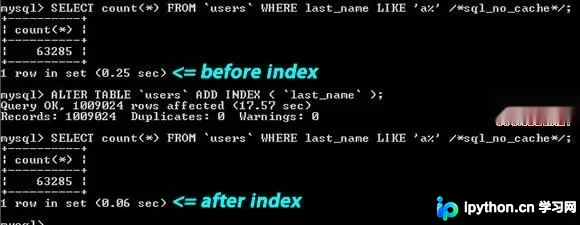 ,正确的索引选择能直接加速数据定位。
第8步:固定长度表设计
目的:提高存取效率和缓冲命中率。
建议:尽量使用定长数据类型(如 INT, CHAR, DATE),避免在高频访问表中混用变长字段(如 TEXT, BLOB, VARCHAR)。定长表更容易计算偏移量,但在空间利用率上可能需要权衡,可通过垂直分割(见下文)分离高频短字段与低频长文本。
结构与数据类型优化
表的物理结构和字段类型直接影响底层存储效率和维护成本。
第9步:每张表必设独立主键
说明:推荐使用自增的 UNSIGNED INT 作为主键。即使是“邮箱”这样的自然键,也不建议作为主键,因为VARCHAR类型的索引开销远大于INT,且会引发后续ID变更带来的级联更新问题。
第11步:使用 ENUM 代替 VARCHAR
目的:压缩存储空间,提升比较速度。
适用场景:当字段取值已知且有限(如性别、状态)时。ENUM 在底层以 TINYINT 存储,比字符串更紧凑,适合做选项列表。
第12步:尽量设置 NOT NULL
说明:除非业务逻辑确有需要,否则字段应尽量设为 NOT NULL。NULL 值需要额外的位图标记,且在比较运算中会增加代码复杂性。在数值类型中,0 通常比 NULL 更容易处理。
第13步:IP地址存储优化
目的:减小存储体积,加速范围查询。
方法:将 IP 地址存储在 UNSIGNED INT 而非 VARCHAR(15)。PHP 中可使用 ip2long() 转换存入,查询时可用 INET_ATON() 转换。
第14步:垂直分割表结构
目的:降低单表宽度,提升缓存效率。
做法:将 rarely used 的大字段(如文章内容、详细简历)拆分为扩展表。主表只保留高频访问的核心字段,实现冷热数据分离。
安全与高级特性
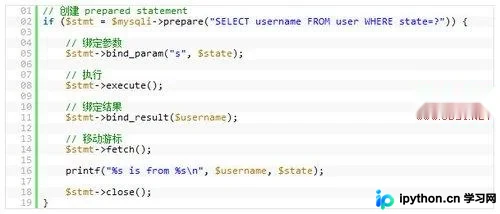
第15步:使用 Prepared Statements(预处理语句)
目的:防御 SQL 注入攻击,提升多次执行相同SQL的性能。
优势:参数化查询能将结构与数据分离。对于高频执行的相似语句,预处理语句只需解析一次SQL模板,后续绑定参数即可执行。同时彻底杜绝因拼接字符串导致的注入风险。
$stmt = $mysqli->prepare("SELECT username FROM users WHERE state=?");
$stmt->bind_param("s", $state);
$state = "California";
$stmt->execute();
$stmt->bind_result($username);
while ($stmt->fetch()) {
    echo "$username is from $state\n";
}
$stmt->close();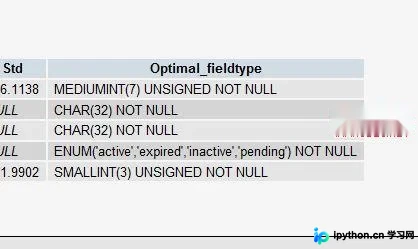
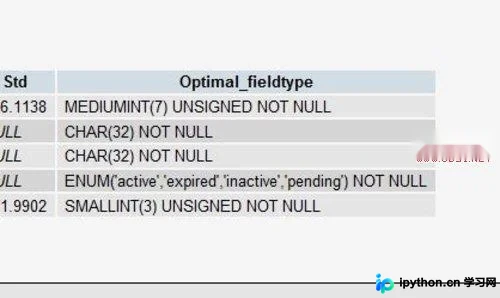
利用 phpMyAdmin 等工具提供的“Propose table structure”功能,可以辅助分析现有数据的分布,从而给出字段类型的优化建议。但请注意,这些建议基于历史数据,最终决策需结合业务增长预期。
以上就是 MySQL 数据库性能优化的详细内容,更多关于数据库调优的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















