


MySQL存储过程、函数与游标详解

本文深入解析MySQL数据库中的存储过程与函数,从基本语法的结构出发,详细说明了IN、OUT和INOUT参数的具体用法与区别。文章逐步演示了如何在过程体中声明局部变量、使用SET语句赋值以及运用SELECT INTO获取数据。通过多重IF判断、CASE表达式及While/Repeat循环等流程控制语句的实战范例,展示如何封装复杂的业务逻辑。此外,还介绍了光标的完整生命周期(声明、打开、提取、关闭),并提供数据表间数据迁移的代码示例,最后梳理了存储过程与函数的关键差异及应用场景。
结果或目标
将常用的SQL逻辑封装为存储过程或函数,通过调用实现特定业务功能,如条件查询、数据计算及批量处理,从而减少客户端与服务端的数据传输,提升执行效率。
准备条件
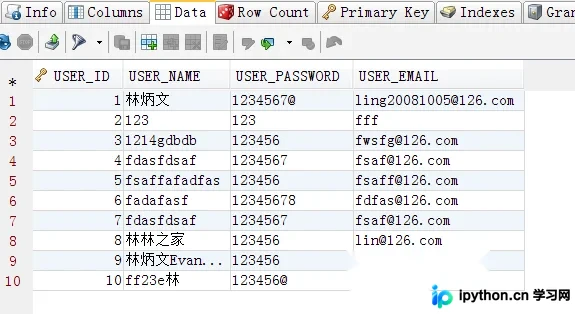
在开始编写存储过程之前,需要确保存在测试用的数据表结构。例如创建一个用户表 t_user,包含用户ID、名称、密码和邮箱字段:
CREATE TABLE t_user (
  USER_ID INT NOT NULL AUTO_INCREMENT,
  USER_NAME CHAR(30) NOT NULL,
  USER_PASSWORD CHAR(10) NOT NULL,
  USER_EMAIL CHAR(30) NOT NULL,
  PRIMARY KEY (USER_ID),
  INDEX IDX_NAME (USER_NAME)
) ENGINE=InnoDB DEFAULT CHARSET=utf8;
插入测试数据后:
真实操作顺序
第1步:掌握存储过程基本语法
创建存储过程的标准格式如下。其中 routine_body 是主体部分,以 BEGIN 开始,END 结束,包含多条SQL语句时通常需要使用分隔符修改以避免冲突。
DELIMITER //
CREATE PROCEDURE sp_name ([proc_parameter[,...]])
BEGIN
 -- SQL statements
END //
DELIMITER ;
常用特征参数说明:
COMMENT 'string':描述内容。DETERMINISTIC/NOT DETERMINISTIC:确定性与非确定性。DYNAMIC RESULT SETS N:指定动态结果集数量。SIGNAL SQLSTATE...:自定义异常。SQLEXCEPTION:SQL异常处理。
第2步:理解参数类型 IN、OUT 和 INOUT
(1) 带 IN 的存储过程(输入参数):
常用于传入条件进行查询。注意因内部包含分号导致命令截断,需更改语句结束符为 //。
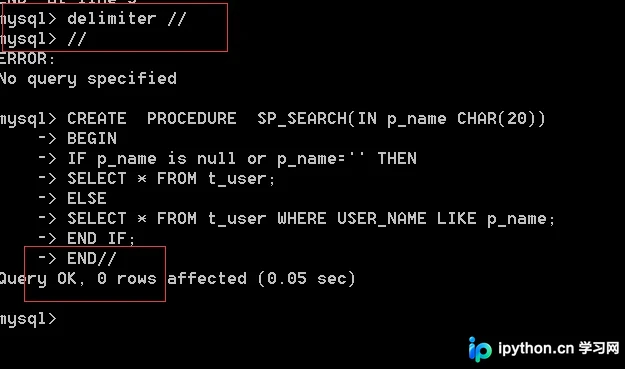
// 创建储存过程. cmd 中运行
CREATE PROCEDURE SP_SEARCH(IN p_name CHAR(20))
BEGIN
 IF p_name is null or p_name='' THEN
   SELECT * FROM t_user;
 ELSE
   SELECT * FROM t_user WHERE USER_NAME LIKE p_name;
 END IF;
END
调用示例:
CALL SP_SEARCH('林炳文')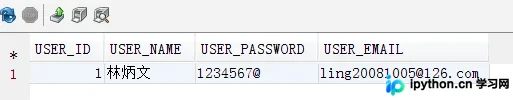
(2) 带 OUT 的存储过程(输出参数):
返回值给调用者,常结合 FOUND_ROWS() 统计数量。需注意变量作用域,调用时需要使用用户会话变量 @p_num。
//带OUT返回的
CREATE PROCEDURE SP_SEARCH2(IN p_name CHAR(20),OUT p_int INT)
BEGIN
 IF p_name is null or p_name='' THEN
   SELECT * FROM t_user;
 ELSE
   SELECT * FROM t_user WHERE USER_NAME LIKE p_name;
 END IF;
 SELECT FOUND_ROWS() INTO p_int;
END
调用并查看统计行数:
CALL SP_SEARCH2('林%',@p_num);
SELECT @p_num; 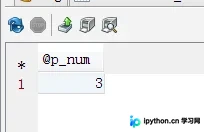
(3) 带 INOUT 的存储过程(可进可出):
既接收初始值也返回计算后的新值,常用于计数器或累加运算。
//带INOUT的存储过程
CREATE PROCEDURE sp_inout(INOUT p_num INT)
BEGIN
 SET p_num=p_num*10;
END
//调用并输出结果
SET @p_num=2;
call sp_inout(@p_num);
SELECT @p_num; 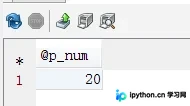
第3步:构建存储过程体与变量使用
存储过程内部支持多种语法元素来封装复杂逻辑:
1、声明局部变量:
必须在 BEGIN...END 块的头部声明,不能带 @ 符号。推荐使用默认值初始化。
DECLARE var_name type DEFAULT value;
Declare cid int(10) DEFAULT 0;2、赋值语句:
使用 SET 直接赋值或通过 SELECT ... INTO 将查询结果存入变量。
Set var_name = expr;
Select col_name into var_name from table_name;3、处理程序(Handler):
用于捕获错误(如 SQLEXCEPTION)。定义时必须放在变量声明之后。
DECLARE handler_type HANDLER FOR condition_value BEGIN statement_list END;
CONTINUE | EXIT | UNDO
第4步:应用流程控制语句(IF/CASE/循环)
(1) If 语句
适用于多分支判断。例如根据分数等级返回对应数据集:
准备成绩表与学生表:
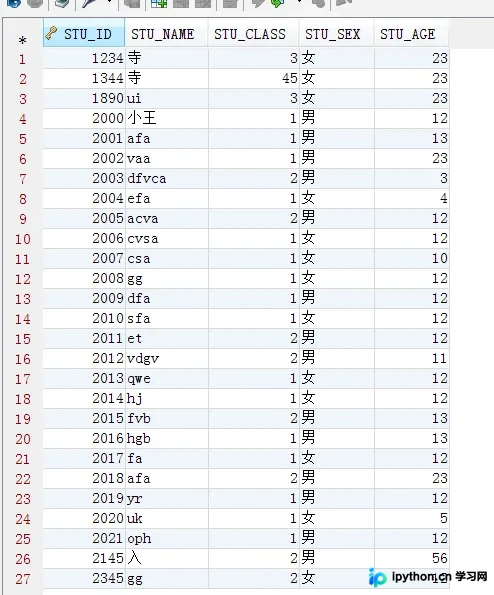
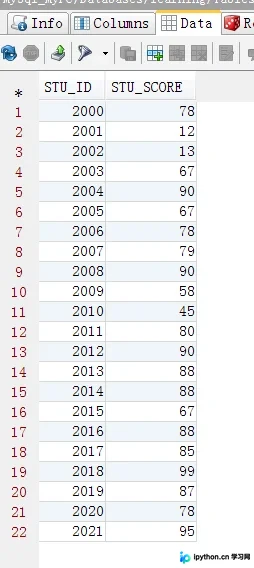
CREATE TABLE t_student (...); CREATE TABLE t_grade(...); 存储过程:
CREATE PROCEDURE SP_SCHOLARSHIP_LEVEL(IN p_level char(1))
BEGIN
 IF p_level ='A' THEN
   SELECT * FROM t_grade WHERE STU_SCORE >=90;
 ELSEIF p_level ='B' THEN
   SELECT * FROM t_grade WHERE STU_SCORE<90 AND STU_SCORE>=80;
 ...
 END IF;
END
调用效果:
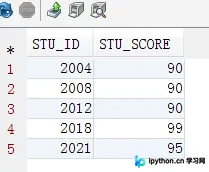
(2) Case 语句
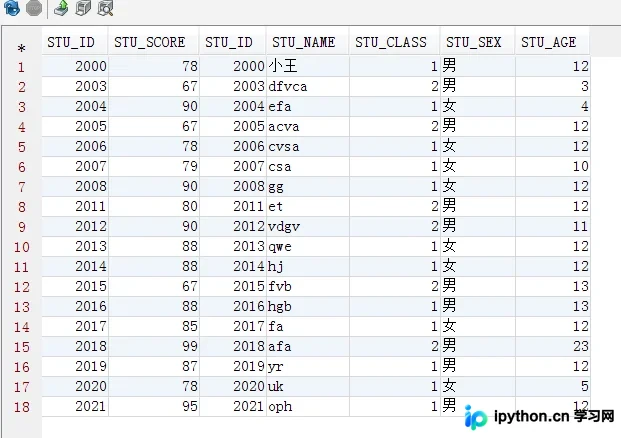
当需要根据常量匹配并设置中间变量时非常有用。以下范例先用 CASE 判定级别对应的分数线 p_num,再统一检索:
CREATE PROCEDURE SP_SCHOLARSHIP_LEVEL3(IN p_level char(1))
BEGIN
 DECLARE p_num int DEFAULT 0;
 CASE p_level
 WHEN 'A' THEN SET p_num=90;
 WHEN 'B' THEN SET p_num=80;
 WHEN 'C' THEN SET p_num=70;
 WHEN 'D' THEN SET p_num=60;
 ELSE SET p_num=0;
 END CASE;
 SELECT * FROM t_grade g, t_student s WHERE g.STU_ID=s.STU_ID AND g.STU_SCORE >= p_num ;
END CALL SP_SCHOLARSHIP_LEVEL3('d');,显示结果如下:
(3) 循环语句
While 语句(先判断后执行):
WHILE search_condition DO statement_list END WHILE;CREATE PROCEDURE sp_cal(IN p_num INT,OUT p_result INT)
BEGIN
SET p_result=1;
WHILE p_num > 1 DO
SET p_result = p_num * p_result;
SET p_num = p_num-1;
END WHILE;
END 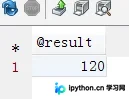
REPEAT statement_list UNTIL search_condition END REPEAT;第5步:游标(Cursor)的使用
游标主要用于逐行处理查询集。使用步骤包括:声明游标、打开游标、Fetch获取、关闭游标。
在存储过程中,通常需要配合一个标记变量来判断是否到达数据集末尾。标准模式如下:
1. 声明记录结束标志:
DECLARE done INT DEFAULT 0;2. 声明游标(需在变量之后):
DECLARE mycur CURSOR FOR SELECT * FROM test_cur1;3. 声明 Continue Handler:当 SQLSTATE '02000'(未找到数据)发生时,修改标志位:
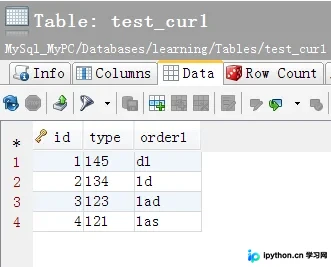
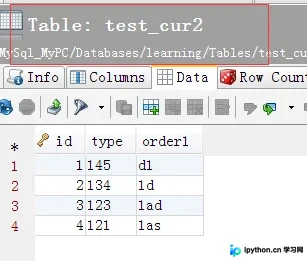
DECLARE CONTINUE HANDLER FOR SQLSTATE '02000' SET done = 1;完整范例:表数据复制(test_cur1 -> test_cur2)
create procedure get_cur ()
BEGIN
 DECLARE done INT DEFAULT 0;
 DECLARE ID int(11);
 DECLARE type char(11);
 DECLARE order1 char(11);

 DECLARE mycur CURSOR FOR SELECT * FROM test_cur1;
 DECLARE CONTINUE HANDLER FOR SQLSTATE '02000' SET done = 1;

 OPEN mycur;
 REPEAT
   FETCH mycur INTO ID, type, order1;
   IF NOT done THEN
     INSERT INTO test_cur2 VALUES (ID,type,order1);
   END IF;
 UNTIL done END REPEAT;
 CLOSE mycur;
END
执行结果:
这是源表:
这是目标表:
第6步:创建与调用函数
函数必须包含 RETURN 语句,只能返回单一类型的值(标量或结果集),且在函数体内不允许修改全局状态。
比较大小并返回最大值:
CREATE FUNCTION sp_cal_max(p_num1 INT, p_num2 INT) RETURNS INT
BEGIN
 IF p_num1 >= p_num2 THEN RETURN p_num1;
 ELSE RETURN p_num2;
 END IF;
END
调用方式直接在 SELECT 中使用:
SET @p_num1=2; SET @p_num2=34; SELECT sp_cal_max(@p_num1,@p_num2); 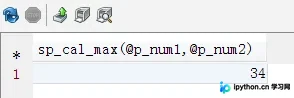
完成判断
若存储过程或函数创建成功且无报错,表示语法正确;若通过调用能够准确获得预期的查询结果集、返回值或实现了指定的数据变更,则说明逻辑符合预期。
原文有依据的排错
在编写存储过程时使用分号作为结束符会导致 MySQL 提前截断代码引发错误,务必在使用命令行工具前通过 DELIMITER // 改变默认的定界符。
局部变量只能在 BEGIN..END 块内有效;而用户变量(如 @varname)在整个会话期间都可见。
在创建函数时,如果没有明确定义返回值的类型或者未在函数体中使用 RETURN 关键字,将会触发创建失败异常。
简要总结
存储过程在处理复杂的多步数据库事务、涉及多张表的增删改操作时更具优势,可以灵活利用游标迭代数据;而函数由于受到“纯函数”性质的限制,更适合做轻量级的数值计算和逻辑转换,并且可以直接嵌入到 SELECT 语句中作为字段的一部分参与筛选排序。
以上就是MySQL存储过程、函数与游标详细内容的资料,更多关于MySQL数据库编程的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















