


MySQL与Lucene索引机制深度解析及应用场景对比

MySQL与Lucene(常用于ElasticSearch等搜索引擎)均依赖索引提升数据检索效率,但两者的底层逻辑截然不同。MySQL主要采用B+树结构处理关系型数据的精准与范围查找,而Lucene则使用倒排索引(Inverted Index)以实现高效的关键词全文检索。理解两者在数据存储方式、磁盘I/O开销及组合查询能力上的差异,是优化系统性能的关键。
MySQL 索引的实现原理
在MySQL中,索引属于存储引擎级别的概念。不同存储引擎对索引的实现方式存在显著差异,目前主流使用的 MyISAM 和 InnoDB 引擎采用了不同的策略。
MyISAM 的 B+Tree 非聚集索引
MyISAM 引擎使用 B+Tree 作为其索引结构。在该结构中,叶子节点(Leaf Node)的 data 域并不包含完整的数据记录,而是仅存放数据记录的物理地址。
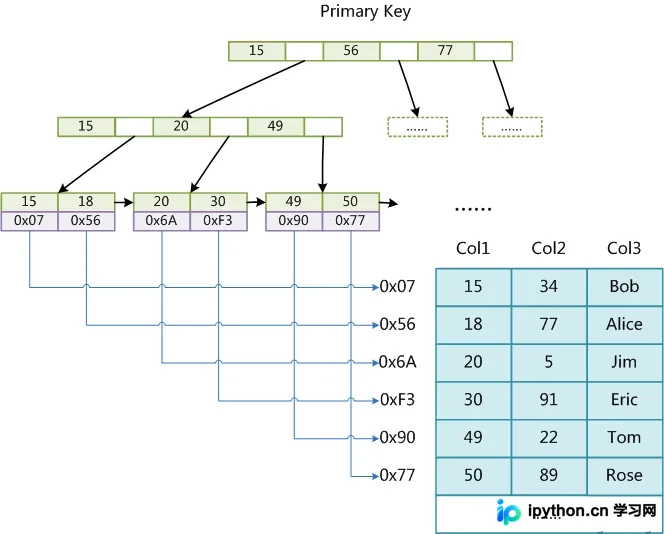
如图1所示,这是一个 MyISAM 表主索引的示意。可以看出,MyISAM 的索引文件仅保存数据记录的“指针”。在结构上,MyISAM 的主索引与辅助索引(Secondary Key)没有区别,唯一的差异在于主索引要求键值(Key)唯一,而辅助索引允许重复。此外,B+Tree 的所有叶子节点包含所有关键字,并按升序排列。
MyISAM 表的索引与数据是完全分离的:索引保存在 .MYI 文件中,而实际数据保存在 .MYD 文件中。这种将索引与数据分离的方式被称为“非聚集索引”,旨在与 InnoDB 的聚集索引形成区分。
InnoDB 的 B+Tree 聚集索引
InnoDB 同样使用 B+Tree,但其实现方式与 MyISAM 完全不同,主要体现在以下两个核心区别:
1. 数据文件即索引文件
在 InnoDB 中,表数据文件本身就是一个按照 B+Tree 组织的索引结构。这棵树的叶子节点 data 域保存了完整的数据记录。该索引的 Key 是数据表的主键(Primary Key),因此 InnoDB 的表数据文件本质上就是其主索引。
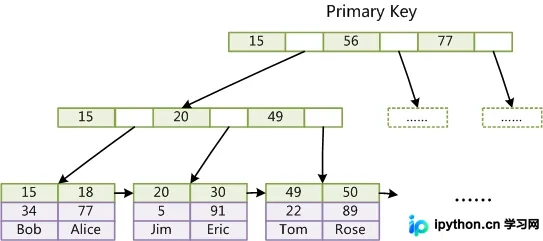
由于 InnoDB 要求按主键聚集数据,因此表必须有主键。若未显式指定,MySQL 会自动选择一个能唯一标识记录的列作为主键;若不存在这样的列,系统会生成一个 6 字节长整型的隐含字段作为主键。
2. 辅助索引存储主键而非地址
InnoDB 的所有辅助索引(Secondary Index)的 data 域存储的是对应记录的主键值,而不是物理地址。
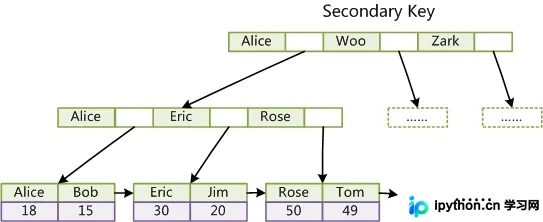
这意味着,InnoDB 的辅助索引搜索需要进行“两遍扫描”:
第一步:在辅助索引中检索获取主键值。
第二步:利用主键回到主索引(聚集索引)中检索获取完整的记录数据。
设计启示:鉴于上述机制,不建议使用过长的字段作为主键,因为这会增加所有辅助索引的大小。同时,使用自增字段作为主键优于非单调字段,因为后者会导致 B+Tree 频繁分裂调整,降低插入效率。
Lucene 的倒排索引实现
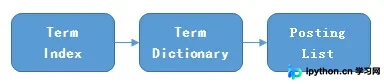
与传统数据库不同,Lucene 不使用 B+Tree 组织索引,而是采用倒排索引(Inverted Index)。倒排索引由三个核心部分组成:Term Index(术语索引)、Term Dictionary(术语词典)和 Posting List( posting列表)。
正排索引 vs 倒排索引
正排索引是文档(Document)与其字段(Fields)的正向对应关系:
- DocID: 1, name: jack, sex: 男, age: 18
- DocID: 2, name: lucy, sex: 女, age: 17
- DocID: 3, name: peter, sex: 男, age: 17
倒排索引则是字段内容(Term)到拥有该内容的文档 ID 集合的映射:
- Sex 字段:“男” -> [1, 3],“女” -> [2]
- Age 字段:“18” -> [1],“17” -> [2, 3]
其中,像“jack”、“17”这样的具体内容称为 Term,而 [1, 3] 称为 Posting List,它是一个存储符合某 Term 的文档 ID 数组。
如何高效查找 Term:Term Dictionary 与 Term Index
如果直接遍历未排序的 Term 列表,查找效率极低。Lucene 对 Term 进行排序以支持二分查找,这个排序后的字典结构称为 Term Dictionary。然而,将整个巨大的 Term Dictionary 加载到内存中是不现实的,且随机读磁盘代价昂贵。
为了解决这个问题,Lucene 引入了 Term Index。它类似于书本的大目录,通过前缀快速定位。
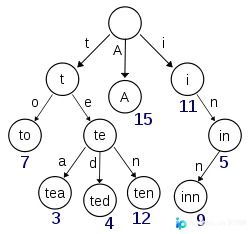
Term Index 通常是一棵 Trie 树(如图所示),但它不存储所有 Term,仅存储部分前缀节点。通过 Term Index,可以快速定位到磁盘上 Term Dictionary 的偏移量,再进行局部顺序查找。为了进一步节省内存,Lucene 使用了压缩技术(如 Finite State Transducers, FST),使得 Term Index 极小,足以完全缓存至内存中。
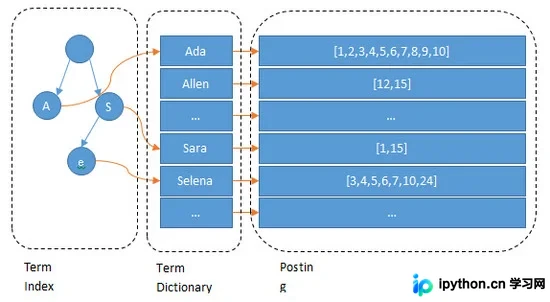
查询流程总结:从 Term Index 定位到 Term Dictionary 中的具体位置,找到对应的 Posting List,从而获得最终的文档 ID 列表。对于多关键字查询,只需对多个 Posting List 进行交集(AND)或并集(OR)运算即可。
MySQL 与 Lucene 索引的核心差异
通过对比 MySQL 的 B+Tree 与 Lucene 的倒排索引,可以得出以下关键结论:
- 功能等价性:Lucene 的 Term Index/Dictionary 在功能上相当于 MySQL 的 B+Tree,均为关键字提供索引。但在海量文本检索场景下,倒排索引的效率通常高于 B+Tree。
- 内存与磁盘 I/O:Lucene 的 Term Index 在内存中以 FST 形式保存,占用空间极小且检索速度极快,几乎无需磁盘 I/O。相比之下,MySQL 的 B+Tree 在数据量大时,需要频繁读取磁盘页进行比较。
- 存储空间:Lucene 的 Term Dictionary 采用分块存储并利用公共前缀压缩技术(如去除相同的词头),相比 B+Tree 能更有效地节约磁盘空间。
- 数据类型适配:Lucene 针对不同数据类型提供了专门的索引类型,例如针对整数使用 TrieIntField,针对经纬度使用 GeoHash 编码,灵活性更高。
- 组合查询能力:MySQL 中对两个独立字段建立的索引无法自动联合使用,通常需要建立复合索引;而 Lucene 可以利用倒排索引天然地支持任意字段的 AND/OR 组合检索。
以上就是 MySQL 和 Lucene 索引机制对比分析的详细内容,更多关于数据库设计与搜索引擎优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















