


Python Pandas Series 完全指南:创建、索引与数据处理

本文详细介绍 Pandas 中 Series 数据结构的创建、索引机制及常用操作方法。涵盖通过列表和字典构建 Series,掌握位置索引与标签索引的区别,演示花式索引与布尔索引技巧。同时深入解析 describe、value_counts、去重、空值处理(dropna/fillna)及排序取 Top-N 等核心函数的使用,帮助开发者高效处理一维数据。
Pandas 应用概述
Pandas 的核心数据类型主要包括 Series(数据系列)和 DataFrame(数据框/数据表),它们分别用于处理一维和二维数据。
此外,还有一个 Index 类型的子类型,它为 Series 和 DataFrame 提供了索引功能支持。
创建 Series 对象
Series 对象用于表示一维数据结构,其形态与数组非常相似,但具备更多高级功能。
Series 的内部结构由两个数组组成:一个用于存储实际数据,另一个用于存储数据的索引。
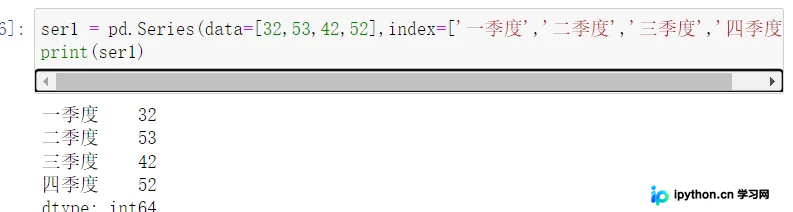
此外,还可以使用字典格式来创建 Series 对象。
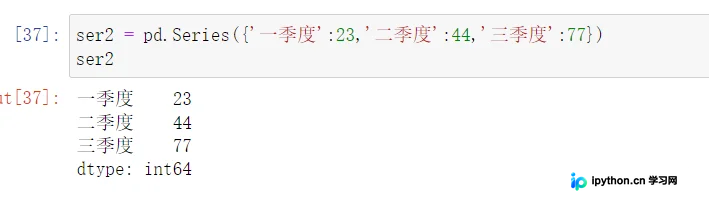
索引操作
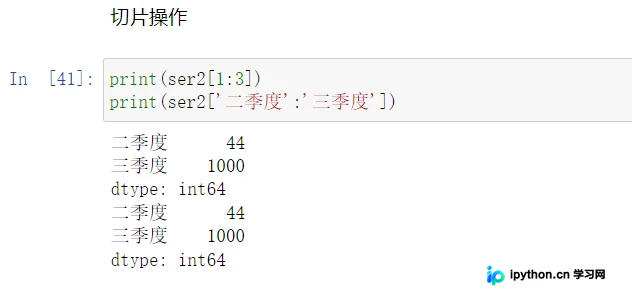
Series 对象支持索引和切片操作。与普通数组不同的是,Series 内部维护了一个专门的索引数组,这使得索引机制更加灵活。
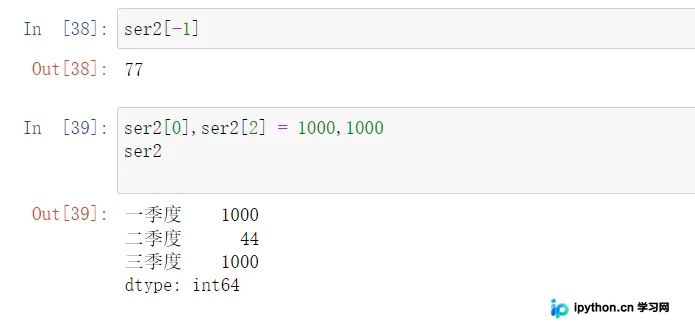
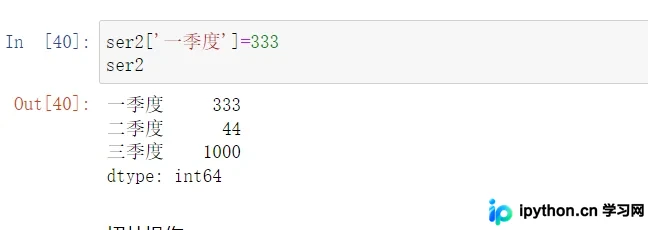
除了使用整数索引通过位置检索数据外,还可以通过自定义的标签来获取对应的数据值。
第一种方式:通过位置索引并修改数据
第二种方式:使用自定义标签进行访问
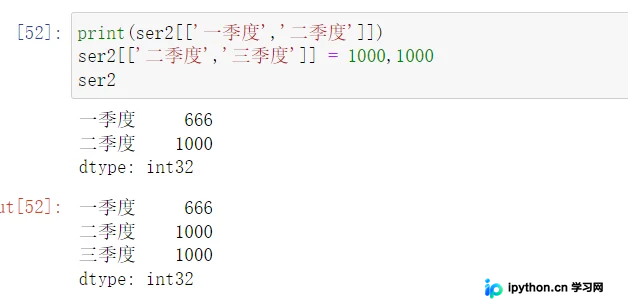
花式索引
花式索引与普通索引的主要区别在于,花式索引的最外层使用方括号 [ ] 包裹。
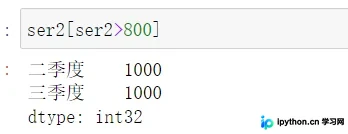
布尔索引
布尔索引主要用于判断列表中数值的范围,返回布尔值序列。
Series 对象的常用属性与方法
# 求和
print(ser2.sum())
# 求均值
print(ser2.mean())
# 求最大
print(ser2.max())
# 求最小
print(ser2.min())
# 计数
print(ser2.count())
# 求标准差
print(ser2.std())
# 求方差
print(ser2.var())
# 求中位数
print(ser2.median())
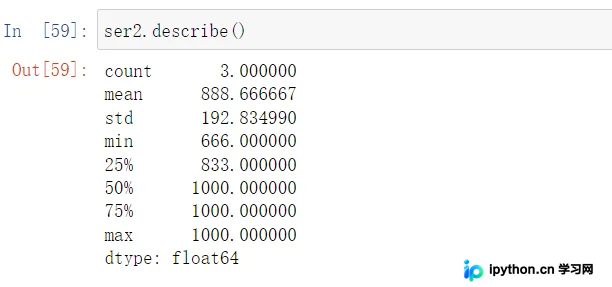
describe() 方法
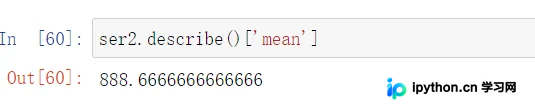
describe() 方法可以获取上述所有的描述性统计信息,包括方差、标准差、中位数等统计指标。
对于特定的单个值,也可以通过索引方式直接获取。
value_counts() 方法
若要统计每个值重复出现的次数,可使用 value_counts() 方法。该方法返回一个新的 Series 对象,其索引为原 Series 中的值,数据部分为各值出现的次数。默认情况下,结果会按照出现次数进行降序排列。
ser3 = pd.Series(data=['apple', 'banana', 'apple', 'pitaya', 'apple', 'pitaya', 'durian'])
ser3.value_counts()
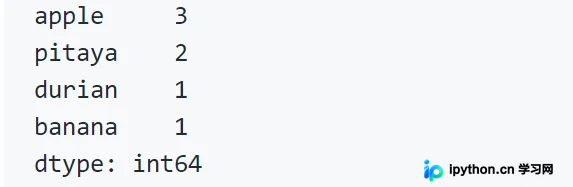
unique() 方法
如果 Series 对象中包含重复值,可以使用 unique() 方法获取去重后的 Series 对象。
还可以使用 nunique() 方法统计不重复值的数量,这是数据处理中的常用方法。
isnull() 和 notnull() 方法
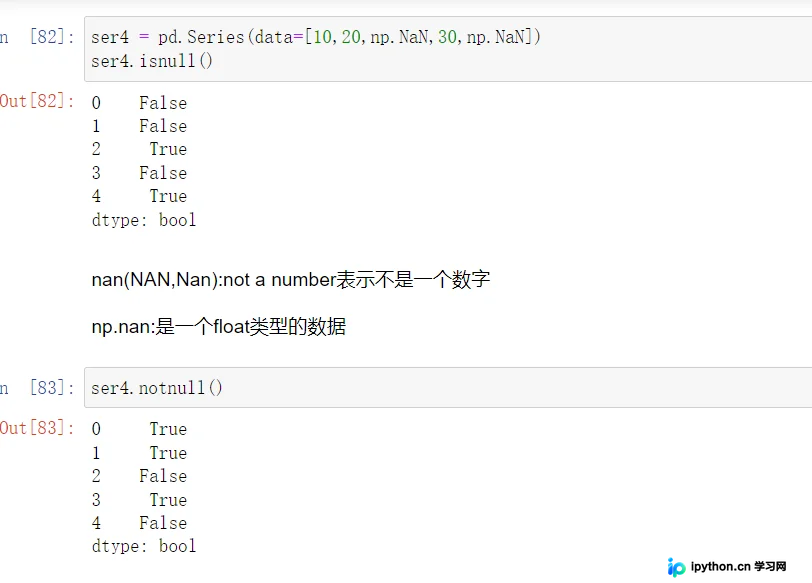
Series 对象的 isnull() 和 notnull() 方法可用于判断数据中是否存在空值。
dropna() 和 fillna() 方法
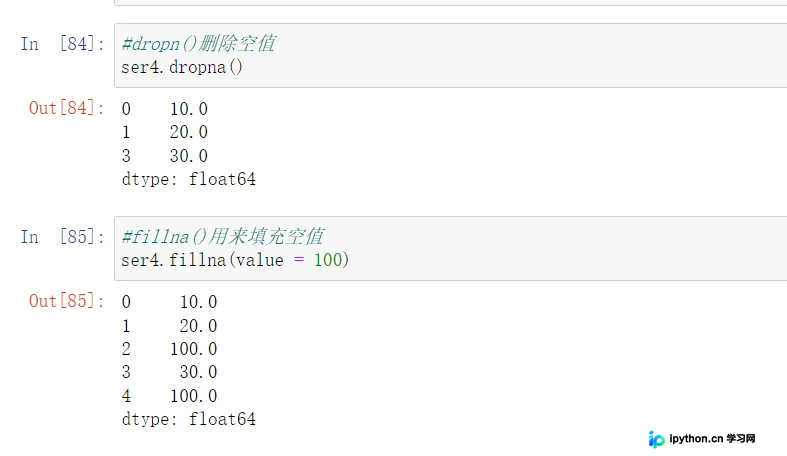
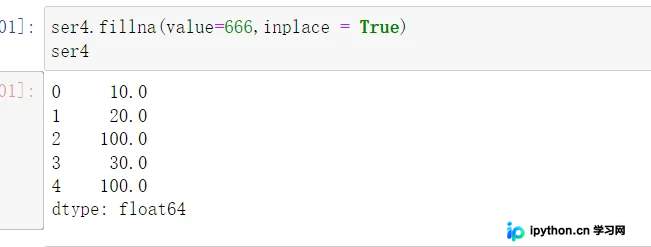
dropna() 和 fillna() 分别用于删除空值和填充空值。这两个方法均包含一个名为 inplace 的参数,默认值为 False,表示操作不会修改原 Series 对象,而是返回一个新的 Series 对象表示处理后的数据。若将 inplace 参数设为 True,则操作会就地执行,直接修改原 Series 对象,此时方法返回值为 None。
后续接触到的许多方法,包括 DataFrame 对象的许多方法,都会包含此参数,其含义与此处一致。
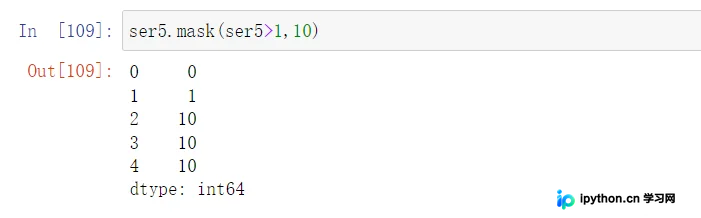
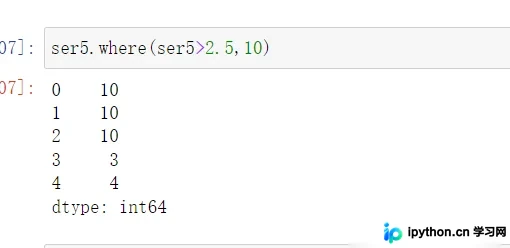
mask() 和 where() 方法
- mask():可以将满足条件的全部替换。
- where():将不满足条件的替换。
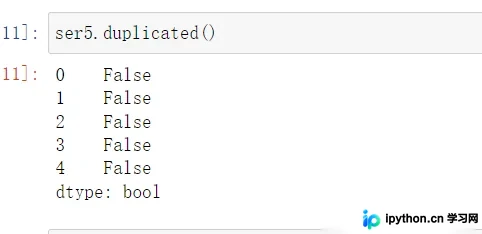
duplicated() 和 drop_duplicates() 方法
- duplicated() 方法可用于找出重复数据,通过返回布尔值显示数据是否重复。
- drop_duplicates() 方法可用于删除重复数据。
apply() 和 map() 方法
map() 可以不依赖索引,直接通过内容对数据进行修改。
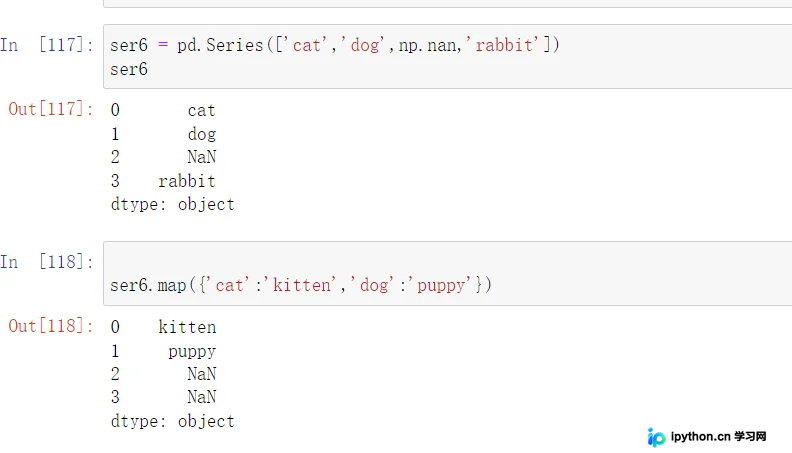
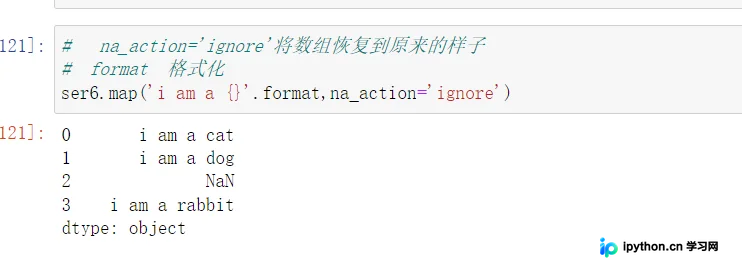
apply() 可以将原始值通过一定的计算逻辑,得到期望的数组结果。
排序和取头部值的方法
Series 对象的 sort_index() 和 sort_values() 方法可用于对索引和数据值进行排序。排序方法包含一个名为 ascending 的布尔类型参数,用于控制排序结果是升序还是降序。
名为 kind 的参数用于控制排序使用的算法,默认使用 quicksort,用户也可以选择 mergesort 或 heapsort。
如果存在空值,可以使用 na_position 参数指定空值放在最前还是最后,默认值为 last(放在最后)。
- sort_values() 按值从小到大排序
- sort_values(ascending=False) 按值从大到小排序
取头部值
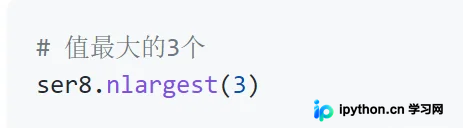
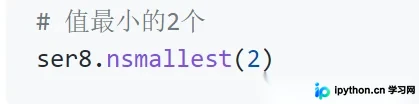
若要从 Series 对象中找出最大或最小的“Top-N”元素,实际上无需对所有值进行完整排序,可以使用 nlargest() 和 nsmallest() 方法来完成。
总结
以上为个人经验总结,希望能给大家一个参考,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















