TensorFlow中从TXT文件读取数据的两种常用方法
本文介绍了在TensorFlow项目中从TXT文件读取数据的两种主流方法:使用numpy的loadtxt函数和pandas的read_csv函数。文章详细展示了两种方法的代码实现,并重点强调了读取后的数据形状必须与模型定义的placeholder保持一致,以确保后续训练流程的顺利进行。
10-13
6




本文介绍了在TensorFlow项目中从TXT文件读取数据的两种主流方法:使用numpy的loadtxt函数和pandas的read_csv函数。文章详细展示了两种方法的代码实现,并重点强调了读取后的数据形状必须与模型定义的placeholder保持一致,以确保后续训练流程的顺利进行。
本文深入解析Python中的数据抽样技术,涵盖随机、系统、分层和整群四种基本方法及其多阶段应用。通过Pandas和Random库的代码示例,展示具体实现步骤,并详细阐述数据时效性、关键因素保留、分布均衡及不同分析场景下的数据量要求,帮助开发者构建高质量的数据集。
本文介绍在pandas中如何将数据框内所有大于0的数值统一替换为1。核心方法是通过布尔条件df>0生成掩码,并直接对匹配位置赋值1。该操作适用于数据标准化或二值化处理场景,代码简洁高效,适合初学者参考。
本文介绍如何在pandas中利用apply函数结合多列数据生成新列。通过定义接收多个参数的自定义函数,并设置axis=1逐行处理,实现复杂逻辑计算。示例展示了如何基于diff和shift生成的相邻行数据,计算绝对值最小值,为复杂数据变换提供参考。
本文介绍使用NumPy对矩阵进行归一化的具体实现方法。核心在于将均值、最大值和最小值的计算结果预先存储为变量,避免在循环中重复计算,从而显著提升处理速度。文章提供了简洁的五行代码示例及关键注意事项,适用于需要高效数据预处理的Python开发场景。
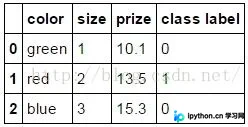
本文介绍在pandas中利用get_dummies函数对离散特征进行one-hot编码的方法。针对无序分类特征如颜色,可直接使用get_dummies生成独热向量;针对有序特征如尺码,则建议先通过字典映射转换为数值。文章提供了具体的DataFrame构建、映射及编码代码示例,帮助开发者高效完成数据预处理。
本文介绍在Python中如何遍历指定文件夹以获取所有文件名称,并将结果写入列表或文本文件。通过os.walk和os.listdir两种方法,分别实现递归遍历子目录和非递归获取指定类型文件的功能,适用于深度学习等需要批量处理数据的场景。
本文以Kaggle Titanic竞赛数据为例,详细讲解使用Pandas进行数据预处理的完整流程。内容涵盖数据加载、维度与类型检查、缺失值填充策略(丢弃或填充)、数值特征离散化及类别变量映射,以及通过GroupBy和Pearson系数分析特征与目标变量的关系,为后续模型构建奠定基础。
本文详细介绍Python中三种常用的数据归一化算法:Min-Max、Z-score及小数定标。通过公式解析、逻辑步骤与完整代码示例,阐述各方法的适用场景与局限性,帮助开发者在建模前有效消除量纲影响并提升模型精度。
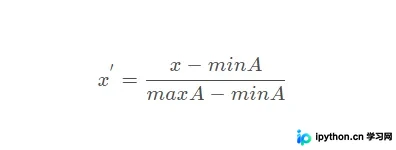
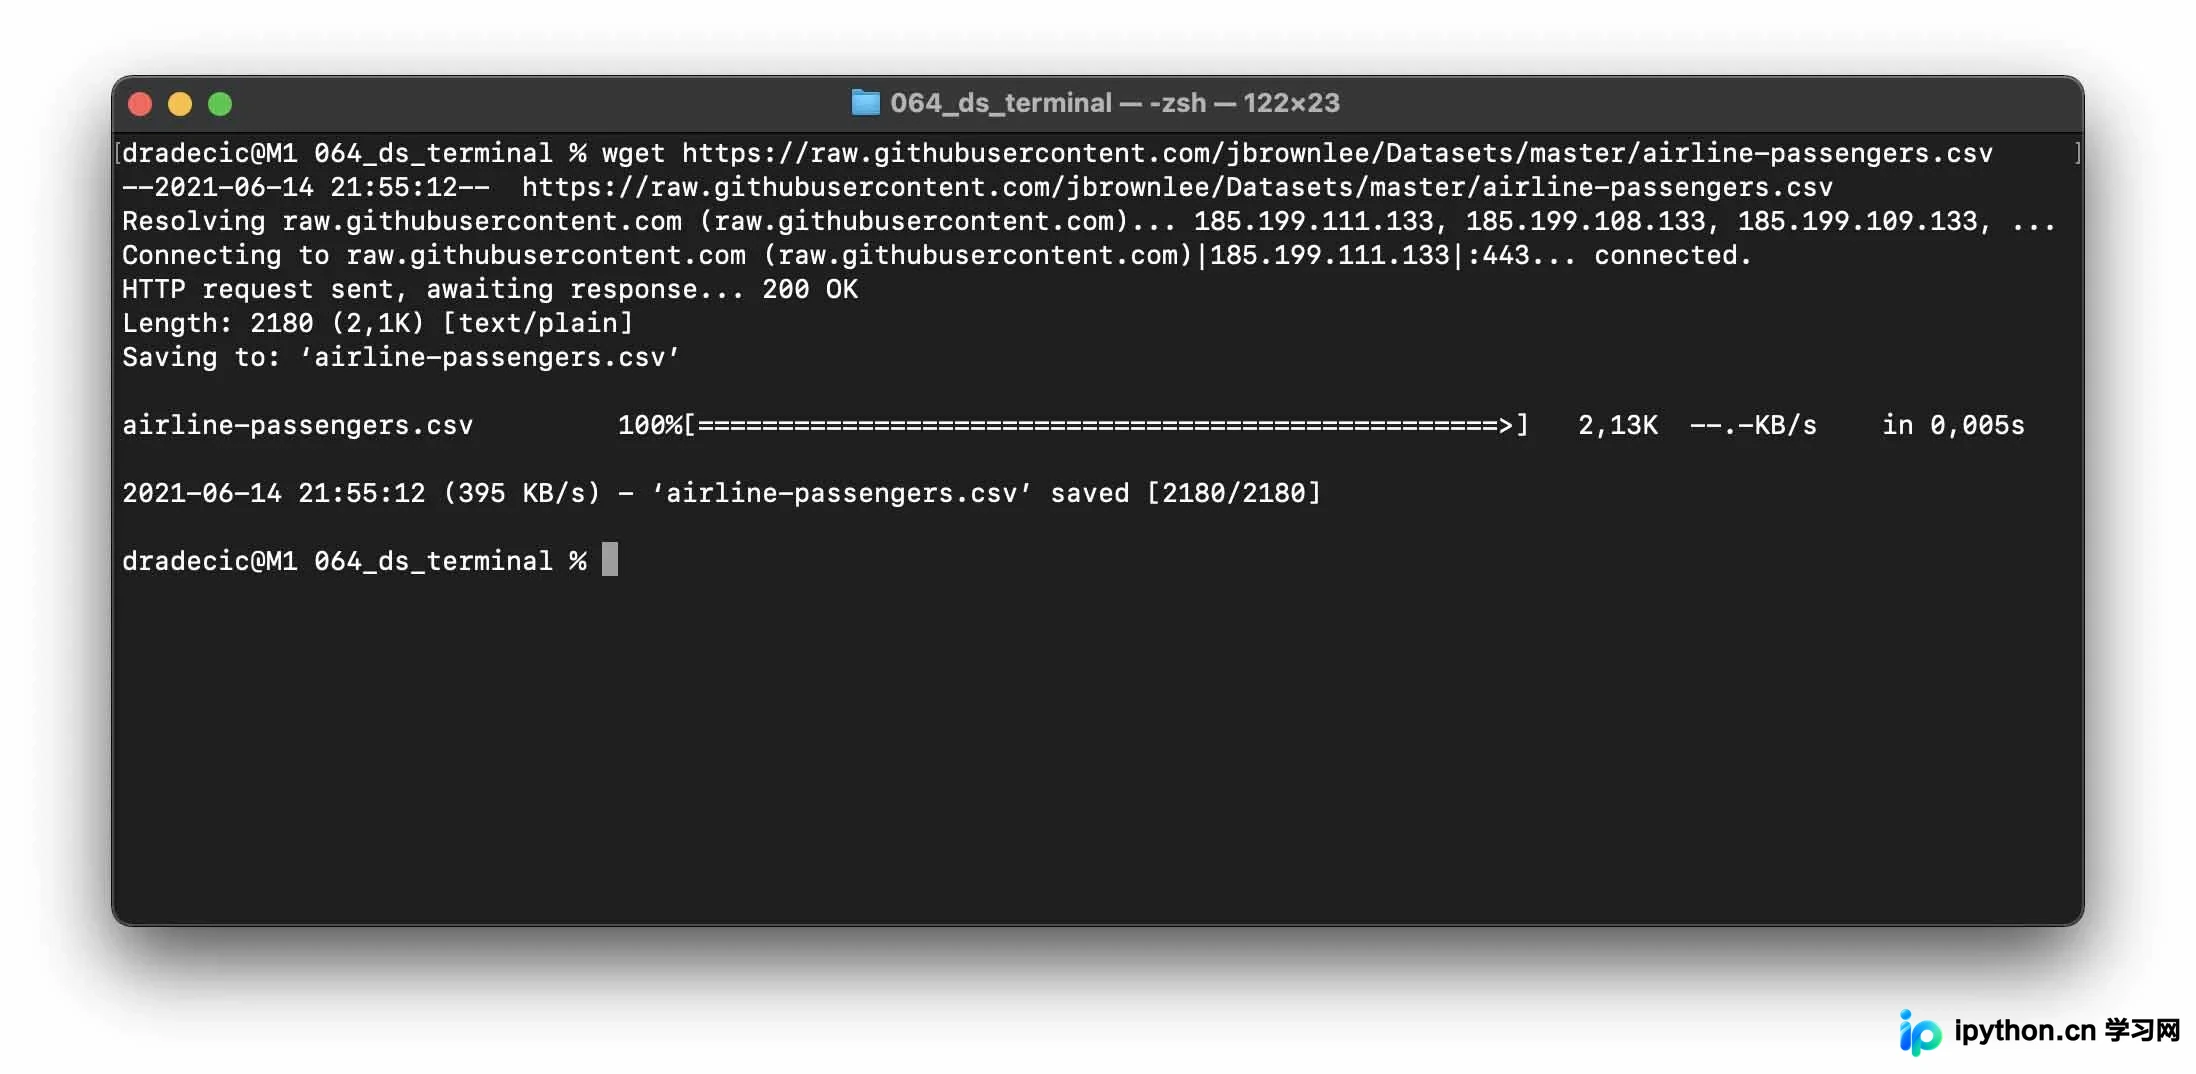
本文介绍了Python数据科学家在部署模型和处理数据管道时常用的10个终端命令。涵盖wget下载、head/tail查看文件、wc统计行数、grep筛选数据、cat查看内容、find查找文件、sort排序、nano编辑代码以及变量使用。这些基础命令能显著提升数据处理效率,是入门数据挖掘的必备技能。
本文深入解析Python中常用的数据标准化方法,包括Min-Max归一化、Z-Score标准化以及针对稀疏和离群数据的MaxAbs与RobustScaler。通过具体代码实例展示StandardScaler的使用,并对比不同算法对数据结构及异常点的影响,帮助开发者根据数据特征选择最优标准化策略。
本文介绍在 Pandas 中快速筛选包含特定字符列的三种常用方法:利用 if 判断结合列表推导式、使用 str.contains 配合列表解析,以及调用 DataFrame 的 filter 函数。重点解析 filter 函数的 like、regex 和 item 参数,展示如何结合行与列条件进行精准数据提取,并提供完整代码示例供参考。



