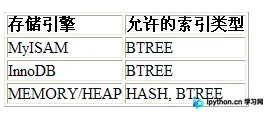
Python数据库连接池的作用及DBUtils配置方法详解
深入讲解Python数据库连接池的核心作用、底层工作机制,以及DBUtils中PooledDB的详细配置参数、工程化单例封装与生产调优避坑指南。
10-22
9




深入讲解Python数据库连接池的核心作用、底层工作机制,以及DBUtils中PooledDB的详细配置参数、工程化单例封装与生产调优避坑指南。
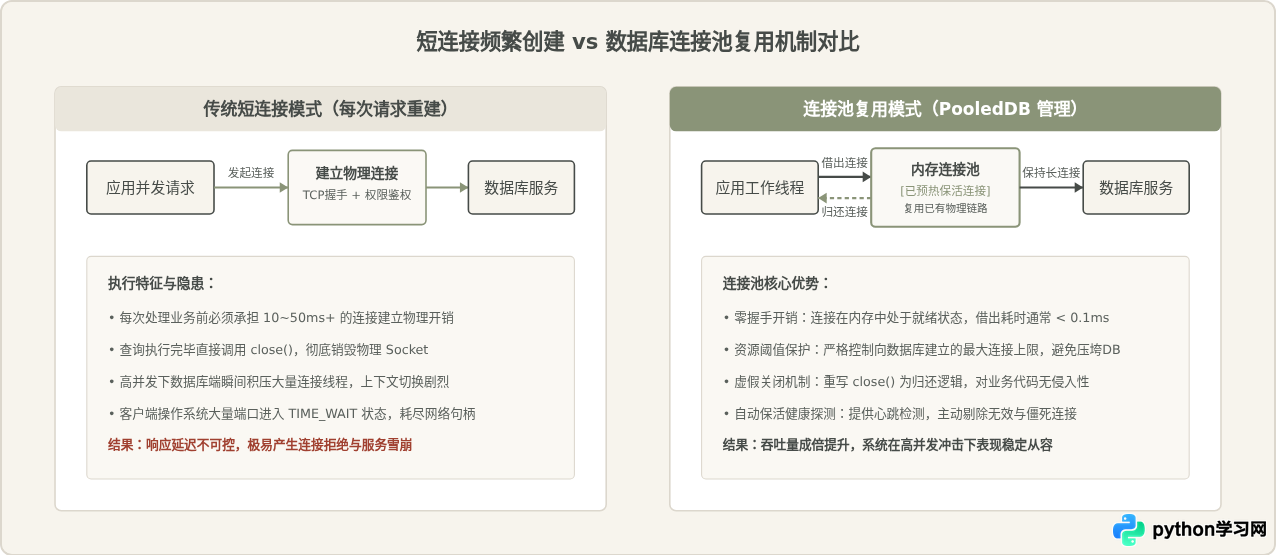
许多开发者误以为 MySQL 中 WHERE name IS NULL 会导致索引失效,实则不然。本文通过 innodb_ruby 工具与二进制文件分析,揭示 NULL 值在 B+ 树中的存储位置;并通过案例复现证明,所谓“索引失效”通常是由于条件匹配行数过多(如 >20%)导致回表成本高于全表扫描,由 Optimizer 主动放弃索引所致。
在MySQL中,使用UNSIGNED INT存储IPv4地址比VARCHAR更节省空间且查询更快。本文详解利用INET_ATON和INET_NTOA函数实现字符串IP与整数的相互转换,并提供Java应用层转换逻辑及IPv6的VARBINARY方案,帮助开发者构建高效的数据库存储结构。
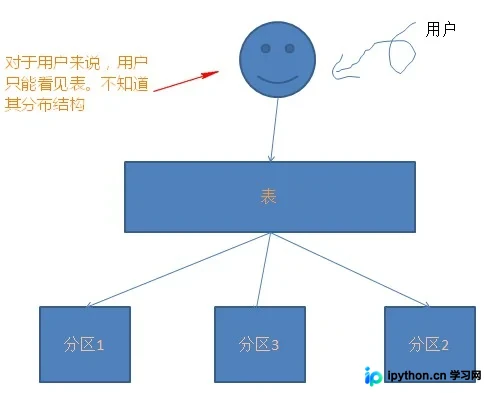
本文详细介绍 SQL Server 中分区表的原理与操作。通过定义分区函数和分区构架,可将大表拆分至不同文件组以提升查询性能并简化备份。文中演示了如何新建分区表、使用 ALTER PARTITION FUNCTION 进行分割与合并,并提醒了高负载下操作的风险。
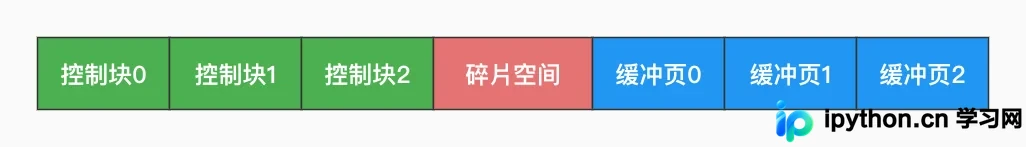
本文解析 MySQL InnoDB 存储引擎的缓冲池(Buffer Pool)机制。内容涵盖内存初始化、LRU链表结构及Young/Old分区算法,以及Flush和Free链表的工作原理。同时提供多实例配置与动态扩容参数设置,帮助理解减少磁盘IO并提升查询命中率的核心方法。
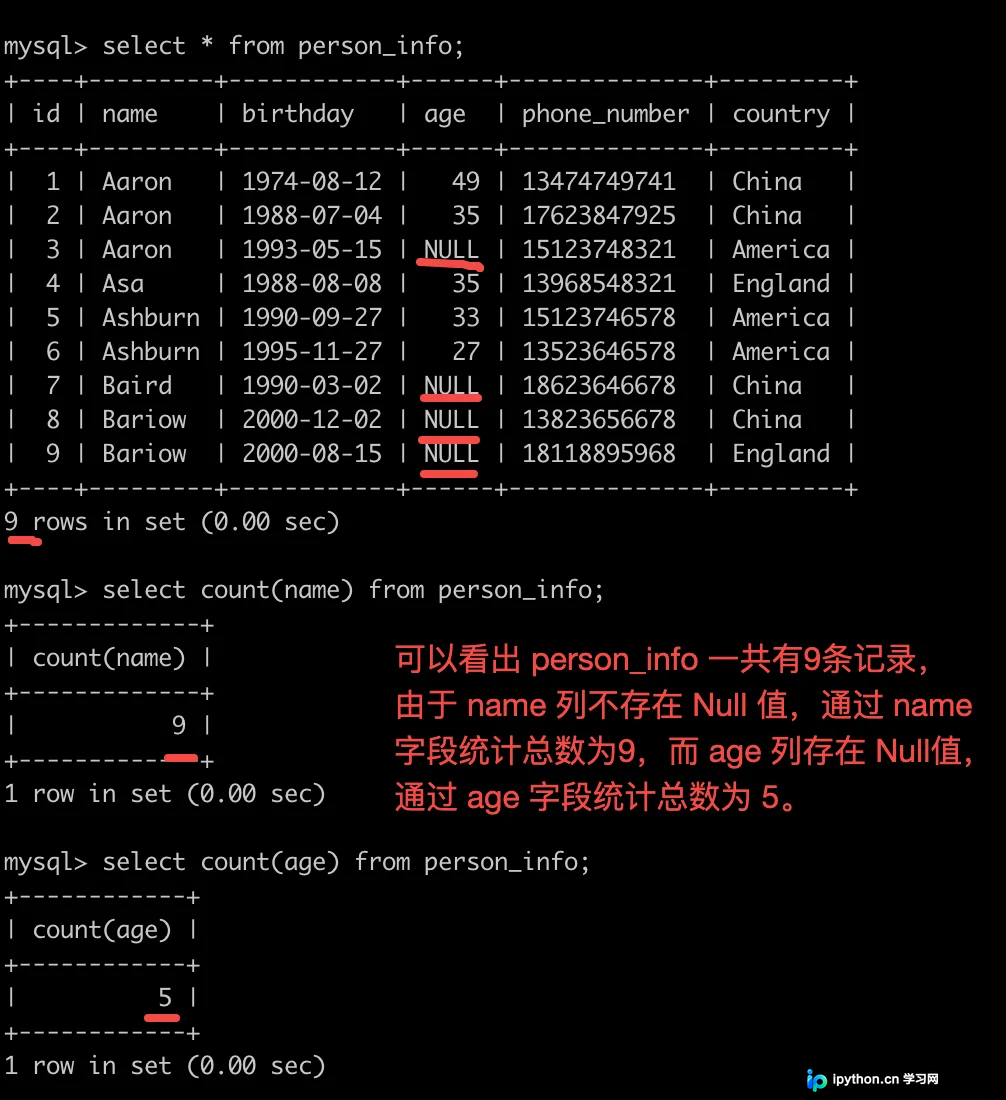
详解 MySQL COUNT 函数的运行逻辑,揭示其统计非 NULL 值的本质。通过 EXPLAIN 分析指出优化器如何选择最小索引提升 count(*) 或 count(常数) 的查询效率,并解释为何特定列即使非空也可能不走索引,帮助开发者写出高效的 SQL 语句。
本文针对SQL Server 2012+的分页语法,深入分析了三种方法:NTILE、ROW_NUMBER()和新的OFFSET-FETCH。通过12.9万条记录测试及执行计划对比,证实OFFSET FETCH虽在CPU消耗上略优于ROW_NUMBER()且无需全表扫描,但IO开销两者基本一致,最终推荐因其语法简洁性而优先使用。
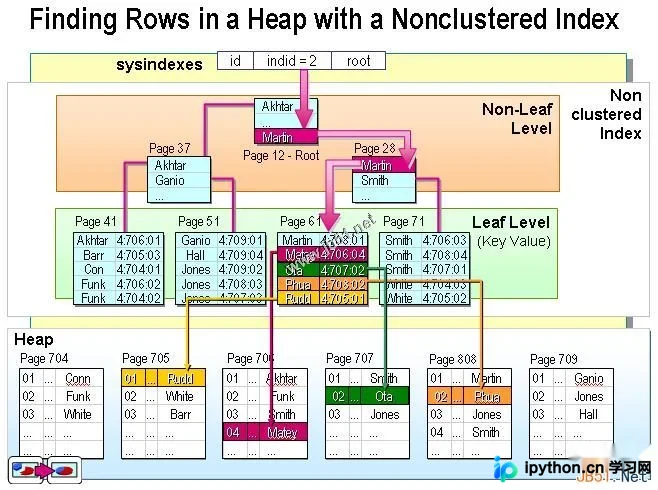
深入解析 SQL 中聚集索引与非聚集索引的核心区别。文章通过字典类比说明物理存储差异,提供基于数据访问模式的选型建议表,并指出主键即聚集索引等常见误区。结合实测数据演示如何建立复合聚集索引以大幅提升查询效率,避免全表扫描。
在MySQL中,使用COUNT(DISTINCT)或GROUP BY时,传统方式会导致全索引扫描。MySQL 5.1+引入Loose Index Scan技术,通过跳过重复键值大幅减少IO。本文详解其适用条件、执行计划特征(Using index for group-by),以及Index Condition Pushdown对非精确匹配场景的补充优化作用。
本文详细解析MySQL数据库性能优化的核心手段,包括B+树索引原理及适用场景。涵盖主键、唯一、普通及全文索引的创建与维护,深入探讨多列索引的最左匹配原则、LIKE查询陷阱及OR语句对索引的影响。同时对比InnoDB与MyISAM存储引擎特性,提供大批量插入、GROUP BY排序优化等实用SQL技巧,助您提升查询效率并保障数据安全。