使用 Spring AI 在 Spring Boot 中构建生成式 AI 应用
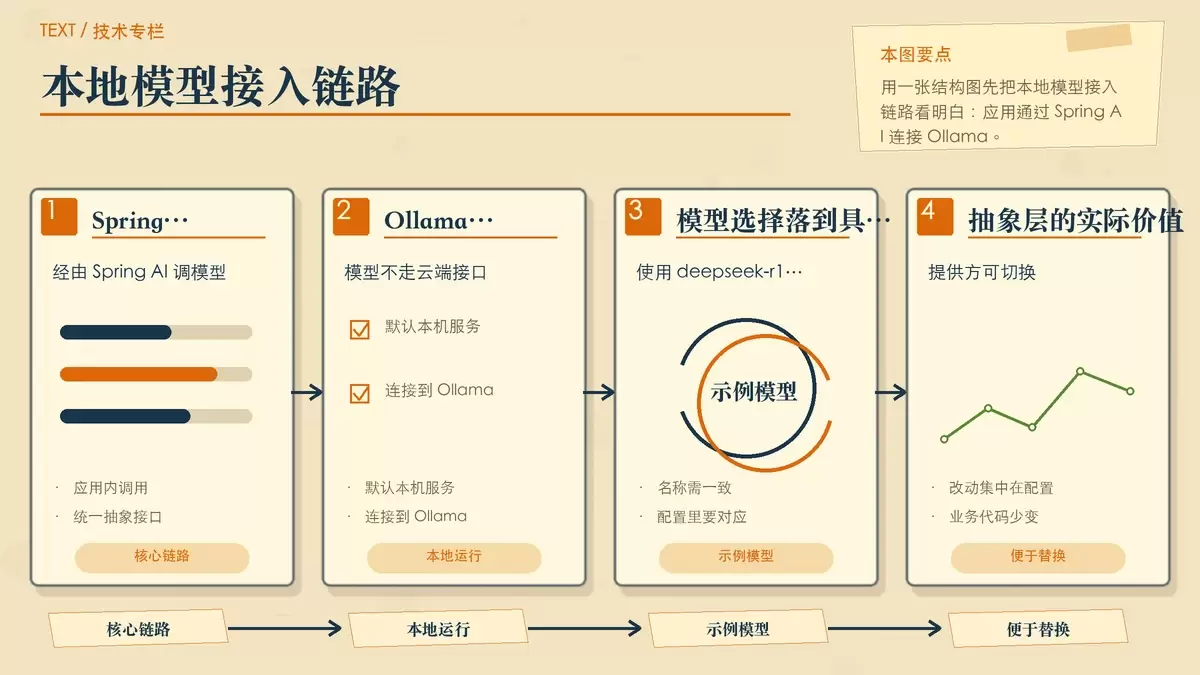
Spring AI 把多家大模型能力抽象进 Spring 生态,适合 Java 开发者在现有项目里快速接入生成式 AI。本文用 Ollama + deepseek-r1:1.5b 做示例,梳理环境要求、依赖配置、控制器写法以及流式返回的改法,帮助你判断它是否适合当前 Spring Boot 项目。
08-25
191




Spring AI 把多家大模型能力抽象进 Spring 生态,适合 Java 开发者在现有项目里快速接入生成式 AI。本文用 Ollama + deepseek-r1:1.5b 做示例,梳理环境要求、依赖配置、控制器写法以及流式返回的改法,帮助你判断它是否适合当前 Spring Boot 项目。
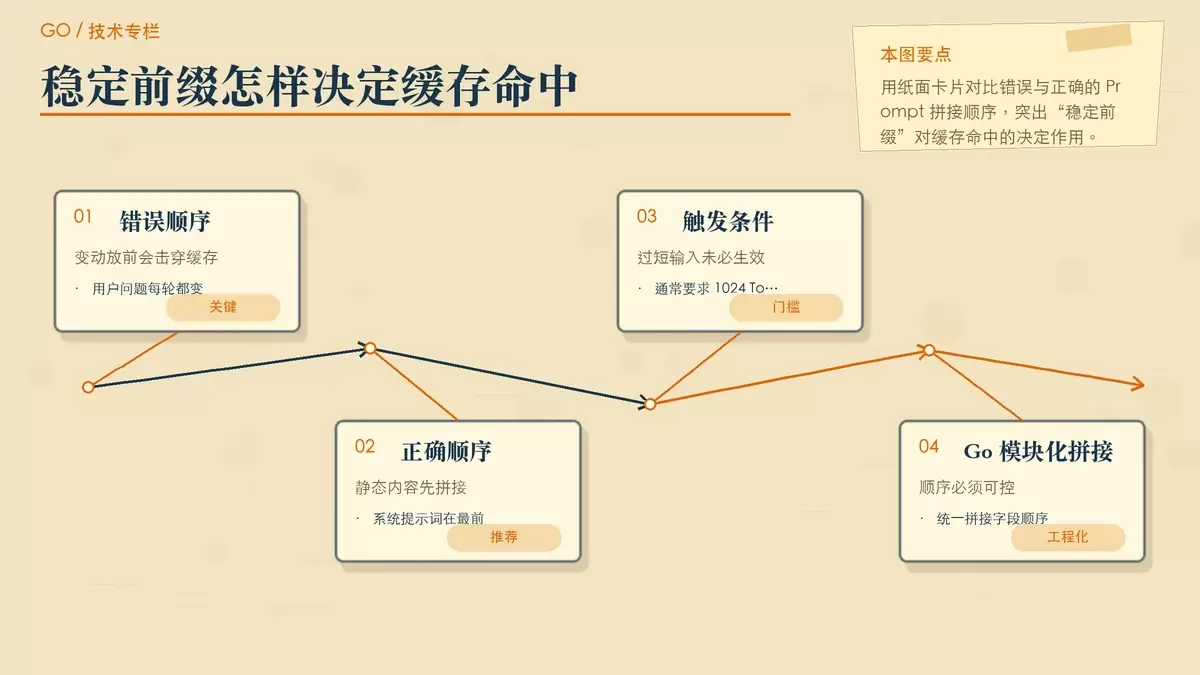
Prompt Caching 已经从“可选优化”变成 AI 后端的常规能力。对 Go 开发者来说,真正影响成本和延迟的,往往不是模型参数,而是 Prompt 顺序、动态字段位置、RAG 排序稳定性,以及是否把缓存逻辑封装进请求结构。
Embedding 模型一旦更换,旧向量就不再处于同一坐标系,直接迁移库文件并不能解决问题。本文结合 Go 实战,拆解向量数据平滑重构的关键做法:双写兜底、流式回填、并发限速、向量库写入优化,以及切换前的效果校验。
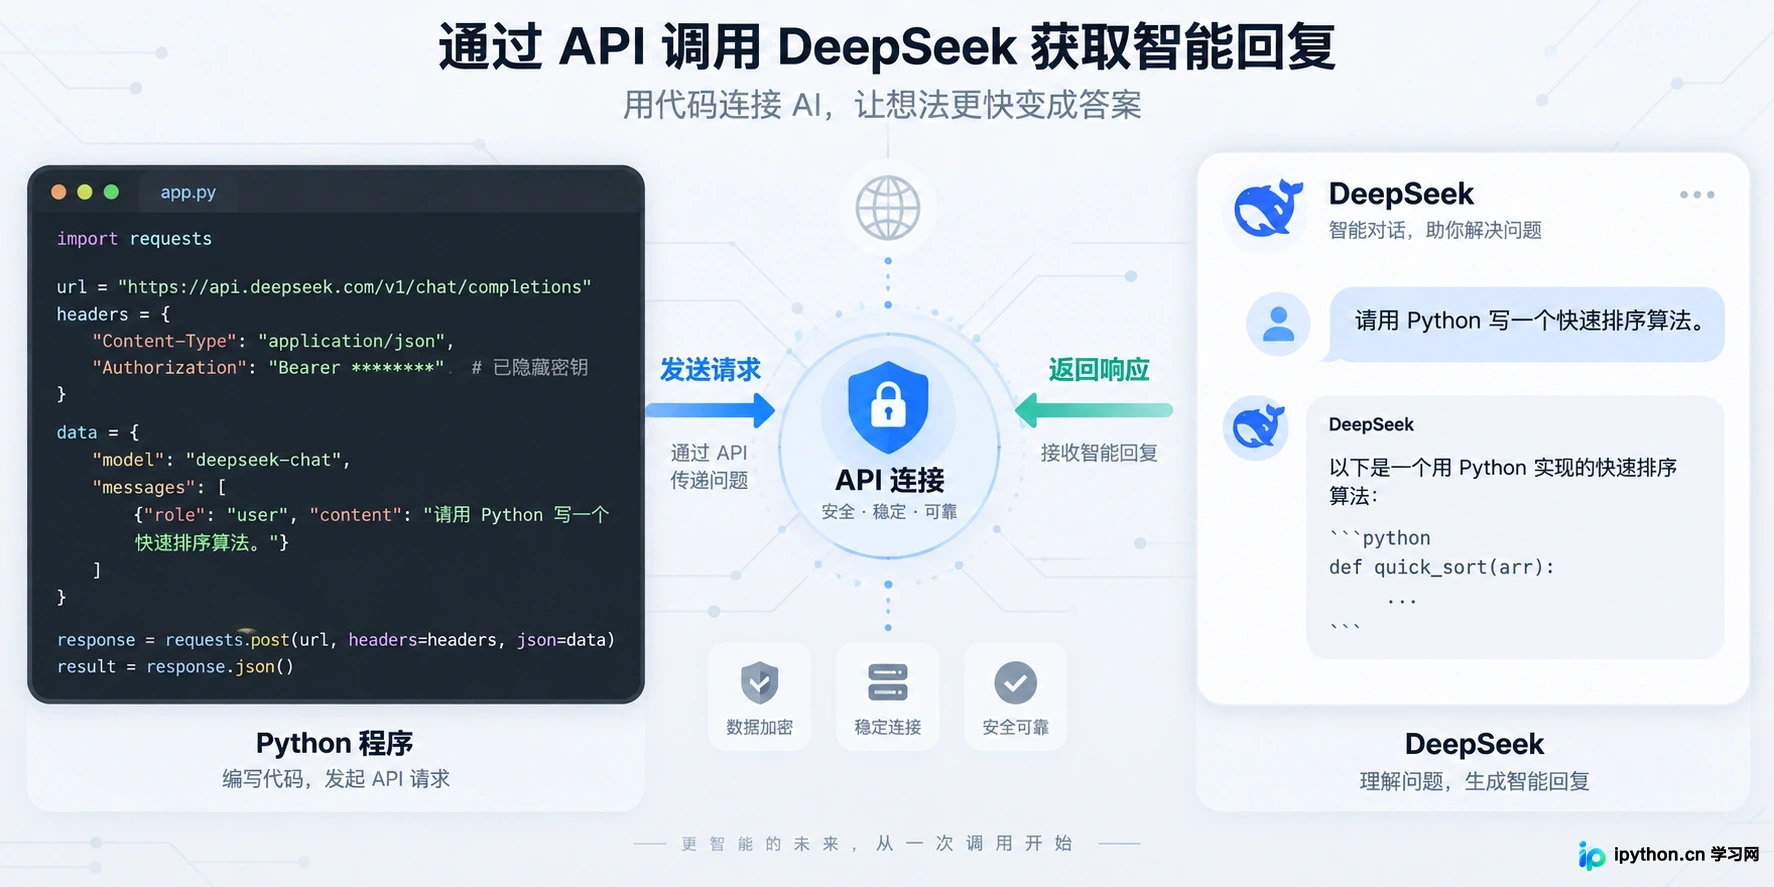
本文详解如何注册DeepSeek开发者账号、获取API Key,并提供基于Python的完整调用代码。涵盖计费模式说明及常见错误排查,帮助开发者快速将DeepSeek大模型能力集成到应用中。
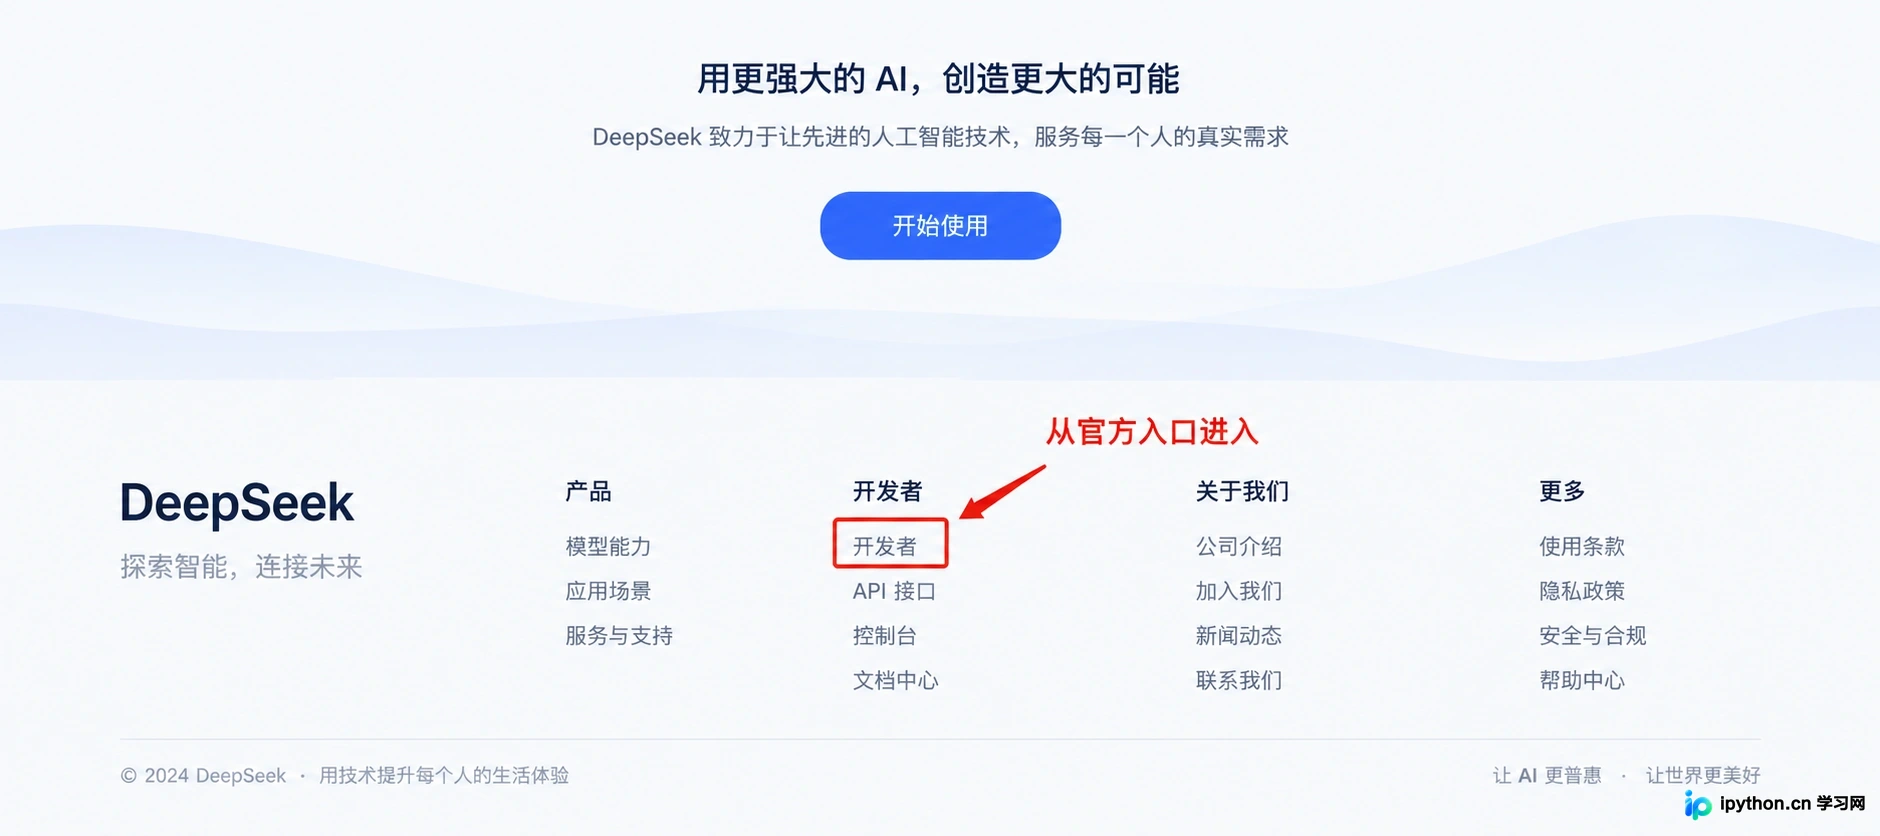
澄清DeepSeek无独立子域名,指引用户访问官网开发者中心。详解从账号注册、实名认证到获取API Key的完整流程,帮助开发者快速接入大模型能力。
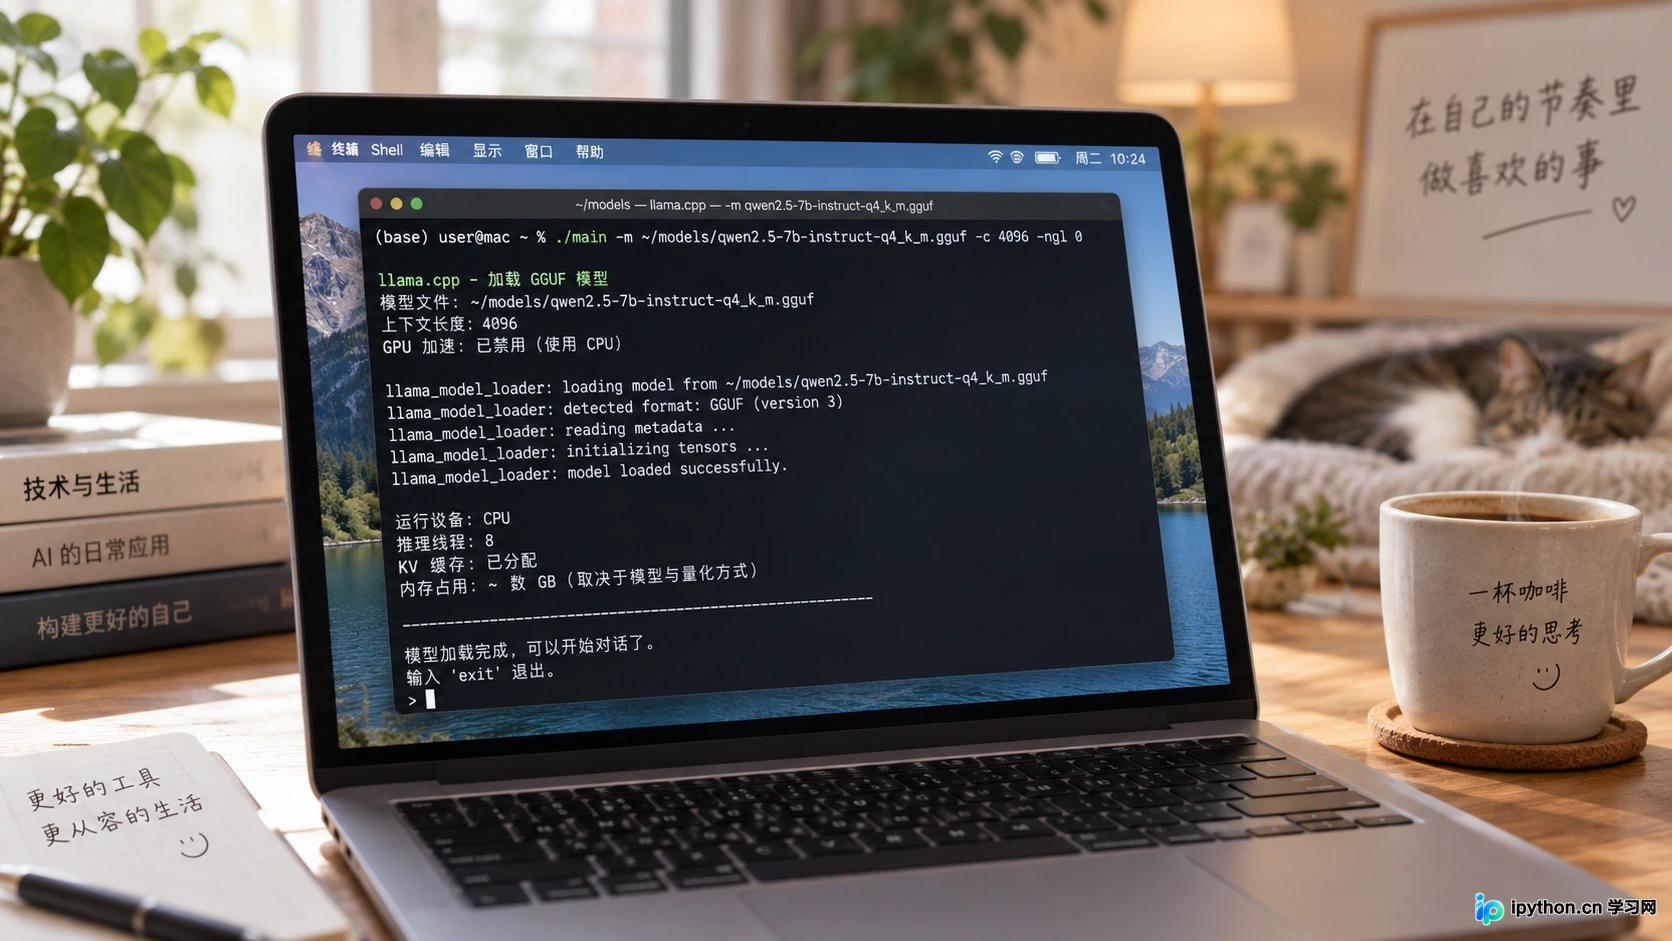
本文深入分析DeepSeek模型在本地部署时的量化选择策略,对比GGUF与AWQ两种主流格式在推理速度、显存占用及精度保持上的差异。通过具体场景解析,帮助用户根据硬件条件和使用需求做出最优决策,避免盲目追求低比特量化导致的体验下降。
本文详细介绍如何在Windows环境下使用Ollama本地部署DeepSeek大语言模型,并通过Python代码进行调用。内容涵盖Ollama及可视化工具Hollama的安装配置、模型下载运行命令,以及利用Python ollama库实现文本交互的完整代码示例,适合AI初学者及开发者参考。
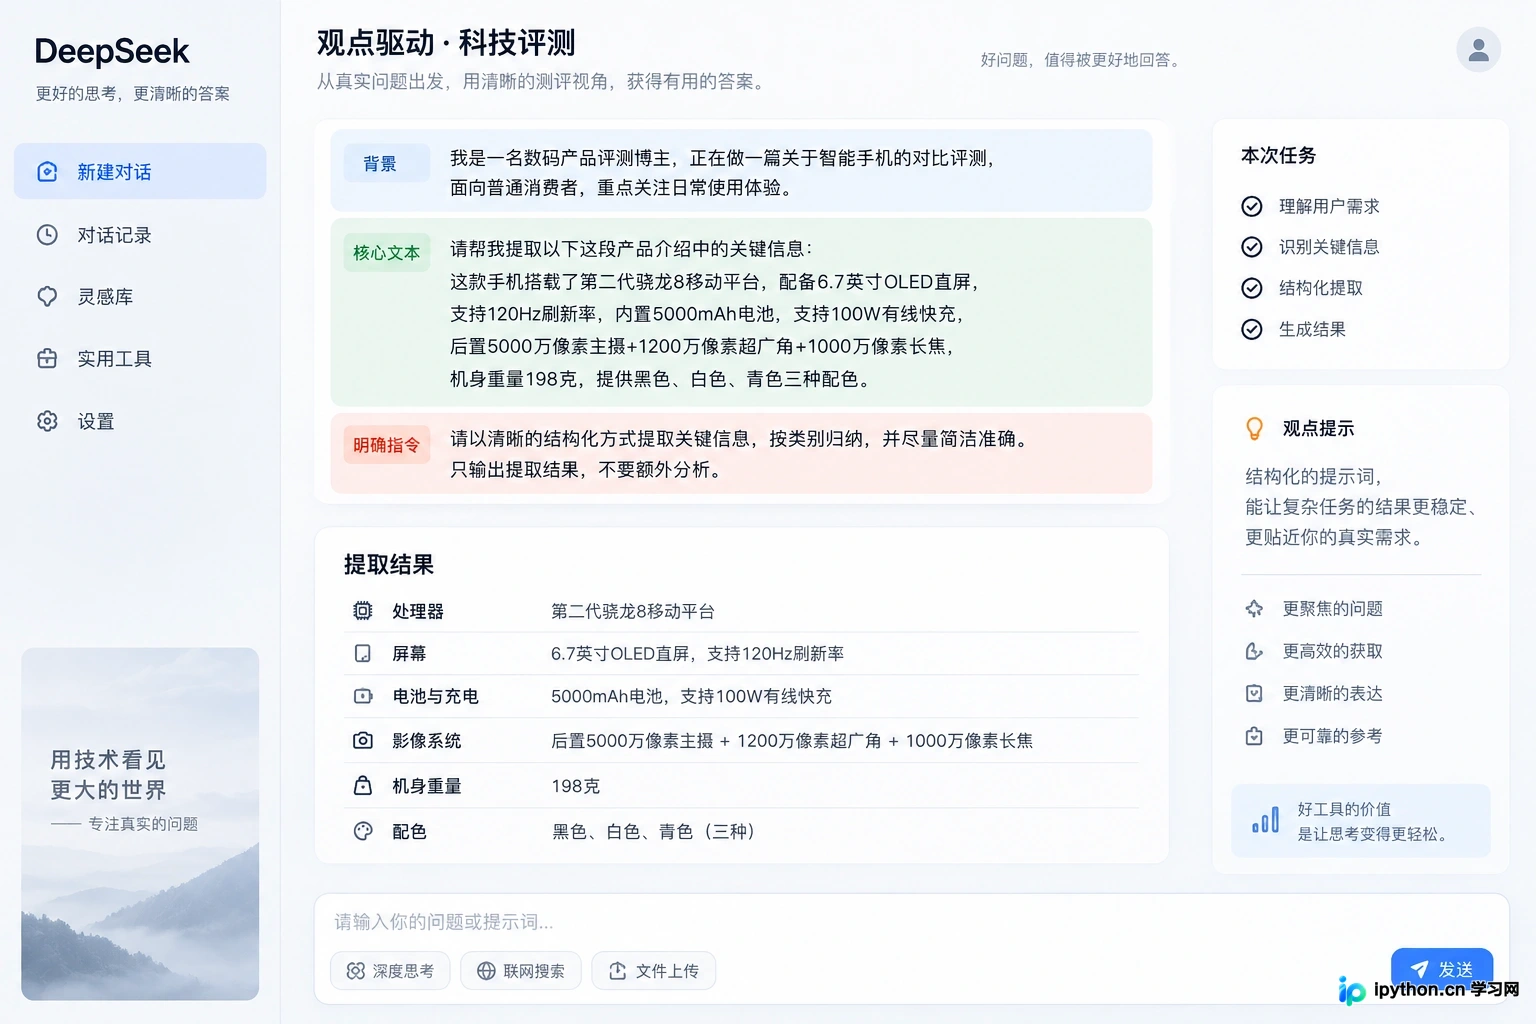
本文深入探讨DeepSeek网页版在处理超长技术文档与复杂代码调试中的高级应用。通过“分块投喂+结构重组”解决上下文溢出问题,利用“思维链引导”提升代码纠错准确率,并结合多轮对话策略优化开发工作流。旨在帮助开发者突破免费工具的局限,将其转化为高效的编程辅助伙伴。
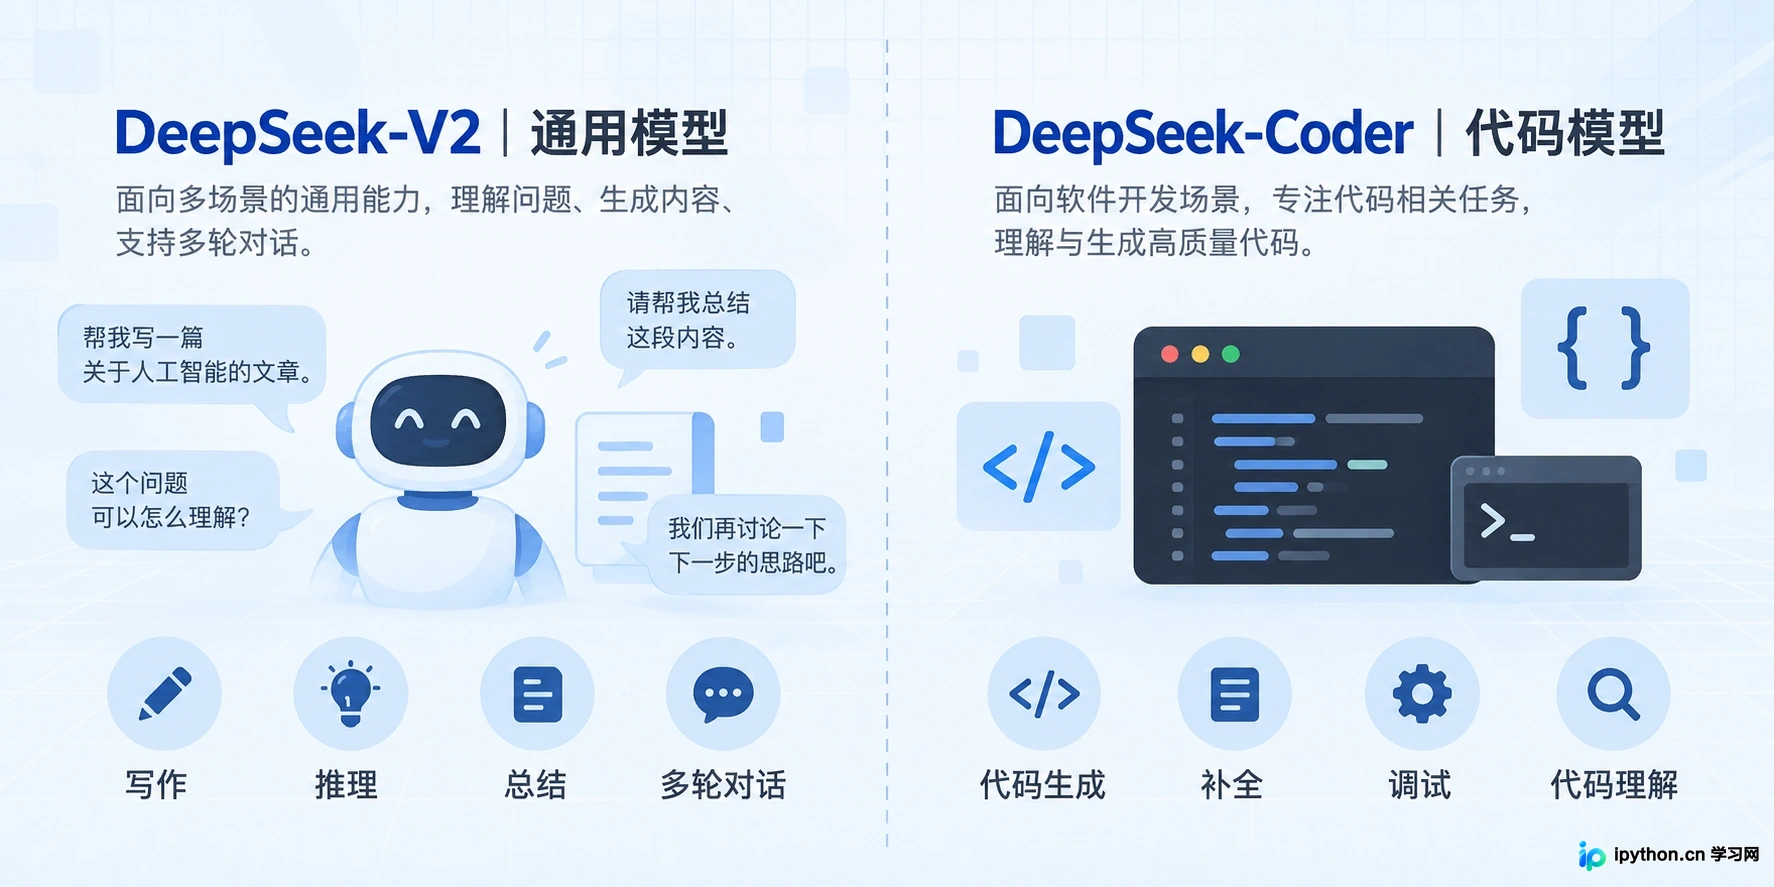
本文对比DeepSeek-V2通用大模型与DeepSeek-Coder代码专用模型的核心差异,从技术架构、擅长场景及成本效率三个维度解析,帮助开发者根据实际需求做出精准选型。
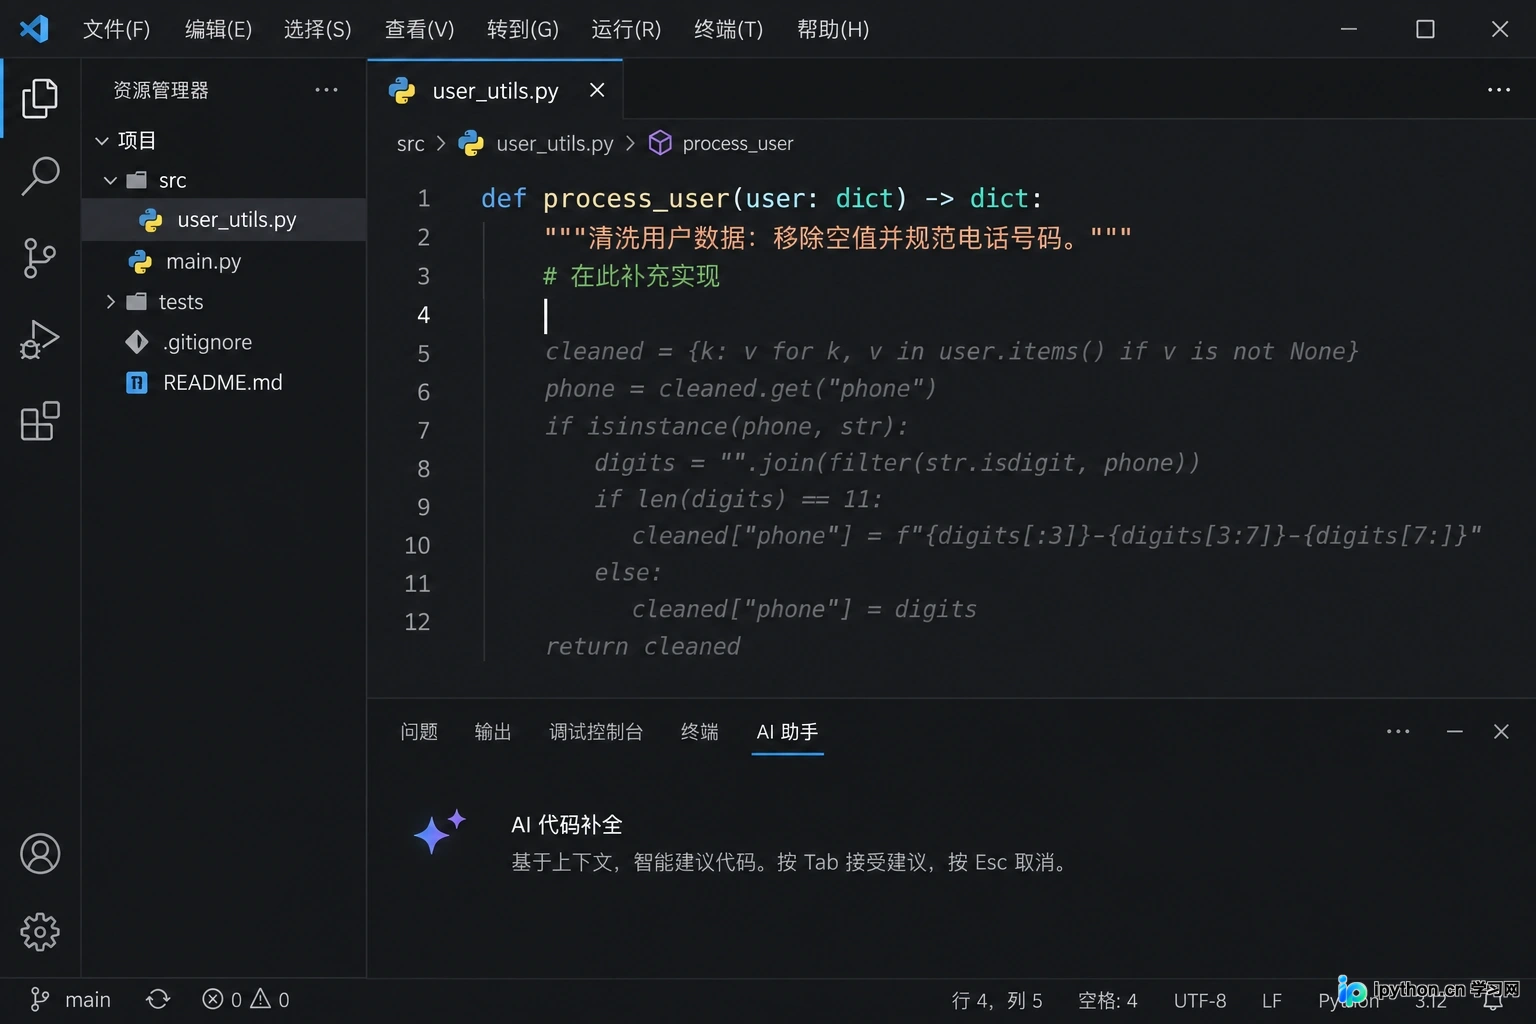
本文通过代码补全、错误诊断和单元测试生成三个实战场景,展示如何利用DeepSeek-Coder提升编程效率。文章以轻松实用的风格,指导开发者如何精准提问、解读模型反馈并快速落地修复方案,避免常见的使用误区。
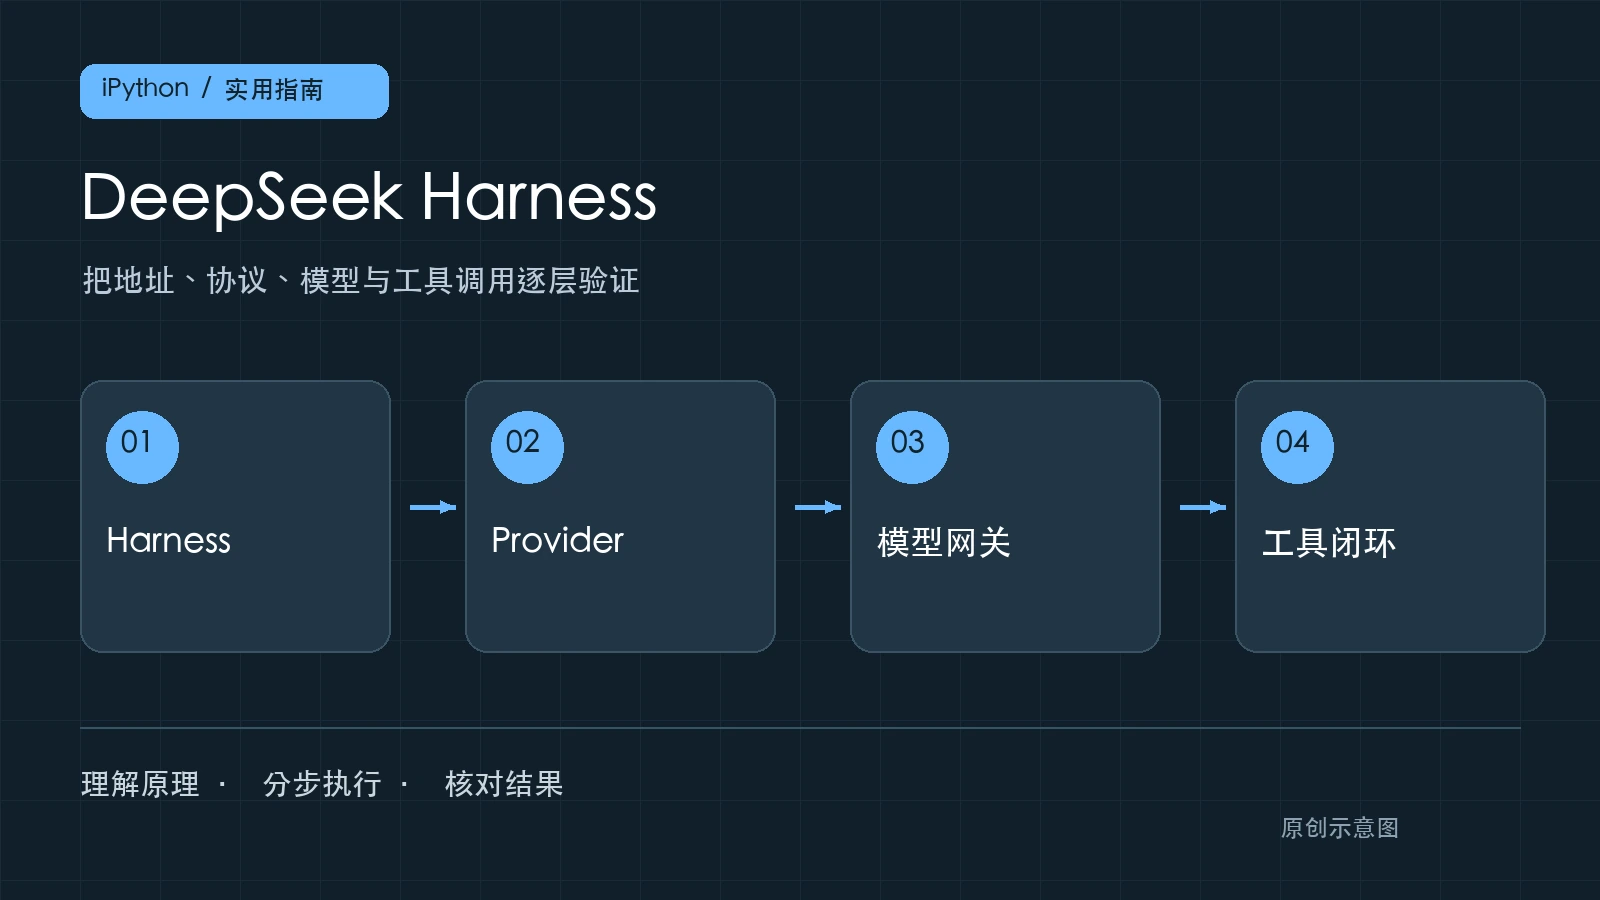
DeepSeek Harness 连上网关后可以聊天,却不能稳定执行工具,是接入时值得重点区分的两种状态。文字回复只证明请求到达了模型;一个编程任务还需要流式输出、工具参数、执行结果回传和后续推理共同配合。