Go 语言计算向量相似度的三种常见方案
在 Go 里计算向量相似度,常见路径并不止一种。小规模数据可以直接手写余弦、点积和欧氏距离;需要批量计算和更高性能时,适合交给 gonum 这类数值库;当规模进入十万到百万级,并且要做 ANN 检索时,更实际的做法是接入向量数据库。
08-25
164




在 Go 里计算向量相似度,常见路径并不止一种。小规模数据可以直接手写余弦、点积和欧氏距离;需要批量计算和更高性能时,适合交给 gonum 这类数值库;当规模进入十万到百万级,并且要做 ANN 检索时,更实际的做法是接入向量数据库。
多 Agent 能把复杂任务拆给不同角色,但一旦缺少约束,Research、Writer、Reviewer 这类智能体很容易陷入反复确认、互相打回的空转。本文从死循环的成因出发,拆解观察者模式、有限状态机和资源熔断三类治理手段,帮助开发者判断该在哪一层拦截问题。
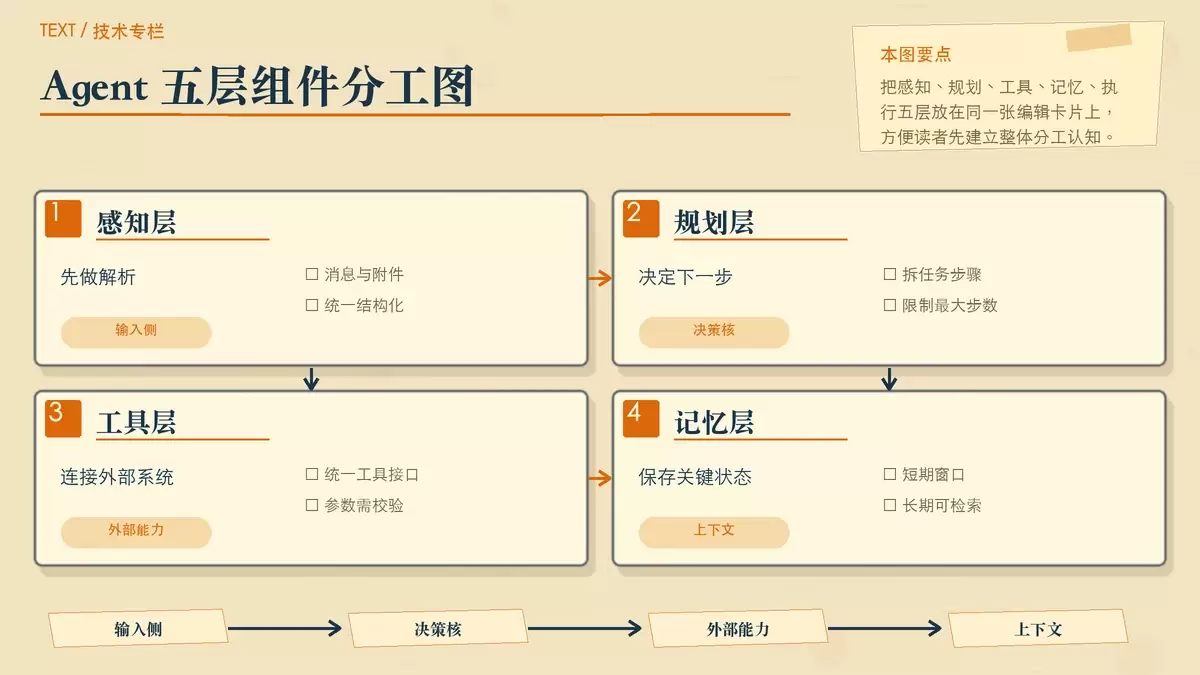
Agent 并不是一个抽象口号,落到工程实现,核心通常就五层:感知、规划、工具、记忆、执行。本文结合 Go 代码,把这套最小可用架构拆开讲清楚,并补上组件协作方式、落地时的关键约束,以及 Go 生态里的实际选择。
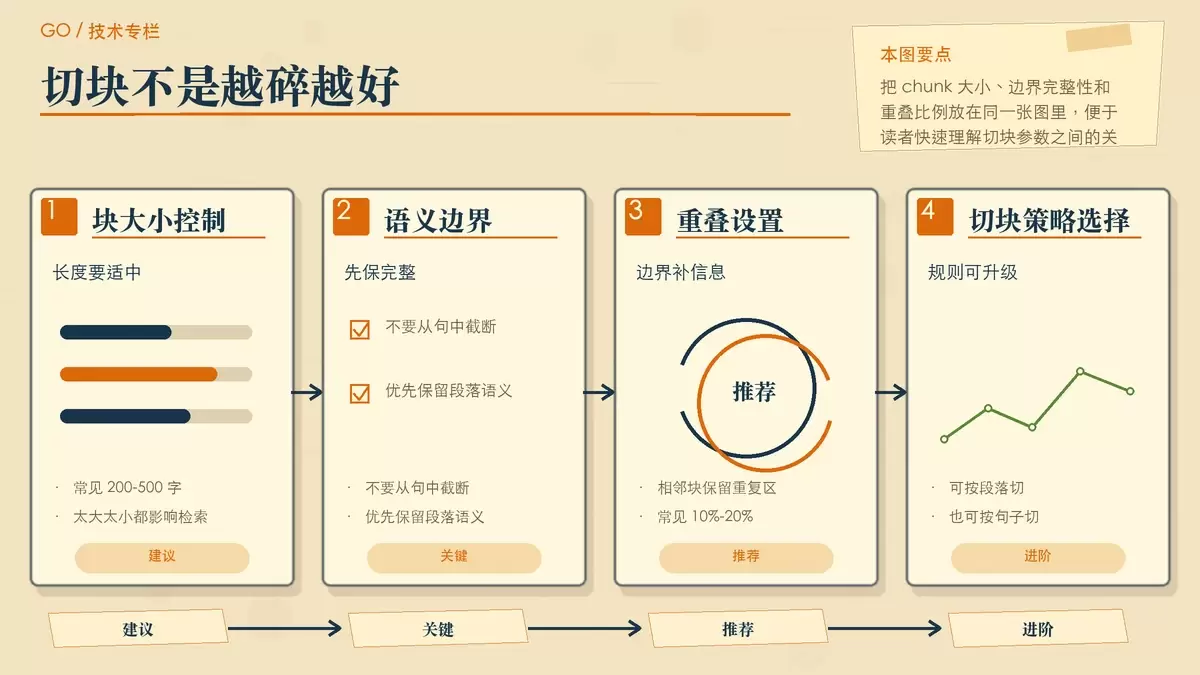
这篇文章用 Go 把 RAG 的核心链路拆成三步:文档切块、Embedding 向量化和相似度检索。你可以直接看懂最小实现,也能据此判断 chunk 大小、重叠比例、Top-K、向量库选型这些参数该怎么取。 想让大模型真正读懂企业知识库,关键不在于把文档一股脑塞进提示词,而在于先把内容拆成可检索的片段,再按问题取回最相关的上。
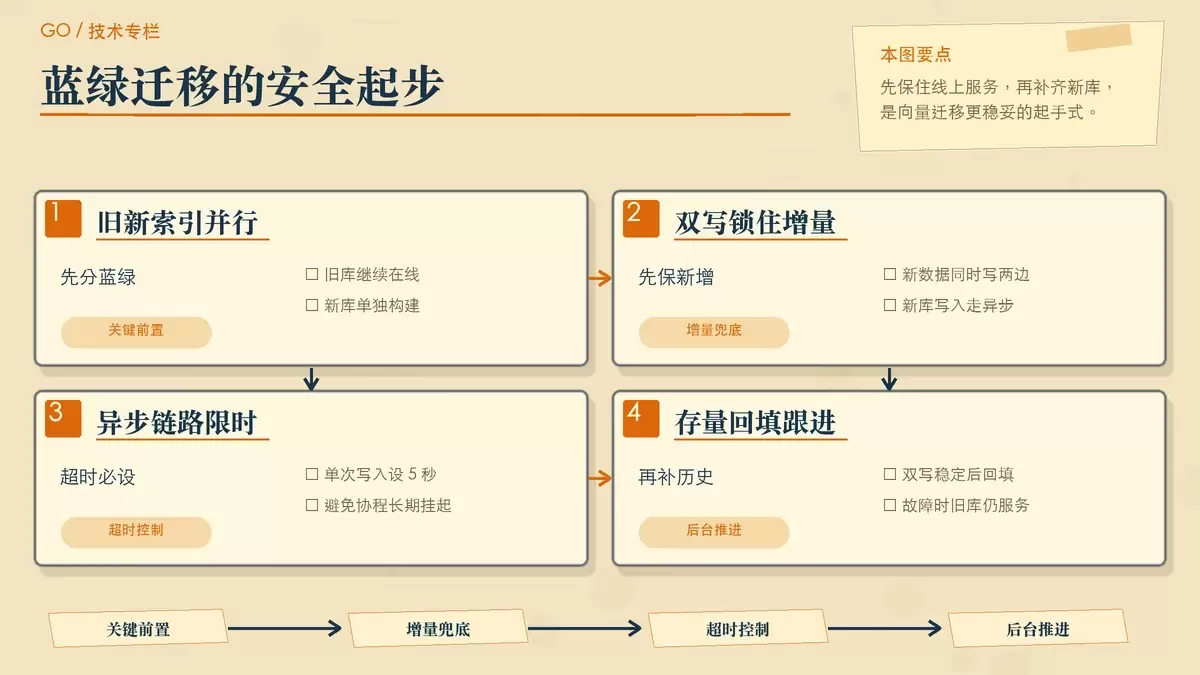
Embedding 模型一旦更换,旧向量就不再处于同一坐标系,直接迁移库文件并不能解决问题。本文结合 Go 实战,拆解向量数据平滑重构的关键做法:双写兜底、流式回填、并发限速、向量库写入优化,以及切换前的效果校验。
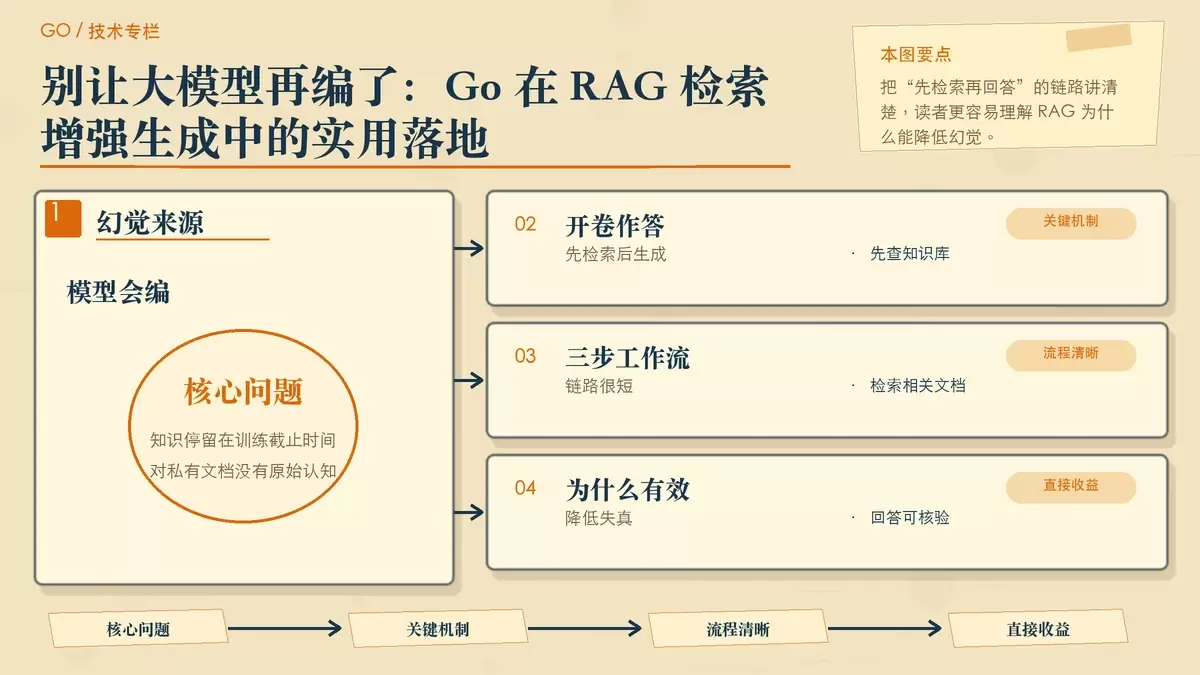
RAG 的价值不在于让大模型“更聪明”,而在于先把可验证的资料找出来,再让模型基于上下文作答。本文从幻觉问题出发,解释 Naive RAG 的常见短板、生产级优化思路,以及如何用 Go 配合 LangChainGo 快速搭出一条可运行的检索问答链。
本文介绍在TensorFlow中实现部分模型参数梯度更新的两种方法。第一种通过变量作用域筛选需优化的变量,第二种利用tf.stop_gradient()函数冻结特定层。结合矩阵部分行或列更新的示例,详细解析如何在迁移学习和Embedding场景中保持预训练参数不变并微调特定层。
本文详解如何利用Python Gensim库中的Word2Vec模型处理中文语料。内容涵盖语料收集、中文分词工具选择(如结巴、LTP)、模型训练参数设置及相似度计算。通过亚马逊书评数据示例,展示如何计算词语关联度、查找相关词及识别异常词,并提供完整的代码实现与结果分析。
本文详解如何将Keras训练的模型转换为TensorFlow二进制格式(.pb),并解决直接转换导致的TensorFlow Serving加载失败问题。通过冻结会话生成常量图,再进一步转换为SavedModel格式,确保模型可在服务端正常推理部署。



