


Python Gensim Word2Vec 中文语料处理实战:从分词到模型训练

本文详解如何利用Python Gensim库中的Word2Vec模型处理中文语料。内容涵盖语料收集、中文分词工具选择(如结巴、LTP)、模型训练参数设置及相似度计算。通过亚马逊书评数据示例,展示如何计算词语关联度、查找相关词及识别异常词,并提供完整的代码实现与结果分析。
Word2Vec概述与原理
Word2Vec概述
Word2Vec官方资源地址:https://code.google.com/p/word2vec/
- Word2Vec是Google推出的开源工具,旨在根据输入的词汇集合计算词与词之间的距离。
- 该工具将文本术语转换为向量形式,从而将复杂的文本处理简化为向量空间中的向量运算。通过计算向量空间中的相似度,可以表示文本在语义上的相似程度。
- Word2Vec计算的是余弦相似度,其值范围在0到1之间。数值越大,表明两个词之间的关联度越高。
- 词向量(Word Embedding):采用分布式表示法(Distributed Representation)来表示词语,通常也被称为“Word Representation”或“Word Embedding”。
简而言之,词向量表示法使得语义相关或相似的词语在向量空间中的距离更近。
中文语料处理流程
具体应用:处理中文语料
第一步:收集语料
本文使用的语料为亚马逊中文书评,包含超过12万句文本。语料以纯文本形式存储于txt文件中。需要注意的是,语料规模越大,训练效果通常越好。理论上语料越大越好,这一原则需反复强调,因为过小的语料训练出的结果往往缺乏实际意义。
第二步:中文分词
中文分词工具选择多样,常用的包括: - 中科院NLPIR - 哈工大LTP - 结巴分词
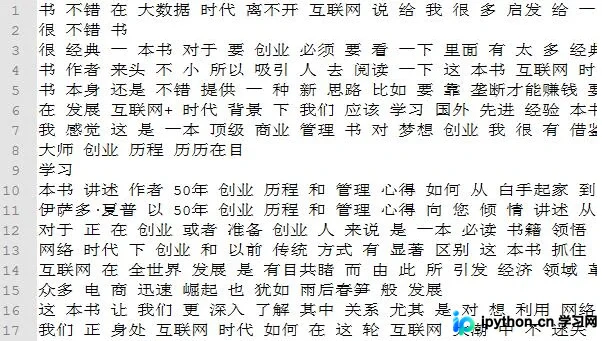
注意:经过分词处理后的文本将作为Word2Vec模型的输入文件。
分词后的文本示例
Python Gensim实现与代码解析
Word2Vec的具体使用
使用Python语言,并调用Gensim模块。
在Windows 7系统下,常规Python环境安装Gensim模块可能存在困难,因此建议使用Anaconda发行版。具体安装方法可参考:Python开发之Anaconda【以及Win7下安装Gensim】。
直接上代码——
#!/usr/bin/env python
# -*- coding: utf-8 -*-

"""
功能:测试gensim使用,处理中文语料
时间:2016年5月21日 20:49:07
"""

from gensim.models import word2vec
import logging

# 主程序
logging.basicConfig(format='%(asctime)s : %(levelname)s : %(message)s', level=logging.INFO)
sentences = word2vec.Text8Corpus(u"C:\\Users\\lenovo\\Desktop\\word2vec实验\\亚马逊中文书评语料.txt") # 加载语料
model = word2vec.Word2Vec(sentences, size=200) # 默认window=5

# 计算两个词的相似度/相关程度
y1 = model.similarity(u"不错", u"好")
print u"【不错】和【好】的相似度为:", y1
print "--------\n"

# 计算某个词的相关词列表
y2 = model.most_similar(u"书", topn=20) # 20个最相关的
print u"和【书】最相关的词有:\n"
for item in y2:
  print item[0], item[1]
print "--------\n"

# 寻找对应关系
print u"书-不错,质量-"
y3 = model.most_similar([u'质量', u'不错'], [u'书'], topn=3)
for item in y3:
  print item[0], item[1]
print "--------\n"

# 寻找不合群的词
y4 = model.doesnt_match(u"书 书籍 教材 很".split())
print u"不合群的词:", y4
print "--------\n"

# 保存模型,以便重用
model.save(u"书评.model")
# 对应的加载方式
# model_2 = word2vec.Word2Vec.load("text8.model")

# 以一种C语言可以解析的形式存储词向量
model.save_word2vec_format(u"书评.model.bin", binary=True)
# 对应的加载方式
# model_3 = word2vec.Word2Vec.load_word2vec_format("text8.model.bin", binary=True)

if __name__ == "__main__":
  pass
模型训练结果与分析
运行结果展示
词语【不错】和【好】的相似度为:0.790186663972 --------
与词语【书】最相关的词汇列表如下:
书籍 0.675163209438 书本 0.633386790752 确实 0.568059504032 教材 0.551493048668 正品 0.532882153988 没得说 0.529319941998 好 0.522468209267 据说 0.51004421711 图书 0.508755385876 挺 0.497194319963 新书 0.494331330061 很 0.490583062172 不错 0.476392805576 正版 0.460161447525 纸张 0.454929769039 可惜 0.450752496719 工具书 0.449723362923 的确 0.448629021645 商品 0.444284260273 纸质 0.443040698767 --------
类比推理示例:书-不错,质量- 精美 0.507958948612 总的来说 0.496103972197 材质 0.493623793125 --------
异常词检测:词语【很】被识别为不合群的词。
以上即为本文的全部内容,希望对读者的学习有所帮助,也欢迎大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















