Python编码规范:彻底解决Python编码噩梦
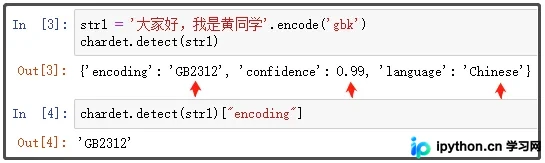
本文详细解析Python中的编码问题,对比Python 3中str与bytes的区别,以及Python 2中unicode与str的差异。介绍如何使用chardet库检测编码格式,并演示编码与解码的具体操作。最后提供在Python 2和3中设置文件编码的两种实用方法,帮助开发者摆脱编码困扰。
10-15
25




本文详细解析Python中的编码问题,对比Python 3中str与bytes的区别,以及Python 2中unicode与str的差异。介绍如何使用chardet库检测编码格式,并演示编码与解码的具体操作。最后提供在Python 2和3中设置文件编码的两种实用方法,帮助开发者摆脱编码困扰。
本文介绍Python中处理文件编码与类型识别的两个核心模块。针对ConfigParser读取非UTF-8配置文件时的UnicodeDecodeError,演示如何使用chardet模块自动检测文件编码并正确读取。同时讲解mimetypes模块通过文件名或URL获取MIME类型及对应文件扩展名的方法,涵盖guess_type与guess_all_extensions函数的具体用法与参数说明。
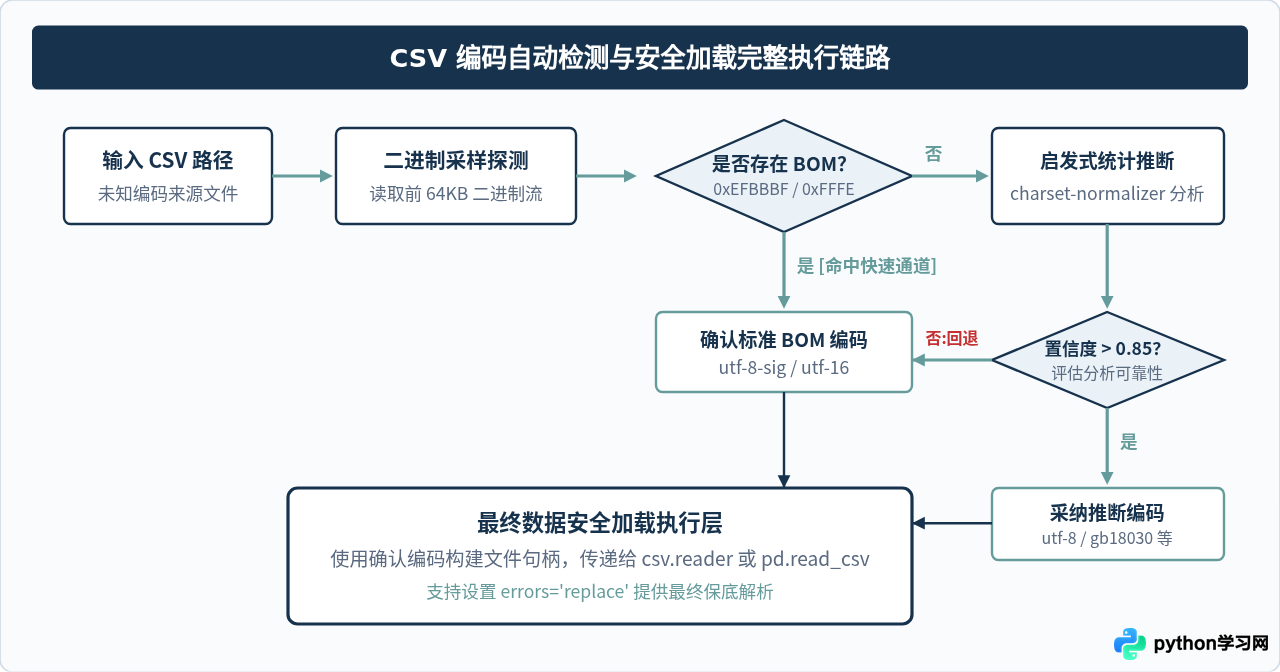
本文介绍在Python中自动检测CSV文件编码并安全读取的完整代码实现方案,包括BOM判断、样本特征探测、标准库回退机制与Pandas集成实践。
本文介绍如何在Python环境中使用chardet库判断文件编码。需将chardet文件夹拷贝至Lib\site-packages目录。通过读取文件二进制内容调用detect方法获取编码,再按该编码重新打开文件读取内容。实测支持32位Win7及Python3.2环境。
本文介绍使用 Python 3.5 检测路由器流量并保存至 txt 文件的简单方法。重点解决网页编码识别(如 ISO-8859-1)及 bytes 转 str 的问题,演示利用 chardet 库、split 截取字符串及 open 函数处理换行符的技巧,适合初学者参考。
本文详解Python网络爬虫中常见的乱码问题,涵盖中文、日文等多语言编码处理。通过解析HTTP Header、Meta标签及Document定义确定源编码,并介绍使用chardet库自动检测编码的方法。结合Python 2.7实例,演示如何正确进行字符串解码与编码转换,确保数据准确存储。
本文详解Python2中获取包含中文文件名时出现乱码的原因及解决方法。通过引入chardet模块检测文件编码(如GB2312与UTF-8),并封装兼容Windows与Linux系统的解码函数,实现中文文件名的正确读取与显示。
本文详细介绍Python中chardet库的安装方法及核心用法。针对爬虫中常见的网页编码不一致导致的乱码问题,讲解如何利用chardet.detect()函数自动检测字符串或网页源码的编码格式(如GBK、UTF-8等)。通过百度网页抓取实例,演示如何结合requests库动态设置编码,从而高效解决乱码难题,提升数据抓取成功率。