Python3 Requests库处理HTTP重定向获取真实URL的两种方法
本文介绍在Python3中使用Requests库处理HTTP 301或302重定向时,如何获取跳转后的真实URL。通过解析Response Header中的Location字段,或利用Requests默认自动跳转特性访问response.url,可分别实现手动提取与自动获取两种方案。
10-16
8




本文介绍在Python3中使用Requests库处理HTTP 301或302重定向时,如何获取跳转后的真实URL。通过解析Response Header中的Location字段,或利用Requests默认自动跳转特性访问response.url,可分别实现手动提取与自动获取两种方案。

本文解析Python爬虫中因服务器使用Brotli压缩导致的中文乱码问题。详细说明了如何识别Accept-Encoding头中的br格式,通过手动导入brotli库或使用httpx自动处理来正确解码数据,并提供了修改请求头以禁用br压缩的替代方案。
本文深入讲解Python爬虫中requests库的高级应用。通过GET与POST请求实例,演示如何构造Headers与Params;结合拉钩网案例解析数据抓取逻辑;详细介绍代理IP配置方法以规避封禁;最后通过人人网登录示例,阐述利用Session对象保持会话状态及Cookie管理的完整流程。
本文详细介绍Python爬虫中requests库的安装方法及GET与POST请求的具体使用。涵盖通过pip或源码安装requests,演示如何构造带参数的GET请求、获取JSON数据、处理二进制文件下载,以及利用data和files参数进行POST请求和文件上传。同时解析响应状态码、异常抛出及JSON转换技巧,帮助开发者高效完成HTTP交互。
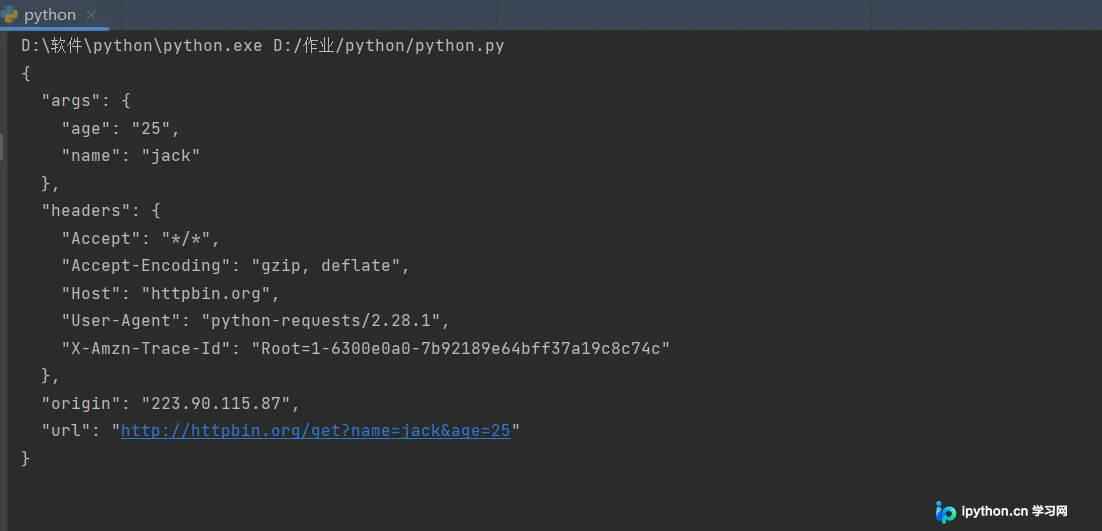
本文详细介绍如何使用Python爬取Pixiv图片。内容涵盖通过抓包分析模拟登录流程,动态获取post_key,利用Session保持状态,以及通过BeautifulSoup和正则表达式提取图片链接。针对Pixiv的防盗链机制,文章提供了处理Referer、动态构建真实图片URL及解决403/404错误的完整代码方案。
本文深入探讨Python中处理JSON字符串的最佳实践,明确指出使用eval()转换JSON存在安全风险且性能低下。通过百万级数据量的实测对比,json.loads的执行速度比eval快8倍以上。文章还介绍了利用requests库的json()方法简化代码,推荐开发者在项目中全面采用标准库方案以保障安全与效率。

本文详细介绍在PyCharm编辑器中安装第三方库的两种常用方法。第一种是通过内置Terminal终端使用pip命令进行安装,操作简便直接;第二种是通过Settings设置界面图形化安装。以安装requests库为例,分别演示了命令行输入及界面点击的具体步骤,帮助用户快速完成Python依赖包的管理与配置。

本文详解Python爬虫中利用Requests库处理Cookie的两种核心方法。通过对比urllib,展示如何使用get方法直接传递Cookie,以及利用Session对象在多次请求间自动保持Cookie状态。包含具体代码示例及运行结果分析,帮助开发者更高效地实现登录态维持与数据抓取。
本文详解如何利用Python的browsercookie模块自动从Chrome、Firefox等主流浏览器中提取已保存的Cookie,解决爬虫登录验证难题。通过安装配置、代码示例及requests库结合使用,实现无需手动输入账号密码即可访问需登录状态的网页内容,提升数据采集效率。
本文详解Python爬虫中模拟登录人人网的两种核心方法。首先介绍使用requests.Session()类自动维持会话状态,通过POST提交表单数据实现登录并抓取个人主页;其次演示如何手动提取并传递Cookie,分别通过Headers和Cookies参数访问受限页面。代码包含完整登录流程与本地保存逻辑,适用于学习爬虫会话保持机制。
本文详细介绍利用Python爬虫下载网页中图片、文档等资源的三种方法。通过解析网页源码获取资源URL,分别演示了使用urllib.urlretrieve直接下载、requests库同步全量下载以及开启stream参数进行分块写入的实现代码。重点解析了分块下载在处理大文件时节省内存的优势,并提供了批量下载多个资源的通用逻辑思路。
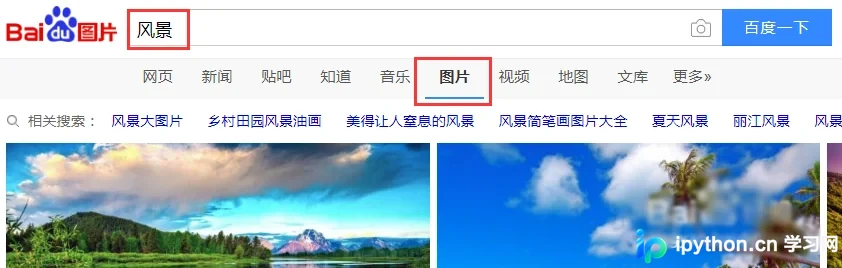
本文介绍如何利用Python的requests库判断计算机是否拥有网络连接。通过安装requests第三方库,编写简单函数尝试访问百度并设置超时时间,若成功则返回真,否则捕获异常返回假。该实例代码简洁,适合初学者参考学习网络状态检测的基本方法。



