Python lxml库Xpath语法实战指南
本文详解Python中lxml库的Xpath使用技巧,涵盖基础语法、节点定位、文本提取(text与string函数)及多路径选择。通过具体代码示例,帮助开发者掌握高效解析XML/HTML文档的核心方法。
10-16
11




本文详解Python中lxml库的Xpath使用技巧,涵盖基础语法、节点定位、文本提取(text与string函数)及多路径选择。通过具体代码示例,帮助开发者掌握高效解析XML/HTML文档的核心方法。
本文介绍在Python爬虫中获取非唯一指定内容的方法。当XPath无法直接定位目标时,可通过遍历节点并结合条件判断进行筛选。文章提供基于urllib和lxml的完整代码示例,展示如何构建请求、解析HTML并过滤关键词,同时指出原代码存在冗余问题,旨在为开发者提供清晰的筛选逻辑参考。
本文详解Python中IndexError: list index out of range错误的成因与解决方案。当XPath定位不到数据导致列表为空时,直接索引会触发此异常。通过引入try-except异常捕获机制,可将未定位到的元素赋值为None,从而避免程序崩溃,确保爬虫脚本稳定运行。
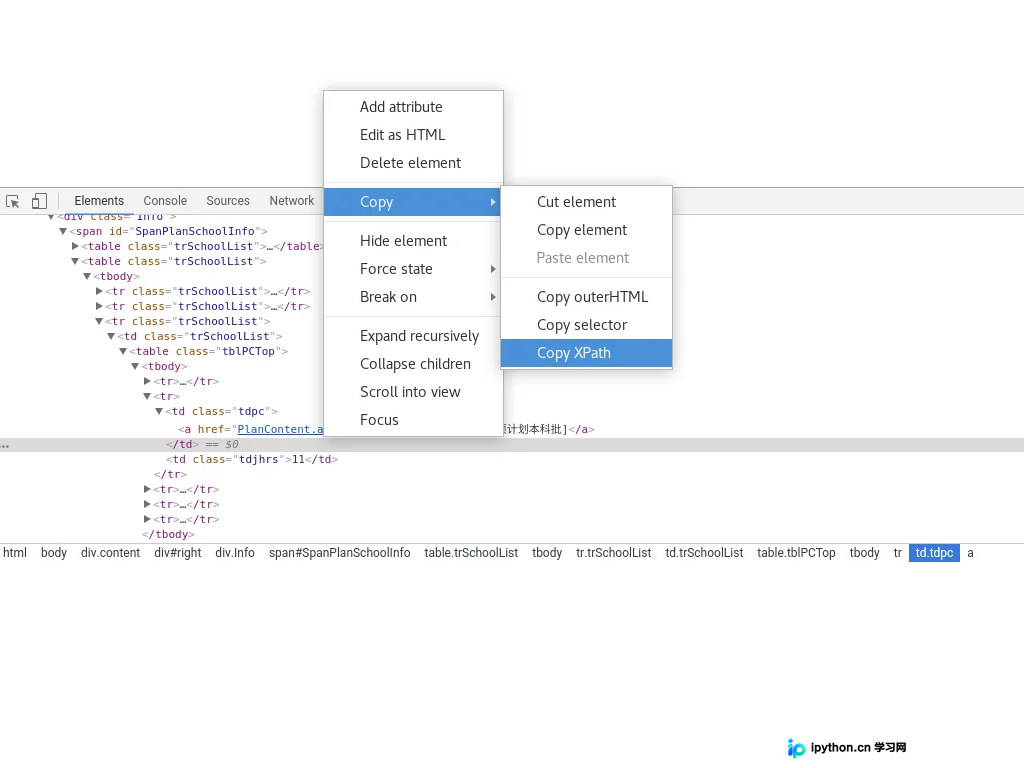
本文分析Scrapy中使用Chrome开发者工具生成的XPath在爬虫中失效的问题。根本原因在于浏览器自动插入tbody标签,而原始HTML结构中可能不存在该标签。通过对比Chrome生成的含tbody XPath与Scrapy实际解析结果,发现需手动移除xpath中的tbody节点。文章提供了使用scrapy shell逐步定位问题的方法,并给出修正后的正确XPath示例,帮助开发者避免此类常见坑点。
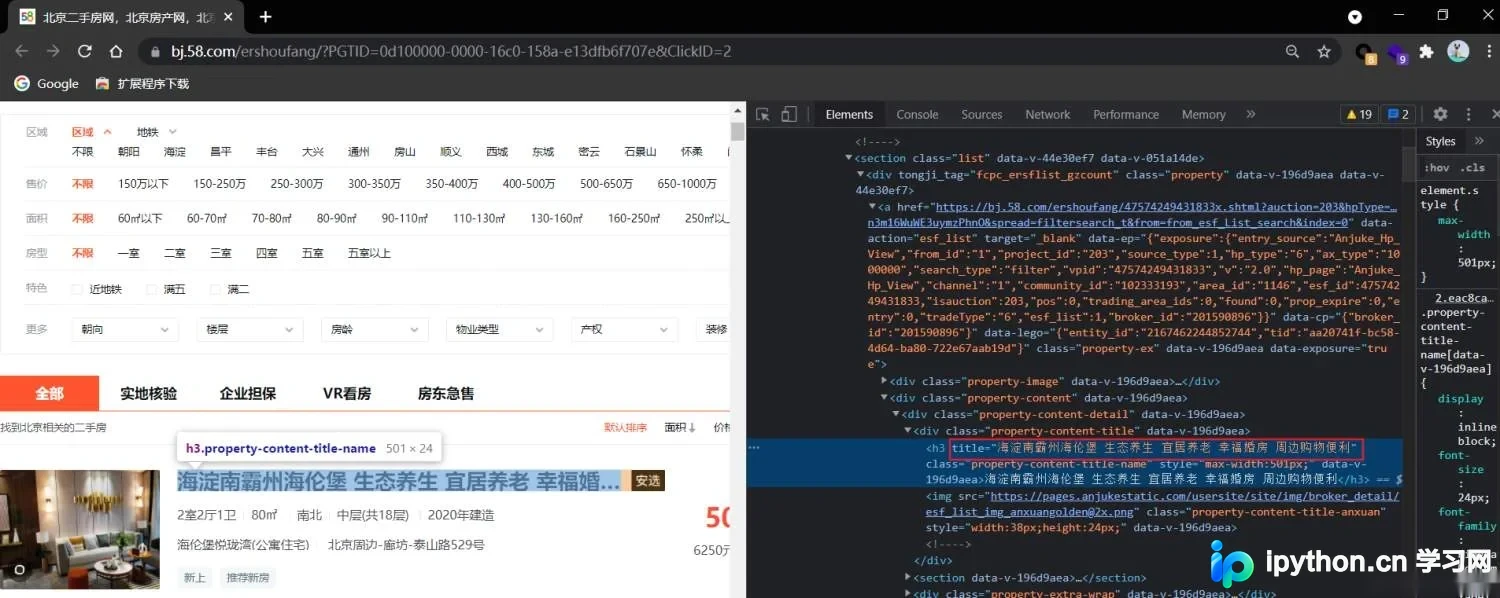
本文详细介绍Python中XPath数据解析的原理与应用。涵盖lxml库的安装、etree对象的实例化方法,以及通过XPath表达式定位标签和提取文本或属性值的技巧。结合58同城二手房案例,演示如何处理浏览器显示与源码结构的差异,提供完整的代码示例与注意事项。
本文详解Python中XPath解析定位的六种核心方法。内容涵盖绝对路径与相对路径的区别、基于索引的定位、节点属性精确匹配、部分属性值模糊匹配(如contains、starts-with),以及多条件组合定位技巧。通过具体代码示例,帮助开发者掌握高效精准的网页数据抓取定位策略。
本文通过两个Python爬虫实例详解XPath技术的应用。案例一演示如何从图片列表页提取内页链接,进而获取百度网盘地址与提取码,涉及函数传参、循环控制及异常跳过逻辑。案例二针对豆瓣读书评论,解析为何直接获取节点无效,并指出使用/text()提取文本内容的正确方法。文章涵盖requests与lxml库的基础用法及常见错误排查。
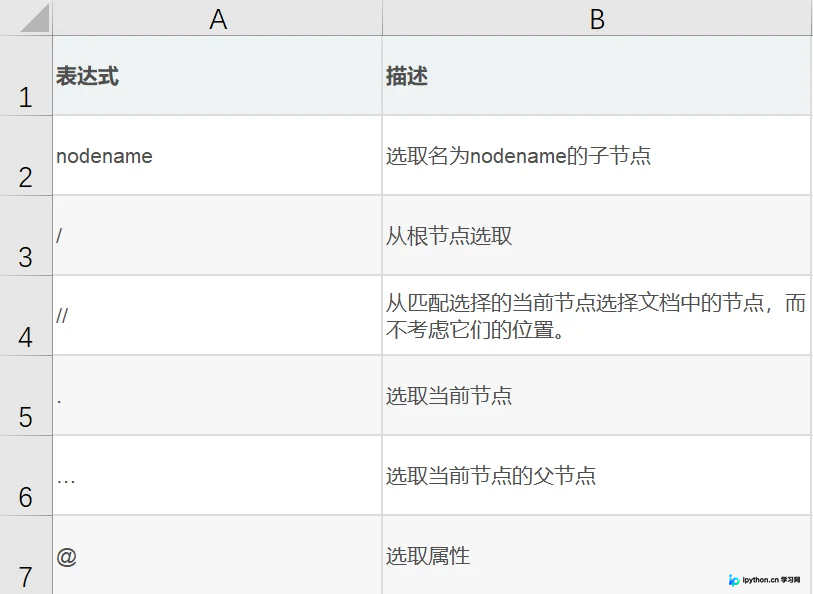
本文全面介绍XPath(XML路径语言)的核心概念,包括其作为XSLT和XPointer共享语法的用途。详细解析了XPath的四种返回类型、节点树模型及地址路径语法(如/、//、@的使用)。同时系统梳理了核心函数库,涵盖节点集合、字符串处理、布尔逻辑及数字运算函数,为XML数据提取和Web自动化测试提供基础参考。
本文深入解析XSLT中的选择模式,通过xsl:for-each循环选取节点、xsl:value-of获取节点值以及xsl:apply-templates应用模板三种核心语句,展示如何从XML文档中提取和格式化数据。同时涵盖排序操作(如按字母、大小写及数据类型)的语法细节,帮助开发者高效实现XML数据的结构化输出。
本文详解XSL(扩展样式语言)在XML数据处理中的核心作用,涵盖XSLT数据转换、XPath导航语法及格式化对象应用。通过对比HTML与XML结构差异,解析XML根节点规范及编码注意事项,并梳理XSL选择、匹配与测试三大模式的关键标签,帮助开发者掌握将结构化XML转化为前端展示页面的技术路径。
本文详解在PHP中通过DOMDocument加载XML文件,并利用DOMXPath对象执行XPath表达式查询特定节点的方法。包含构建查询对象、使用query()方法获取DOMNodeList及读取节点值的完整代码实现,适用于快速定位并提取XML数据。
本文介绍 C# 中使用 XmlDocument 类加载、查询和创建 XML 文档的方法。涵盖从文件、流或字符串加载 XML,利用 XPath 进行节点筛选与属性读取,以及构建包含属性和文本的复杂 XML 结构。需注意该方式将 XML 全部载入内存,适合中小规模数据。



