Python高并发解决方案实现过程详解
本文详解Python高并发场景下的综合解决方案。从CDN静态资源加速、CSS精灵图优化,到MySQL与Redis混合存储架构,深入探讨SQL与索引优化、分库分表及读写分离策略。结合Django+Uwsgi+Nginx集群部署与Celery分布式异步处理,以及Go语言混合编程,提供完整的性能提升路径。



本文详解Python高并发场景下的综合解决方案。从CDN静态资源加速、CSS精灵图优化,到MySQL与Redis混合存储架构,深入探讨SQL与索引优化、分库分表及读写分离策略。结合Django+Uwsgi+Nginx集群部署与Celery分布式异步处理,以及Go语言混合编程,提供完整的性能提升路径。
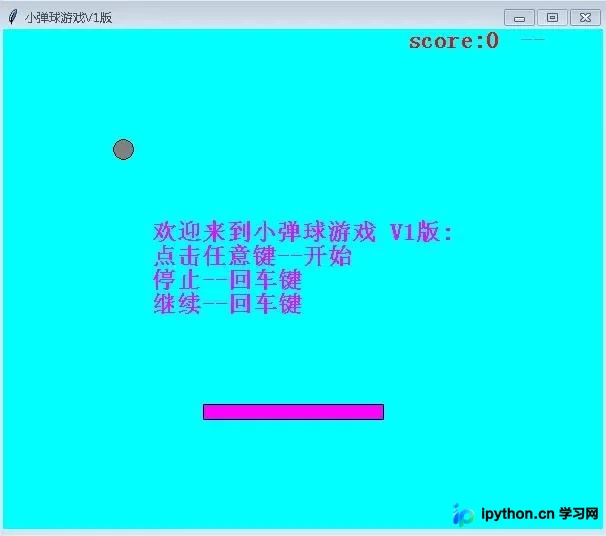
本文通过Python标准库Tkinter实现一款经典的弹球小游戏,帮助开发者重温儿时乐趣并掌握GUI编程基础。项目无需额外依赖,仅凭键盘即可控制挡板移动。文章详细展示了游戏运行界面、核心逻辑及完整源码,适合Python初学者进行实战练习,快速理解事件驱动与图形界面交互原理。
本文深入解析Python中Django框架的核心机制,涵盖其“包含一切”的设计理念、MTV架构模式及完整请求处理流程。详细列举ORM、URL分发、缓存等核心组件,并客观分析其开发效率高、文档完善等优势,以及系统耦合度高、模板功能受限等缺点,帮助开发者全面评估Django在复杂网站开发中的适用性。
本文详解在 Python SQLAlchemy 中如何实现 create_time 和 update_time 的自动维护,以及通过 werkzeug.security 进行密码哈希存储与校验。内容涵盖 datetime 与时间戳的相互转换方法,并提供了完整的 User 模型代码示例,确保密码字段只写且不可读,提升应用安全性。
本文介绍如何在 Python 中使用 lambda 表达式定义简短的匿名函数,以替代 def 语句。通过对比普通函数定义,展示其在排序和数据处理中的典型应用。同时强调 lambda 仅支持单个表达式,无法包含多条语句、循环或异常处理,适用于需要简短回调的场景。
本文介绍如何利用 Python 的 yield from 语句构建递归生成器,将多层嵌套的序列(如列表)展开为单层。通过自定义 ignore_types 参数排除字符串和字节,避免字符被错误拆分,实现简洁高效的扁平化处理。
本文介绍在Python接口测试中获取手机短信验证码的方法。通过Android端注册BroadcastReceiver监听SMS_RECEIVED广播,解析短信内容,并利用Python脚本调用adb logcat命令实时抓取日志,提取验证码字符串。该方法适用于自动化测试场景,无需手动输入验证码,提升了测试效率与准确性。
本文介绍如何在Python中通过重新定义__str__()和__repr__()方法来改变实例的字符串显示。__repr__()用于生成代码可重建对象的表示,通常由repr()调用;__str__()用于生成用户友好的可读字符串,由print()和str()调用。合理实现这两个方法能显著提升调试效率和日志可读性。
本文介绍使用Python获取网页源码的两种方法。首先演示利用requests库直接获取指定页面的HTML文本,并处理编码问题;其次展示结合urllib2与BeautifulSoup进行全站链接扫描的复杂示例,包括遍历页面、解析锚点、检查链接状态码及计算耗时。
本文介绍在Flask开发中解决静态资源(CSS/JS)修改后浏览器缓存不生效的方法。通过重写url_for方法,在静态资源URL后附加文件最后修改时间戳作为版本号参数。当文件更新时,时间戳变化促使浏览器请求最新资源,无需重启服务器即可生效。
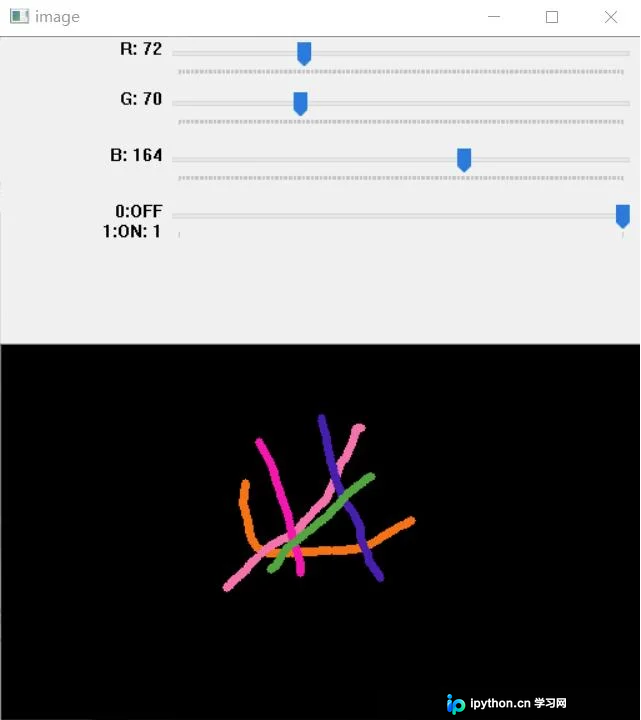
本文介绍如何使用OpenCV和Python构建一个简易画板程序。通过cv.createTrackbar实现RGB颜色调节,利用cv.setMouseCallback处理鼠标点击与移动事件,结合主循环完成图形绘制。文章详细解析了颜色滑块、鼠标回调及主函数逻辑,提供完整代码供参考学习。
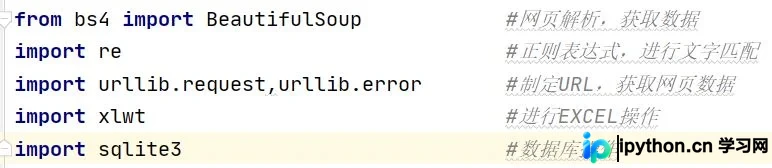
本文详细演示了如何使用Python编写爬虫程序,通过正则表达式和BeautifulSoup解析豆瓣电影Top250网页。文章涵盖了从构建请求头、提取电影链接与名称,到将数据保存为Excel文件和SQLite数据库的完整流程。代码包含完整的函数封装,适合初学者学习网络数据采集与本地存储技术。