Python爬虫常用库有哪些?从Requests到Scrapy的选型指南
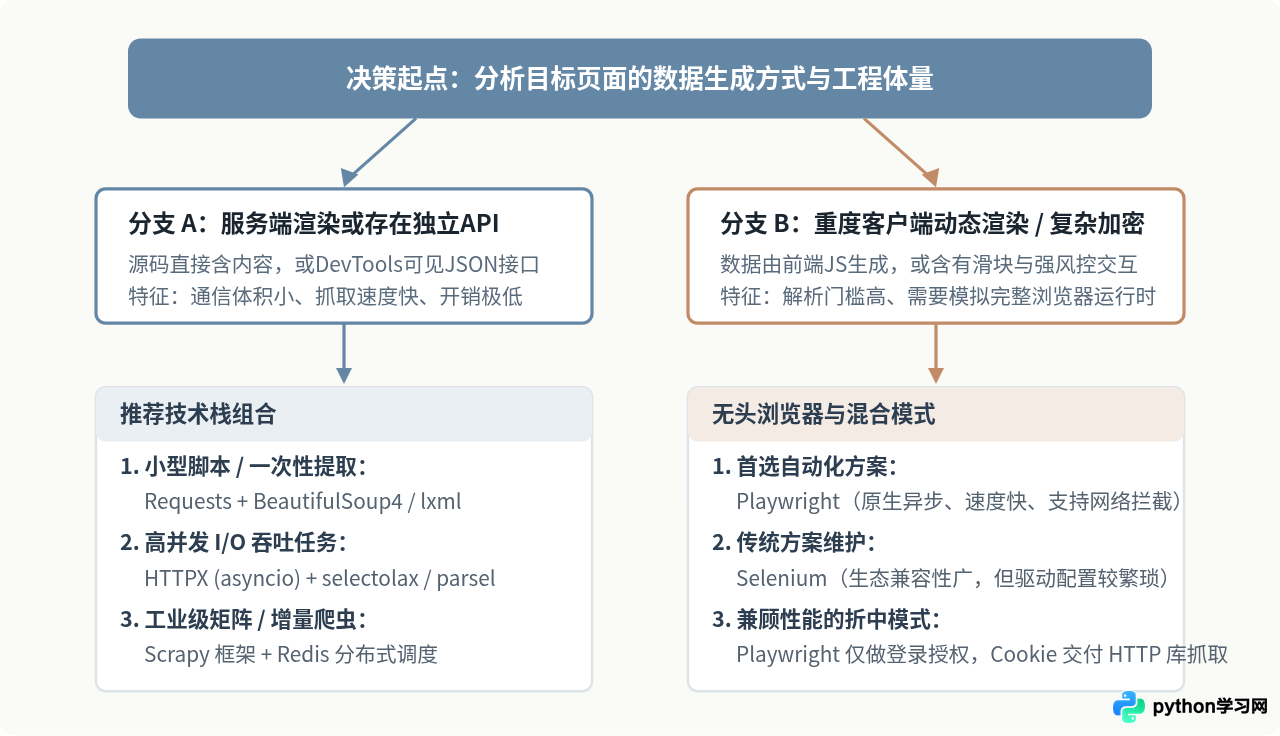
全面梳理Python爬虫核心库,从轻量级Requests、BeautifulSoup,到异步HTTPX与自动化浏览器Playwright,再到工业级Scrapy框架,提供清晰的架构对比、操作流程与选型决策指南。



全面梳理Python爬虫核心库,从轻量级Requests、BeautifulSoup,到异步HTTPX与自动化浏览器Playwright,再到工业级Scrapy框架,提供清晰的架构对比、操作流程与选型决策指南。
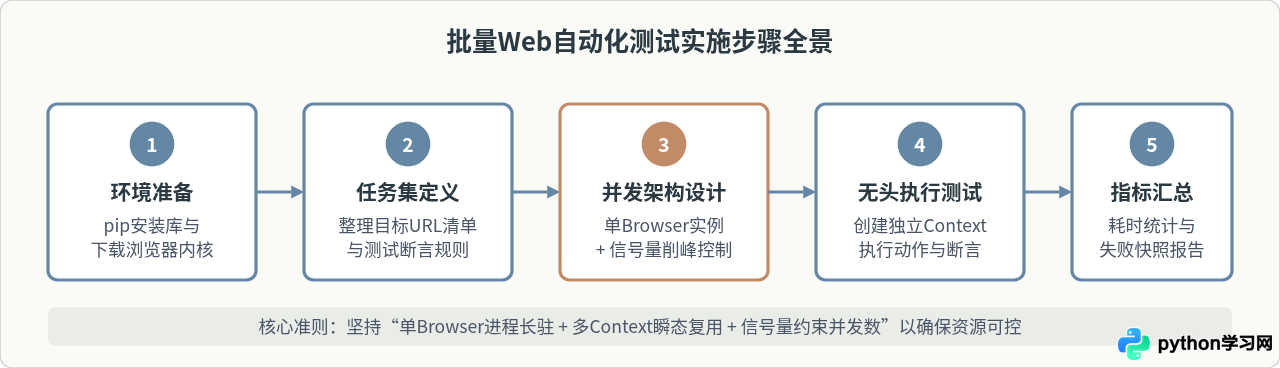
深入讲解如何使用Python结合Playwright的无头模式与BrowserContext上下文隔离技术,借助asyncio实现高性能、低资源占用的批量Web自动化测试。
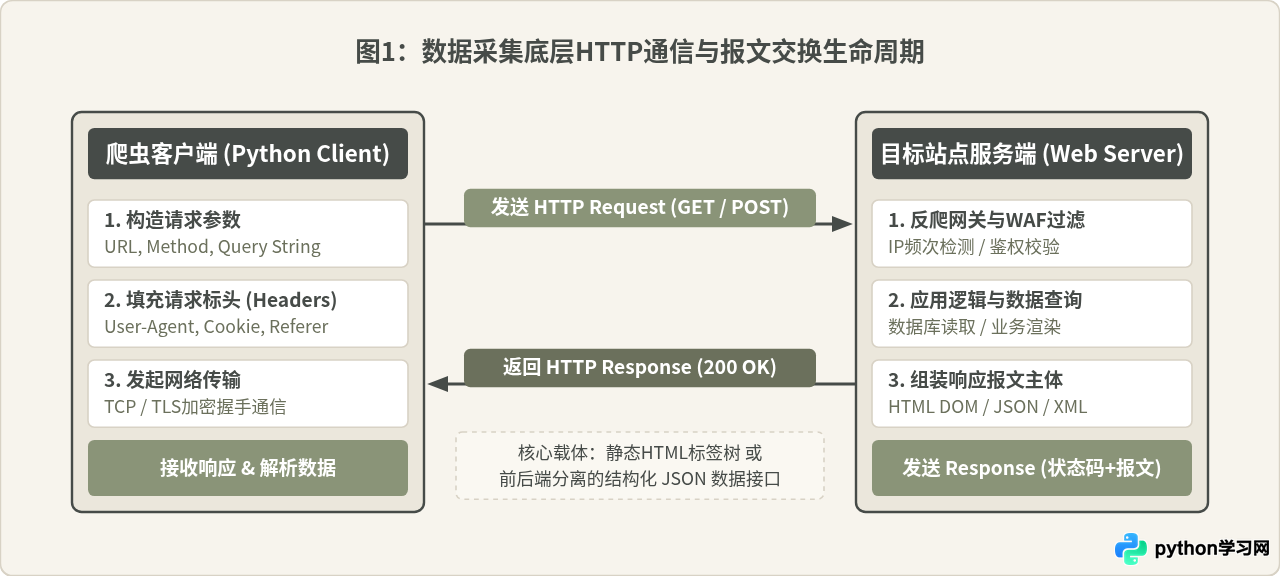
深入解析Python网络爬虫的底层数据采集原理、标准化开发五步流程、常见认知误区辨析以及主流工具生态选型对比,提供清晰实用的实战与工程指引。
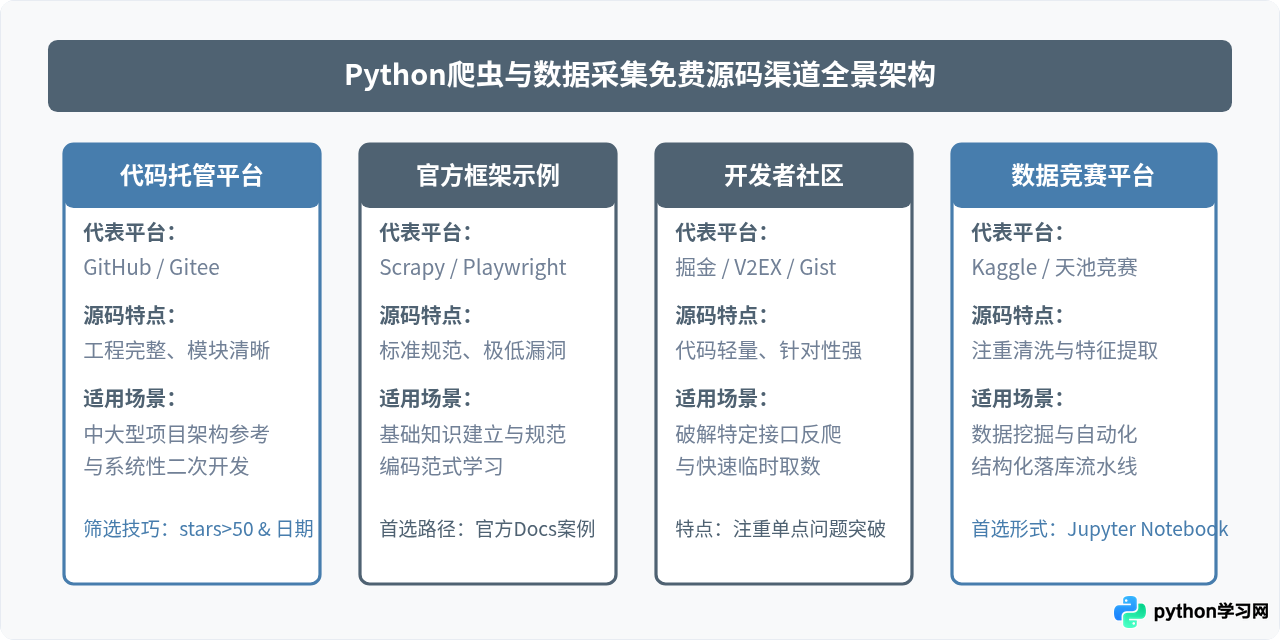
详细介绍寻找Python爬虫与数据采集免费源码的四大可靠渠道、高级搜索与筛选技巧、安全与合规审查方法,以及本地隔离试跑的标准流程。
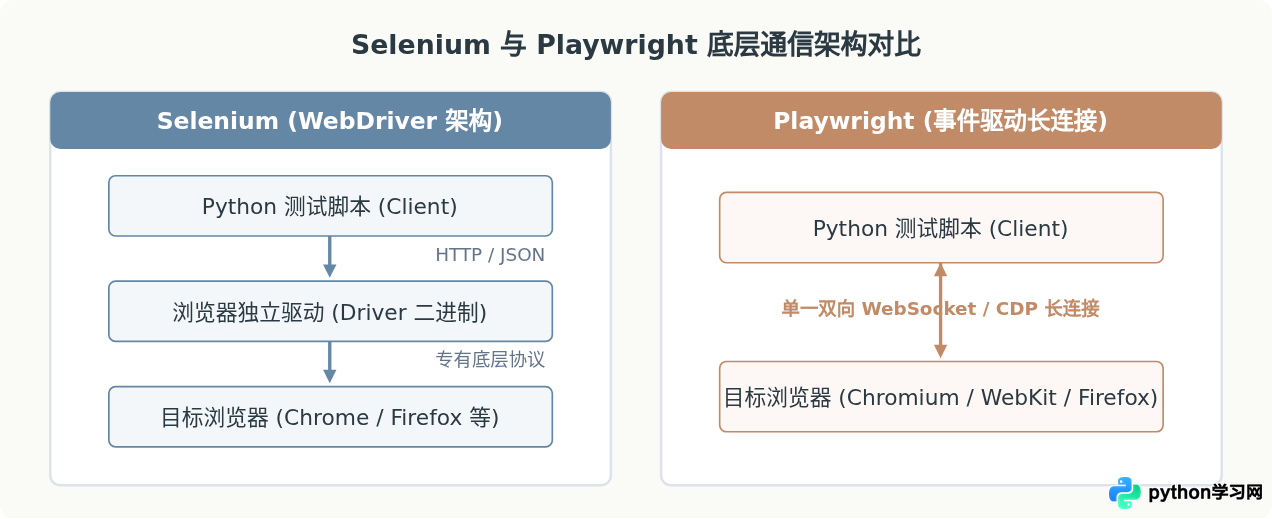
针对Python Web自动化测试初学者,深入对比Selenium与Playwright的技术架构、等待机制、执行性能及适用场景,帮助团队与个人做出合理的工具选型决策。
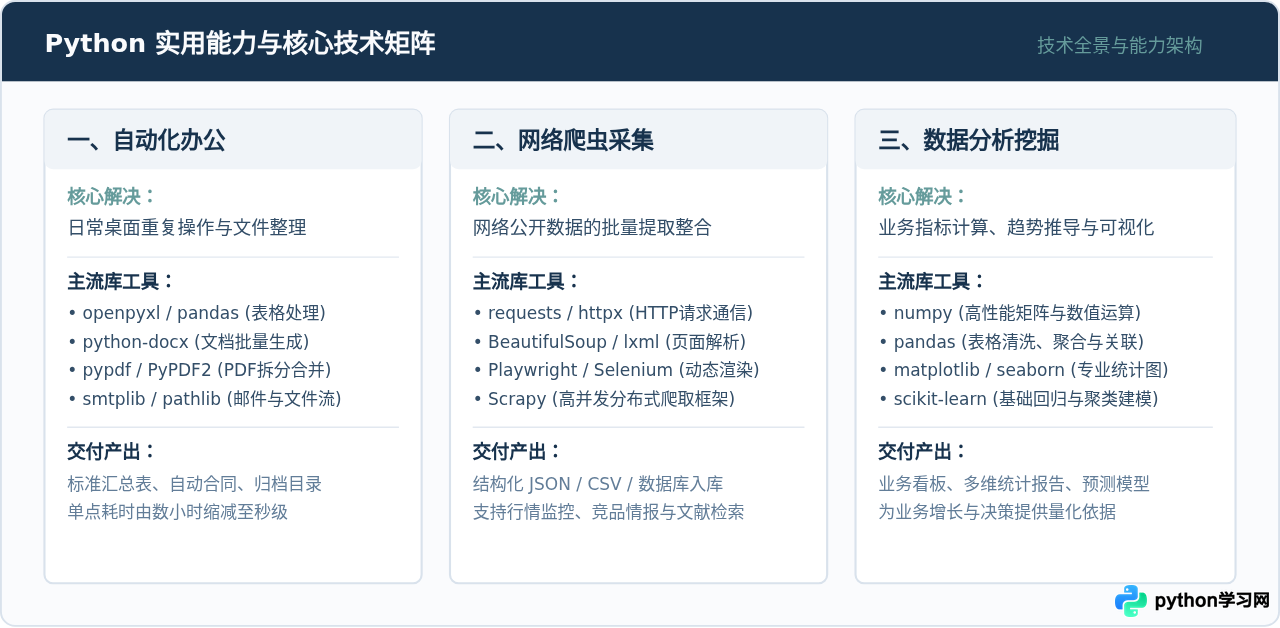
深入解析Python在自动化办公、网络爬虫与数据分析三大领域的实际应用场景、核心工具库、典型执行步骤与选型决策指南。
本文详细介绍如何在Python中使用Playwright结合Pytest进行Web应用程序的端到端测试。内容涵盖pytest-playwright插件的安装、测试用例的编写规范、命令行执行参数配置(如指定浏览器、开启视频录制、忽略HTTPS错误等),以及持久上下文和模拟移动设备等高级用法,帮助开发者高效构建自动化测试流程。
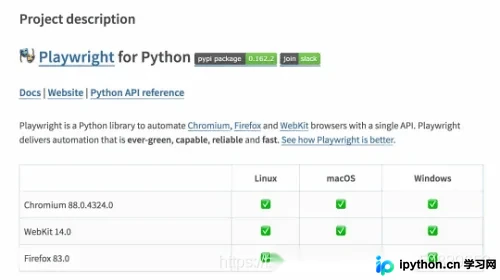
本文详细介绍微软开源的Playwright Python库,支持Chrome、Firefox等主流浏览器及无头/有头模式。通过两步命令即可完成安装,并利用codegen命令实现零代码录制浏览器操作自动生成Python脚本,同时支持同步与异步API调用,结合Pytest可高效完成Web端到端测试。
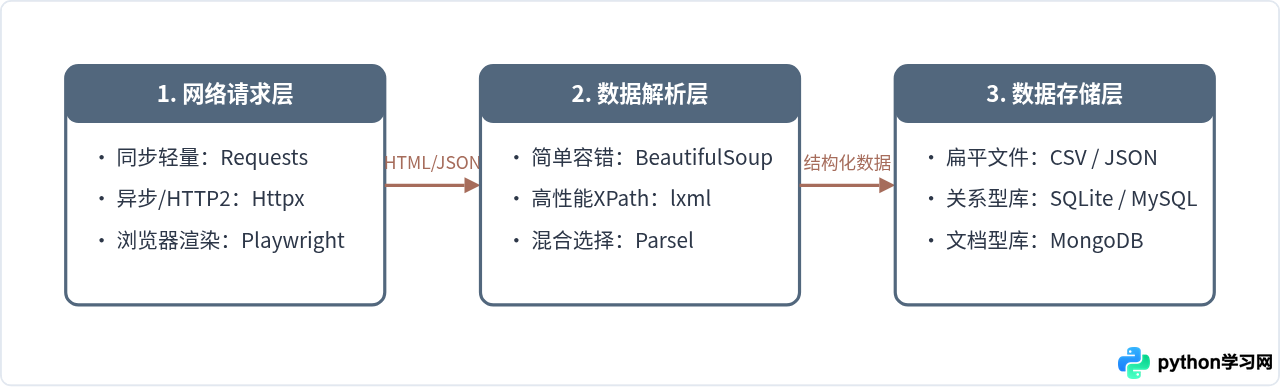
全面梳理Python爬虫技术栈,从网络请求、网页解析到数据持久化存储,结合实际代码和对比分析,提供清晰的技术选型指南。
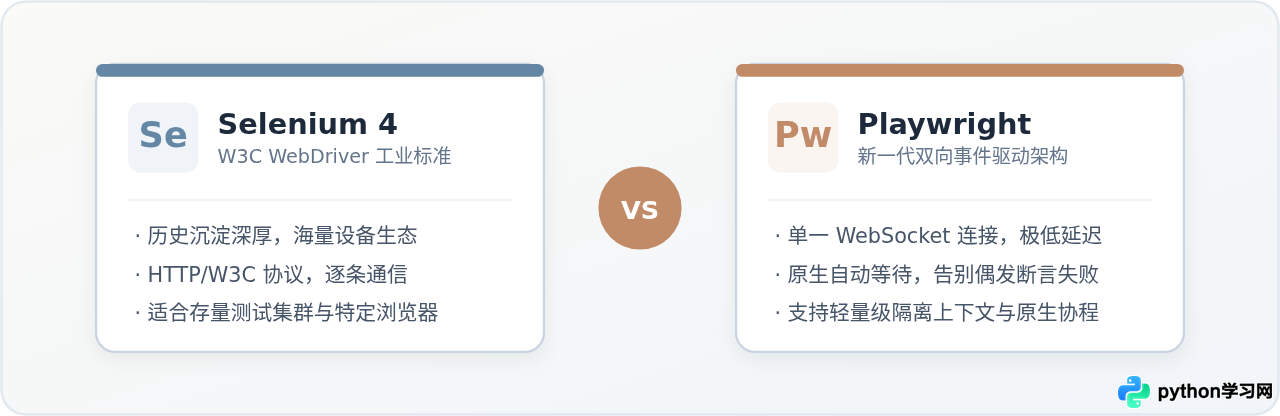
针对Python Web自动化与动态页面抓取场景,深度对比Selenium 4与Playwright在底层架构、自动等待、执行性能、网络拦截和并发隔离等核心维度的差异,并给出清晰明确的选型决策依据。
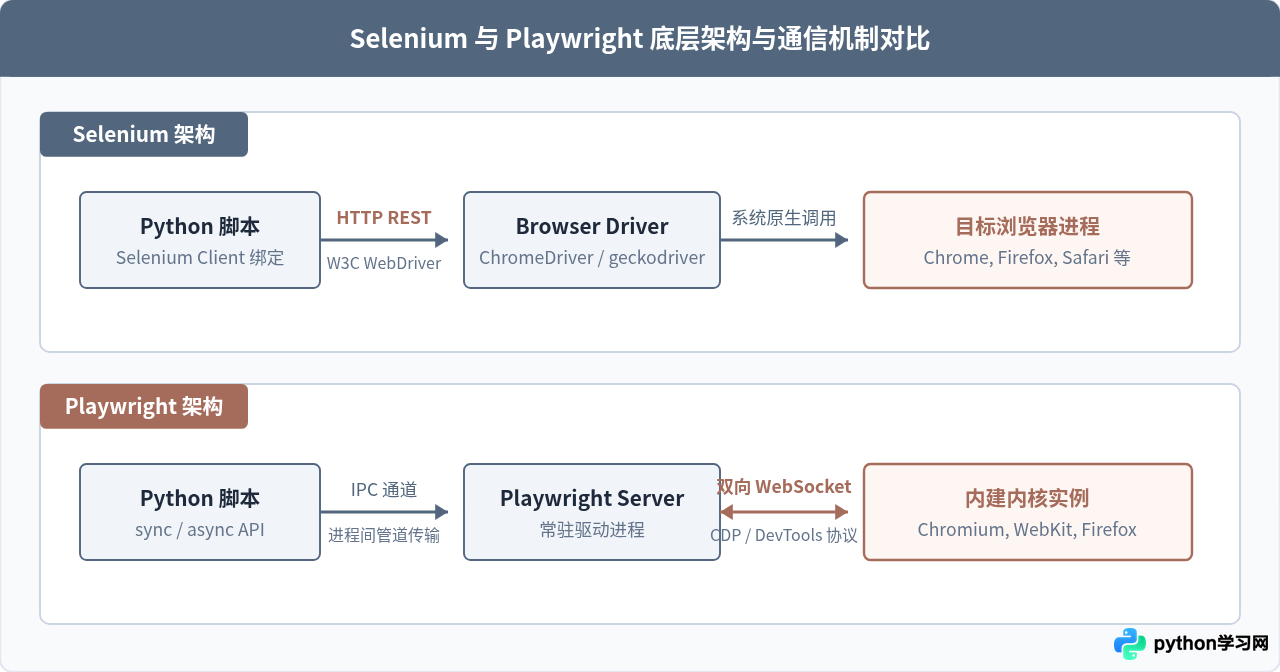
针对Python Web自动化开发,深入对比Selenium与Playwright的底层架构、等待机制、API设计、执行性能及典型应用场景,提供系统化的工程选型决策指南。
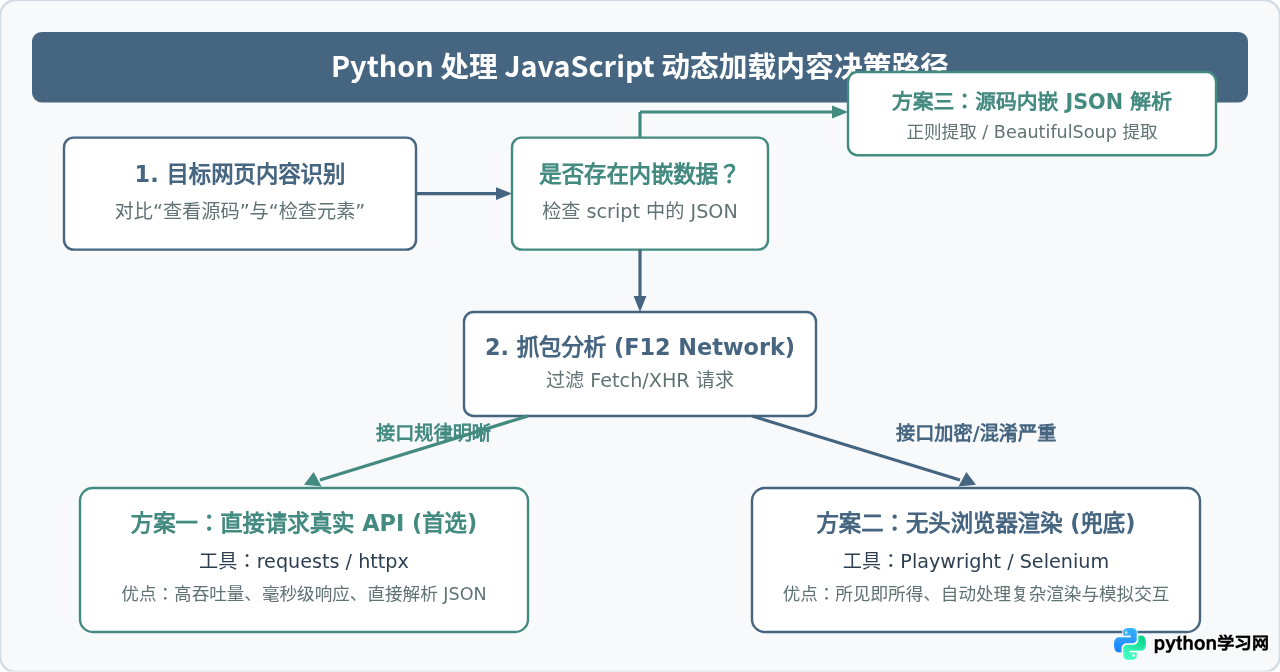
本文详细讲解Python爬虫处理JavaScript动态渲染与加载内容的三种主流方法:抓包逆向直接请求真实接口、使用Playwright无头浏览器自动化以及源码内嵌数据提取,提供完整代码示例、选型对比与排查流程。