Python正则表达式能解决哪些自然语言处理预处理问题
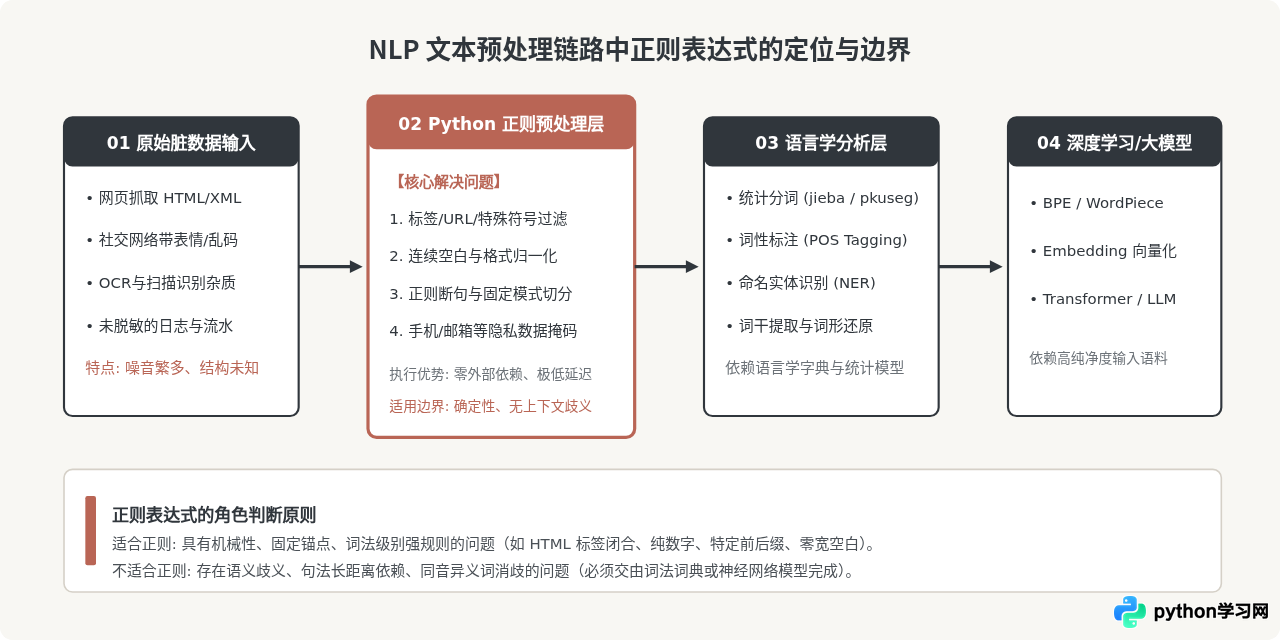
深入解析Python正则表达式在自然语言处理(NLP)数据预处理阶段的具体应用场景、操作方法与能力边界,涵盖文本噪声清洗、格式规范化、规则分词与敏感信息脱敏等关键问题。



深入解析Python正则表达式在自然语言处理(NLP)数据预处理阶段的具体应用场景、操作方法与能力边界,涵盖文本噪声清洗、格式规范化、规则分词与敏感信息脱敏等关键问题。
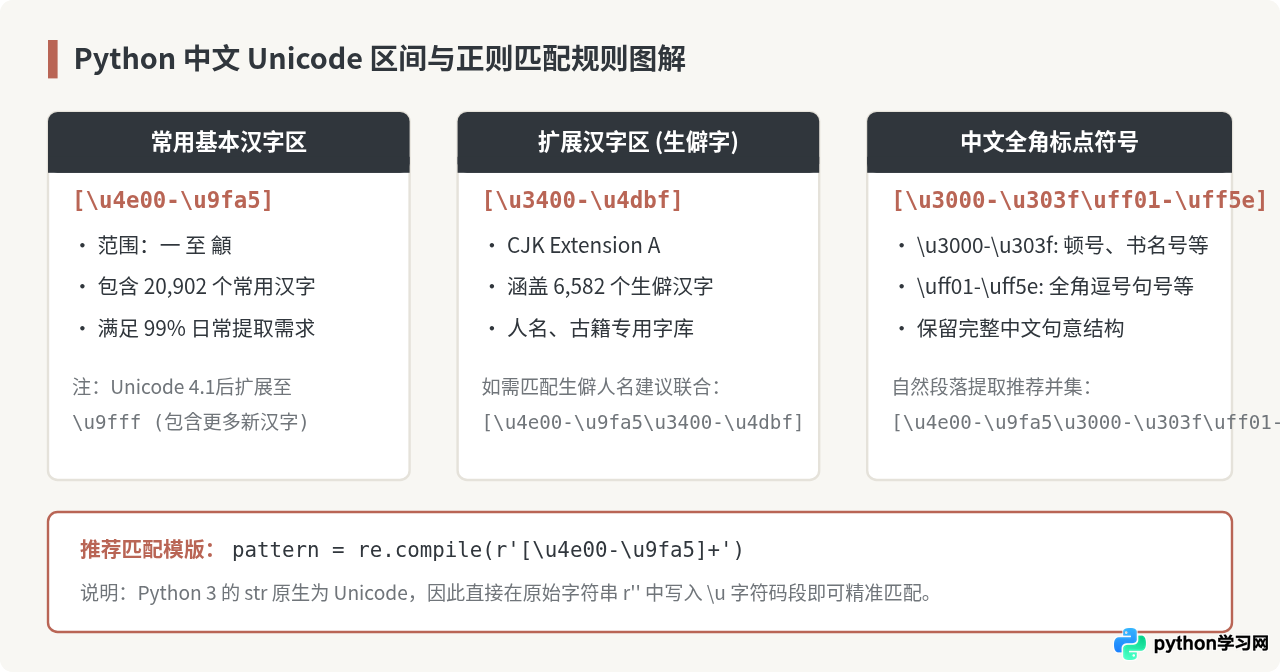
系统介绍在Python中使用re正则表达式模块匹配中文汉字与标点、处理跨行文本与换行符、以及安全转义与清洗特殊字符的具体方法和代码示例。
本文深入讲解如何使用Python标准库re模块结合逐行流式读取,从非结构化日志文件中批量提取IP、时间戳、请求路径、状态码等关键字段,包含预编译正则、命名捕获分组、内存保护与异常处理实战方案。
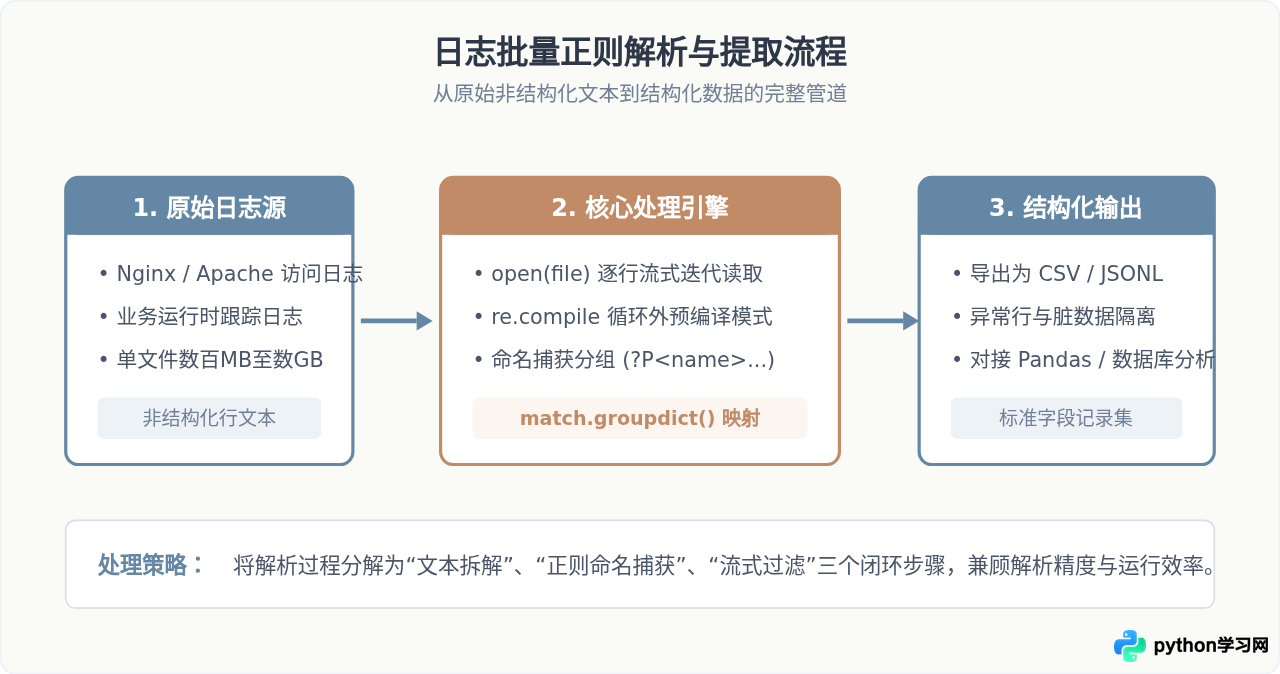
深入解析Python中带有r前缀的原生字符串与普通字符串的核心区别、转义处理机制、典型应用场景以及容易忽略的语法边界与限制。
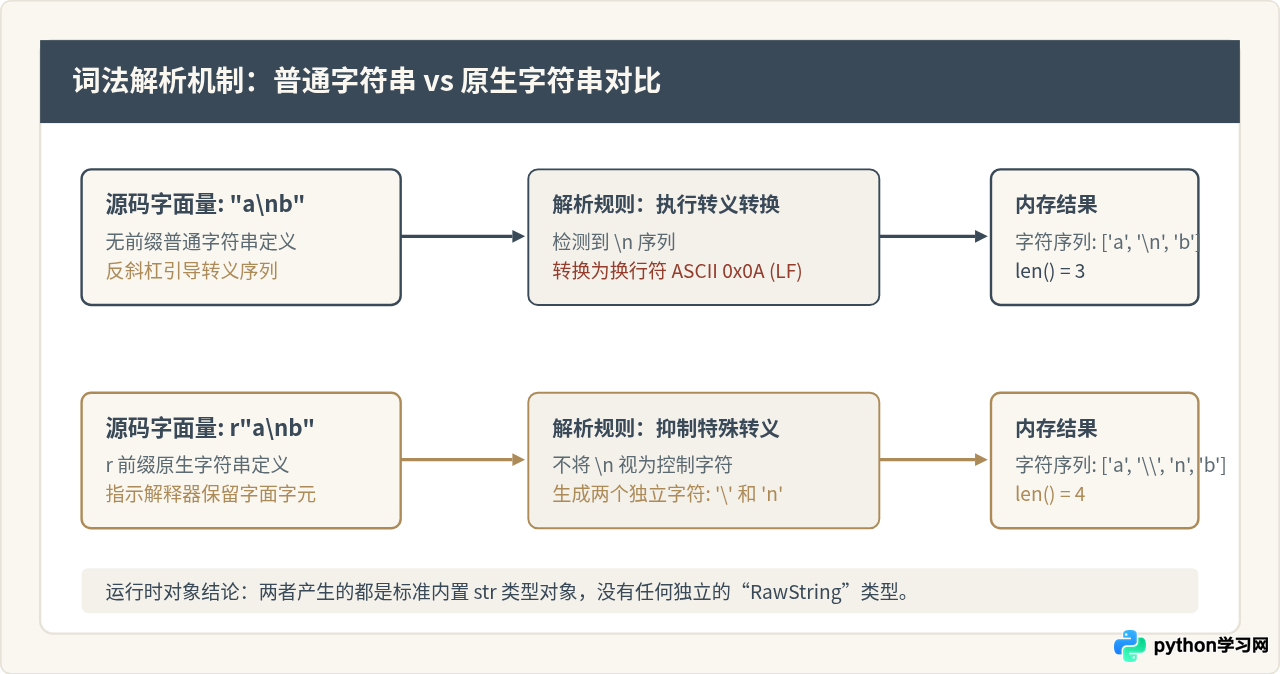
详细讲解如何使用 Python 的 datetime.strptime 解析包含中文字符、不规则分隔符以及非标准格式的日期字符串,并提供实用的预处理与异常容错方案。
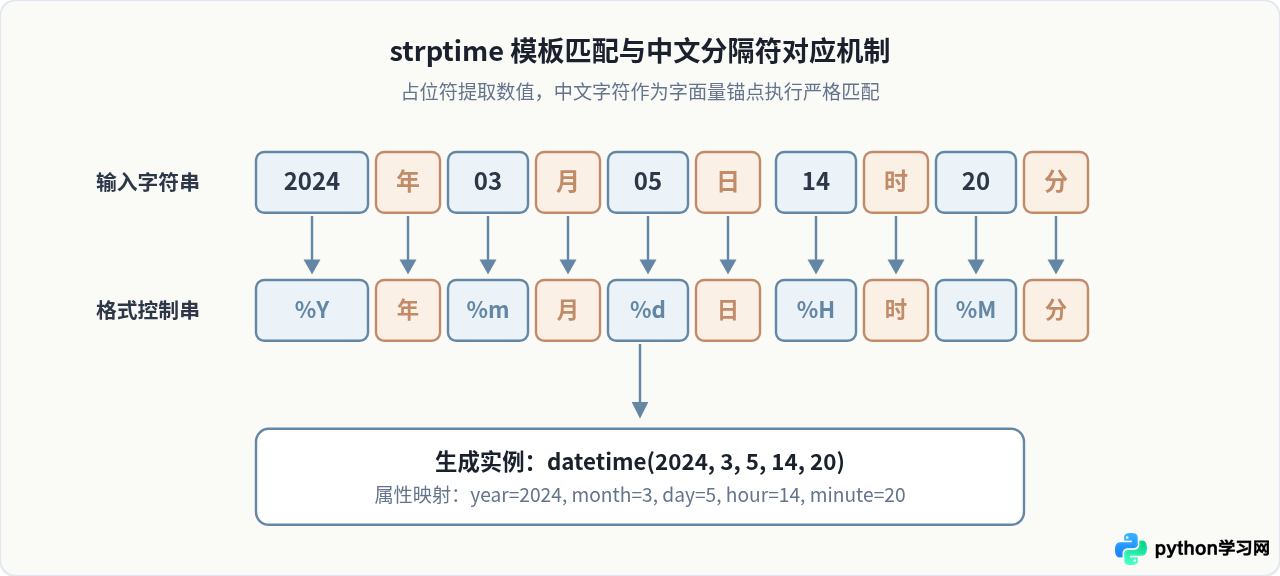
深入对比Python内置str.split与正则表达式re.split在多重分隔符、动态空白等复杂场景下的底层原理、执行耗时与选型决策。
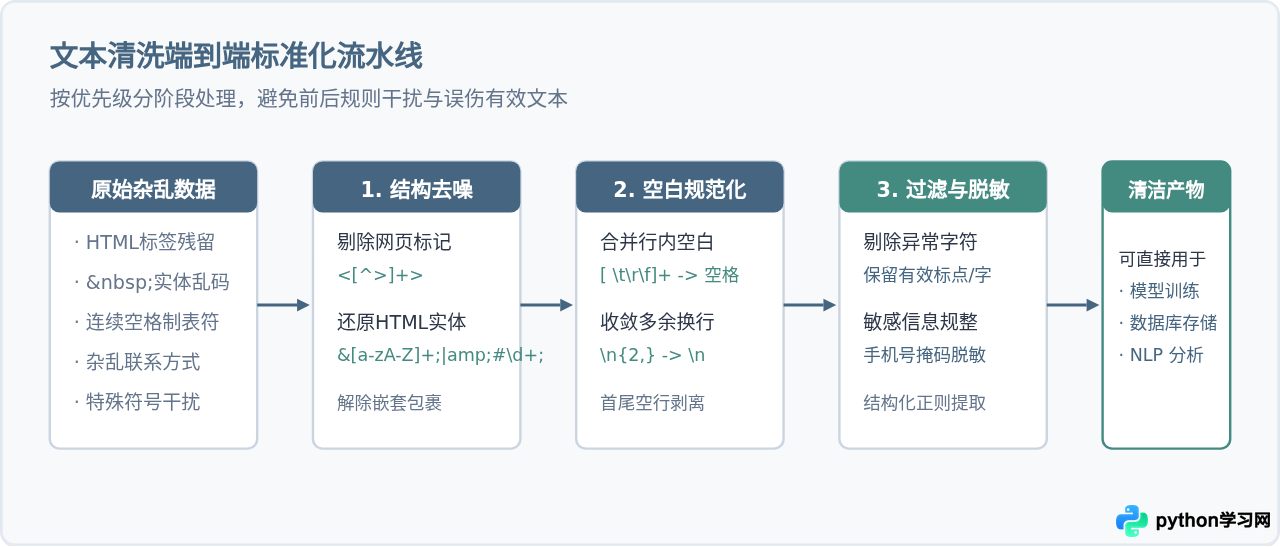
实战案例:用Python正则表达式清洗杂乱文本数据。详细演示如何使用Python内置re模块剥离HTML标签、归一化连续空白、剔除异常符号、提取关键信息并完成格式脱敏。
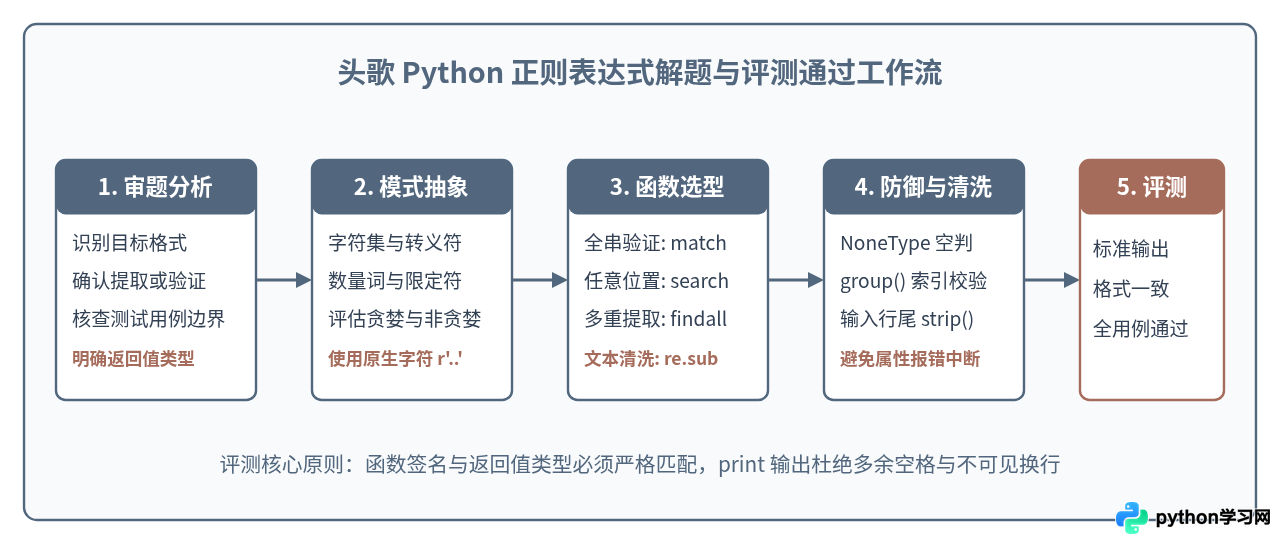
针对头歌Python正则表达式实训中的常见考题进行系统解析,涵盖字符匹配、贪婪与非贪婪机制、分组捕获以及re.sub文本替换,提供完整可复现代码与避坑指南。
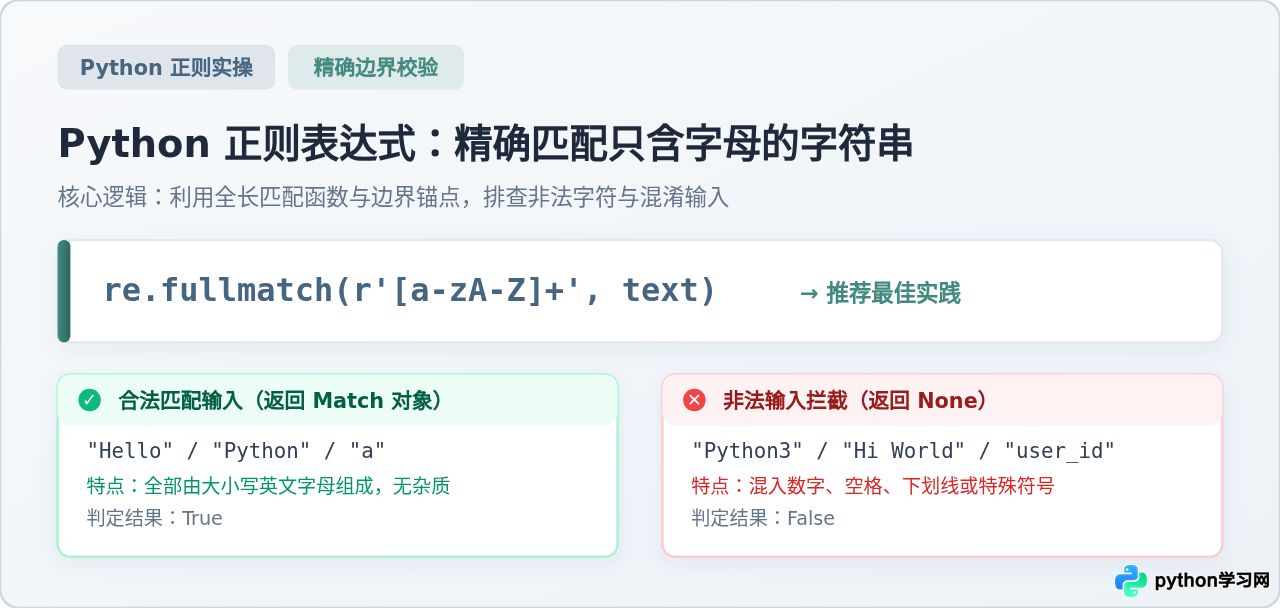
在Python中精确匹配只含英文字母的字符串,最直接且安全的方式是调用re.fullmatch(r'[a-zA-Z]+', text)。本文详细解析正则表达式的构成原理、首尾锚点的约束机制、不同匹配函数的行为差异,以及规避常见匹配漏洞的完整实践方案。
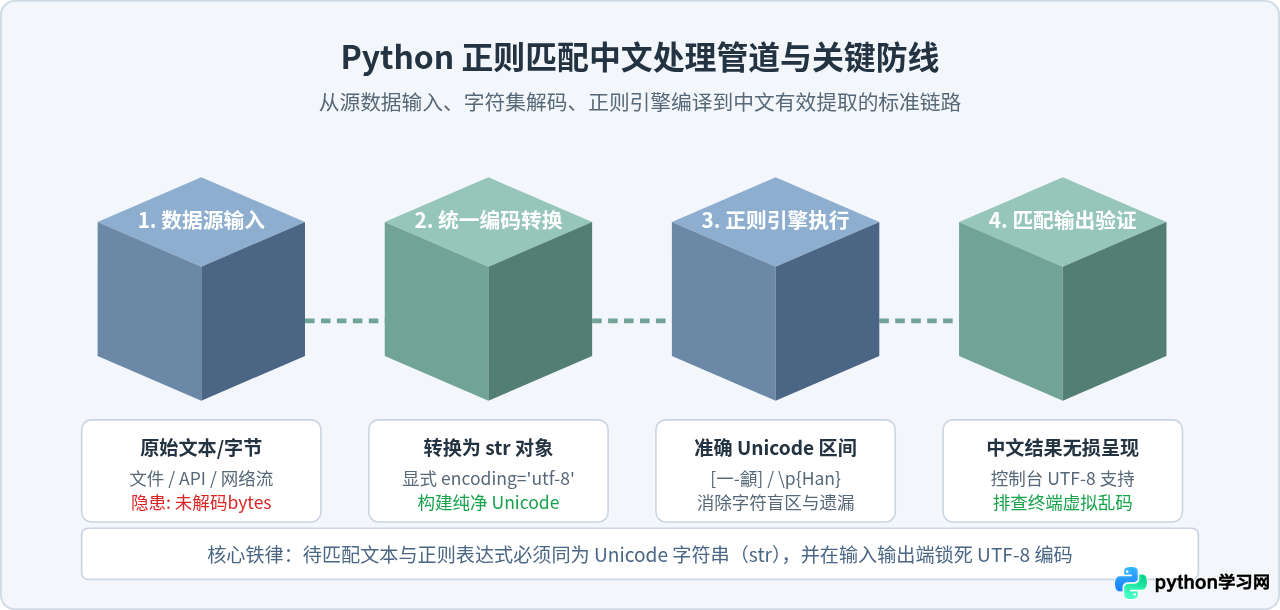
深入解析在Python中使用正则表达式匹配中文时出现匹配失败或乱码的核心原因,从数据类型混淆、字符编码冲突、Unicode区间盲区到终端输出环境逐一排查,提供完整可落地的解决方案与标准代码示例。
深入讲解如何使用Python标准库编写高可靠的定时备份脚本与流式日志分析程序,涵盖环境配置、进程锁、数据校验、流式解析与异常告警的全流程工程实践。
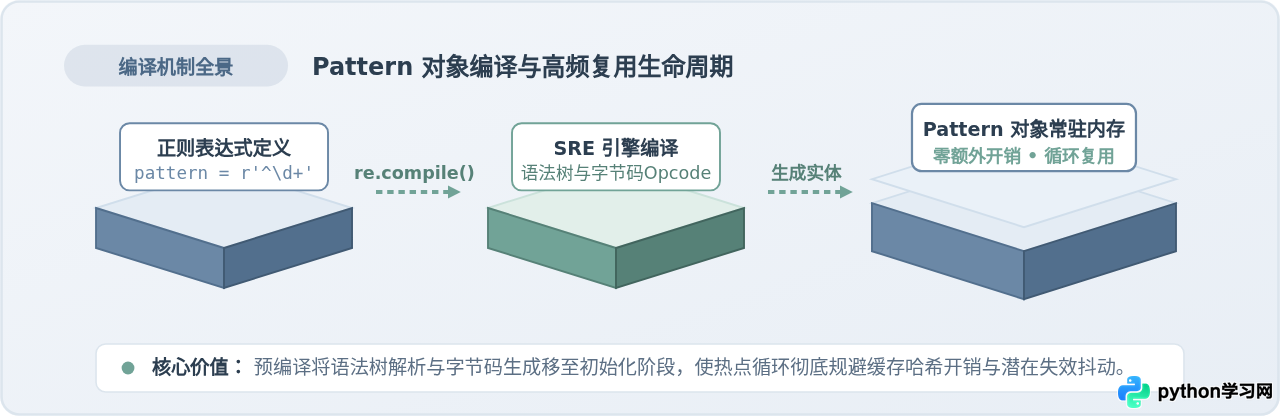
深入解析Python正则表达式re.compile预编译的底层工作机制、re._cache缓存原理,结合实战代码与基准对比,详解预编译的适用场景、规范落地步骤与高频避坑指南。