



把字段中的 NULL 更新为默认值,看起来只是一次普通的 UPDATE,但真正容易出错的地方往往在兼容性、默认值来源和批量更新范围上。本文按常见实战场景拆开说明:先判断该用哪种表达式,再确认所谓“默认值”到底来自表结构还是业务规则,最后补上批量更新和复杂类型字段的避坑要点,方便你在执行前先做出正确判断。
UPDATE 中如何用 COALESCE、CASE 处理 NULL
在标准 SQL 里,COALESCE 是处理 NULL 的常用工具,但它更适合和筛选条件一起使用,而不是无差别改写整列。最稳妥的思路,是显式把 NULL 映射成你要填入的值,并配合 WHERE column IS NULL 限定更新范围。
很多人会先尝试下面这种写法:
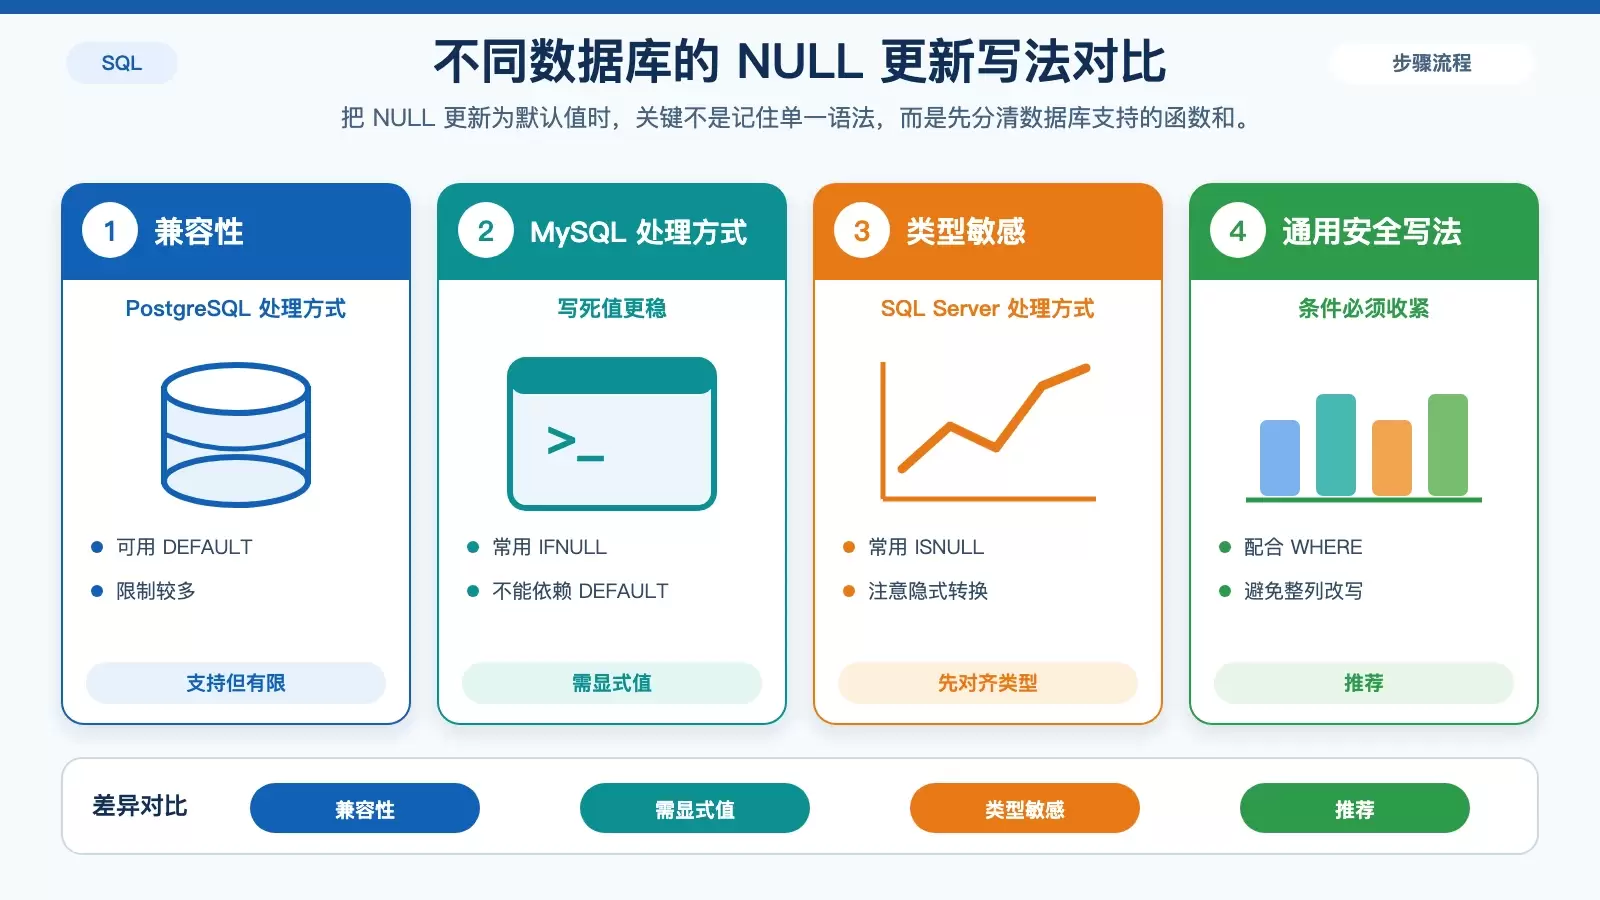
UPDATE table SET column = DEFAULT WHERE column IS NULL问题在于,这种写法并不是各家数据库都能稳定支持。PostgreSQL 可以接受部分场景下的 DEFAULT 关键字,但 MySQL 和 SQL Server 往往不行,可能直接报错,也可能表现和预期不一致。面向跨库场景时,更可靠的方式仍然是明确写出默认逻辑值。
不同数据库的常见写法
- PostgreSQL 支持
DEFAULT关键字,但限制较多,只在部分赋值场景下可用;实际操作中,通常还是直接写COALESCE(column, 'default_value')更稳妥。 - MySQL 不支持把
DEFAULT当成通用赋值表达式来处理,通常需要写死值,或使用IFNULL(column, 'default_value')。 - SQL Server 常见做法是
ISNULL(column, 'default_value'),但要特别注意类型匹配,否则可能触发隐式转换问题。
如果你的更新逻辑不止一种分支,CASE 会比 COALESCE 更灵活。例如某些字段需要按不同条件补不同值时,CASE WHEN ... THEN ... END 更容易维护,也更接近业务规则本身。
UPDATE table
SET column = CASE
    WHEN column IS NULL THEN 'default_value'
    ELSE column
END
WHERE column IS NULL;
无论使用哪种表达式,核心原则都一样:更新条件要收紧,赋值逻辑要写明,不要把“默认值”交给数据库自行猜测。
先确认字段默认值到底来自哪里
SQL 里说的“默认值”,未必就是建表语句中写下的 DEFAULT。在实际项目里,至少有三种来源可能同时存在:数据库约束默认值、应用层补值逻辑,以及业务文档或接口约定。
这也是为什么不能简单看见表结构里有默认值,就直接把所有 NULL 改成那个值。比如一个 INT 字段在表定义中是 DEFAULT 0,但业务约定里却要求把历史空值补成 -1,这时“恢复默认”与“按规则补值”就不是一回事。
如何查询表结构中的默认值
- PostgreSQL 可用
d table_name查看字段定义和约束。 - MySQL 可用下面这条语句查询指定字段的默认值:
SELECT COLUMN_DEFAULT
FROM INFORMATION_SCHEMA.COLUMNS
WHERE TABLE_NAME='xxx' AND COLUMN_NAME='yyy'
查询结果也需要结合语义判断:
COLUMN_DEFAULT为NULL,表示字段没有定义默认值,而不是“默认值就是 NULL”。- 结果可能是字符串常量,例如
'0'。 - 也可能是表达式,例如
current_timestamp(),这类值并不能总是原样搬到UPDATE里复用。
如果一个字段有 NOT NULL 约束,却没有配置 DEFAULT,那你在修补历史数据时填入的值,本质上就是业务补救值,而不是数据库层面的默认值。这个区别最好在执行前先确认,否则后续排查会很麻烦。
批量更新时,怎样避免误伤非 NULL 数据
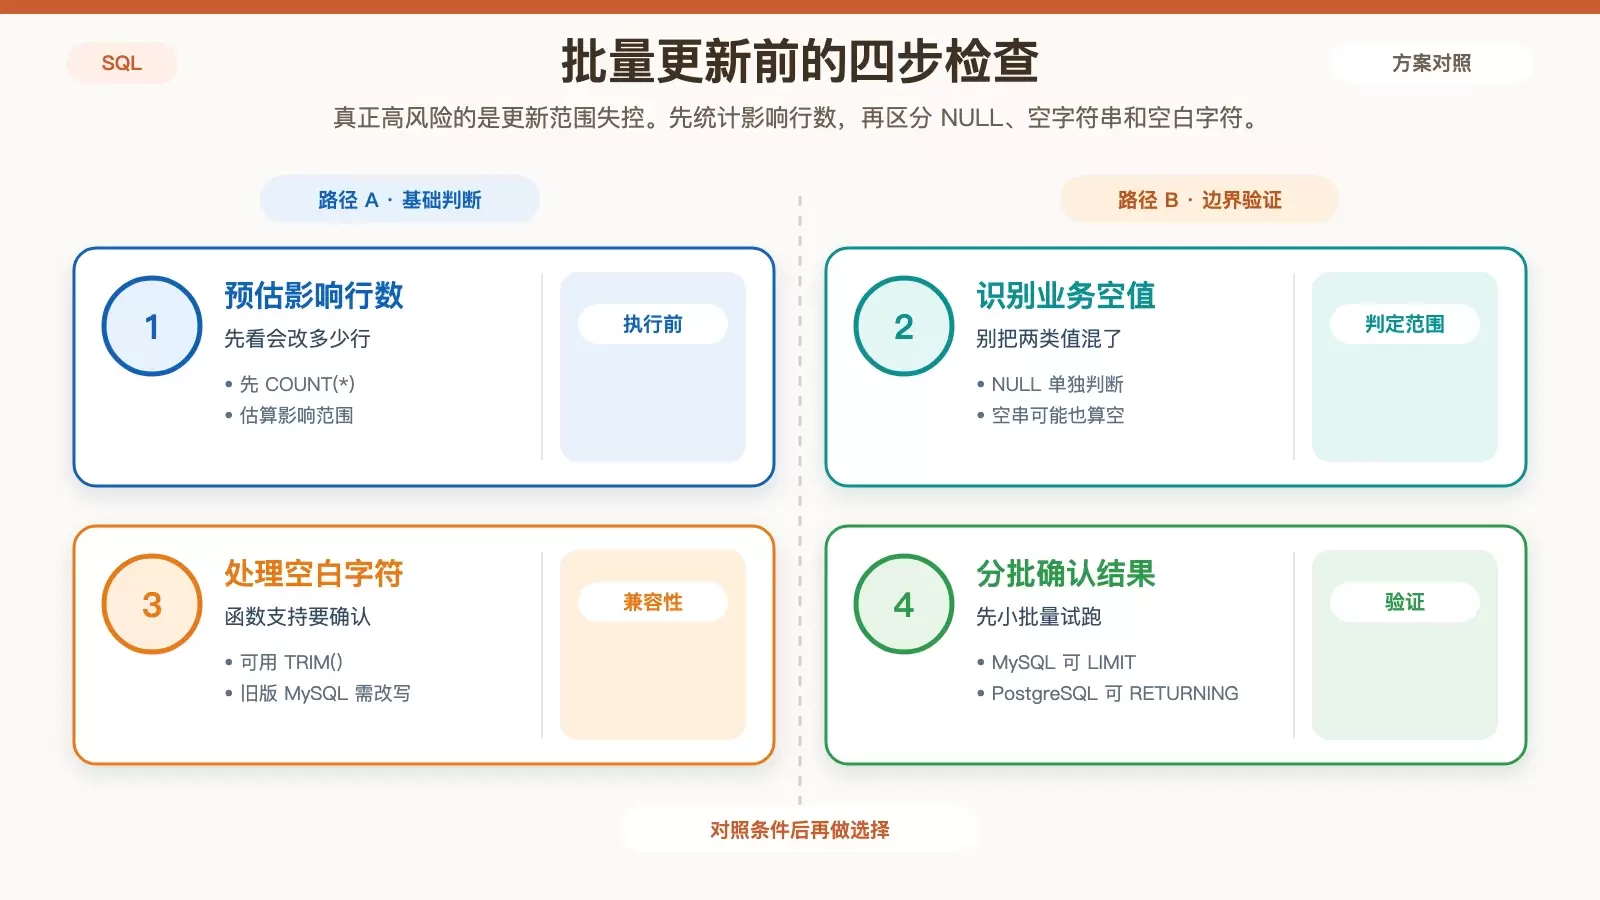
把 NULL 补成默认值,真正高风险的往往不是表达式,而是更新范围控制。最常见的问题就是漏掉 WHERE,结果把整张表都改掉。即便写了 WHERE column IS NULL,也还要进一步判断:业务上视为“空”的值,是否还包括空字符串或只含空格的内容。
安全执行的基本步骤
正式更新前,先统计会受到影响的记录数:
SELECT COUNT(*) FROM table WHERE column IS NULL这样至少能提前知道这次更新是几十行、几万行,还是整表级别的操作。对于线上数据,这一步非常必要。
如果还要把空字符串一起视为无效值,可以把条件写得更明确:
WHERE column IS NULL OR TRIM(column) = ''这里也有兼容性细节需要注意:
TRIM()在 SQLite 中可直接使用。- MySQL 5.7+ 支持
TRIM()。 - 更老的 MySQL 版本,可能需要改写成
RTRIM(LTRIM(column))。
如果数据量较大,建议先做小批量验证。不同数据库也提供了不同的辅助方式:
- MySQL 可在部分场景中使用
UPDATE ... LIMIT 100,先验证前 100 行的结果。 - PostgreSQL 可借助
UPDATE ... RETURNING *直接查看被改动的记录内容。
这些方法的价值不只是“试一下能不能跑通”,更重要的是确认更新条件有没有误伤正常数据,特别是在历史数据质量不一致时。
JSON 和数组字段的 NULL 处理要单独看
对于普通字符串、数字字段,COALESCE 往往已经够用;但一旦字段类型变成 JSON 或 ARRAY,事情就没那么简单了。这里最大的坑是:NULL 和空结构并不是同一个概念,而且很多数据库对字面量类型要求更严格。
例如,NULL 代表“没有值”,而 '{}'、'[]' 代表“有值,但内容为空”。如果直接写成 COALESCE(col, '{}'),数据库可能会因为类型无法推断而报错,因为字符串字面量本身并不一定能被当作合法 JSON 值处理。
不同数据库的正确处理方式
- MySQL:使用
COALESCE(col, CAST('{}' AS JSON)),先把字面量显式转成 JSON。 - PostgreSQL:可写成
COALESCE(col, '{}'::json),或者根据场景使用COALESCE(col, to_jsonb('{}'::text))。
还有一种容易误判的写法,是试图用拼接操作给空值“兜底”,例如:
col = col || '{}'::json这类写法并不能解决问题,因为当左侧值本身就是 NULL 时,NULL || anything 的结果依旧是 NULL。也就是说,拼接并不会把空值自动变成空对象。
遇到 JSON、数组、时间表达式等特殊类型时,最好先在测试环境做小样本验证,确认表达式结果、类型推断和目标字段约束都符合预期,再执行全量更新。NULL 的传播规则本来就容易隐藏问题,一旦叠加类型转换,不同数据库之间的差异会更明显。















