



连续登录这类题目,表面上像是在查“相邻两天有没有登录”,但真正影响结果准确性的,是你如何定义“连续”以及如何给日期序列分段。很多子查询写不对,不是 SQL 语法问题,而是把“序列分组”误写成了“相邻判断”。
下面按实际查询场景展开:先明确连续登录的判定口径,再看为什么常见子查询会误判,接着给出 `ROW_NUMBER()` 的主流写法,以及 MySQL 5.7 和 `LEAD/LAG` 各自适合的使用边界。
连续登录到底怎么定义
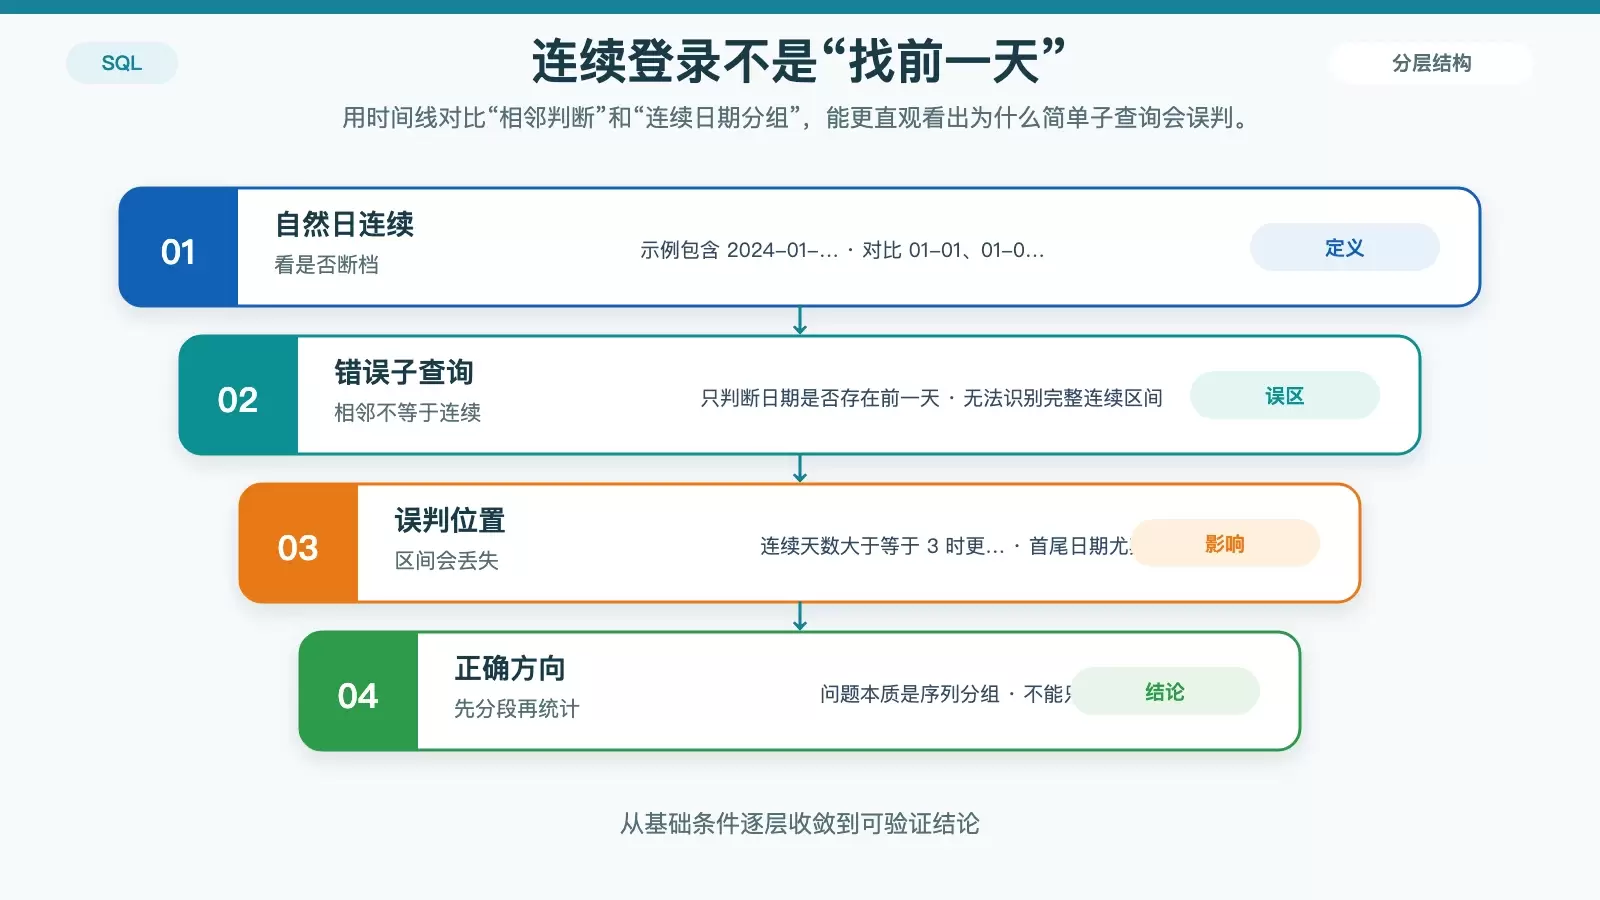
连续登录不是“登录记录每天都很多”,也不是“表里能找到前一天”。它的准确含义是:在自然日维度上,某个用户的登录日期没有断档。
例如:
2024-01-01、2024-01-02、2024-01-03:这是连续 3 天2024-01-01、2024-01-02、2024-01-04:这不算连续,因为缺少2024-01-03
这个前提会直接决定子查询写法。因为你要识别的是“没有间隙的日期序列”,而不是只判断某一天前后是否碰巧存在一条记录。
为什么常见子查询容易误判
很多人一开始会写出类似下面的 SQL:
SELECT user_id
FROM login_log
WHERE DATE(login_time) IN (
  SELECT DATE(login_time) - INTERVAL 1 DAY
  FROM login_log
)
这类写法的问题很明显:它只能说明“某个日期可能存在前一天”,本质上仍然是在做相邻匹配。
只判断相邻一天,无法识别完整连续段
当你要筛选连续大于等于 3 天、5 天甚至更长的用户时,这种写法无法准确识别完整区间,也容易漏掉连续段的首尾记录。它没有回答一个关键问题:哪些日期属于同一段连续序列。
所以,连续登录的核心不是“找前一天”,而是“给连续日期分组”。
主流解法:用 `ROW_NUMBER()` 给连续日期分组
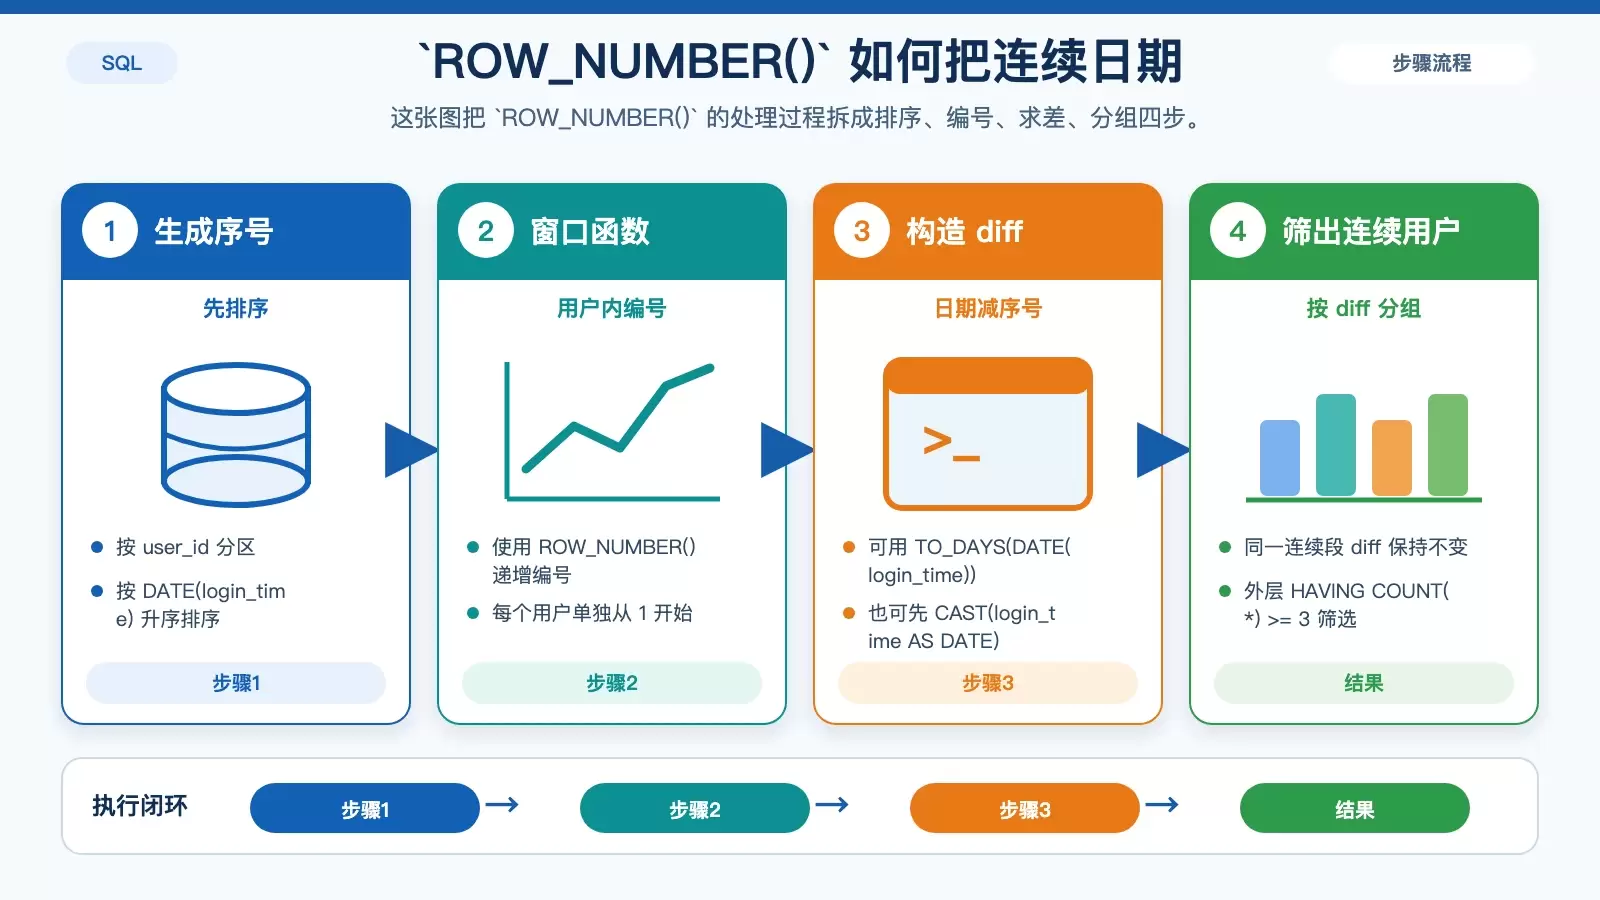
更稳定的做法是:先按用户和日期排序,再利用“日期值 - 序号”恒定这一特征,把同一连续段归为一组。
核心原理是什么
如果某个用户的登录日期连续递增,而对应的序号也是按 1、2、3 递增,那么“日期转换后的天数 - 序号”会保持不变。这样,同一段连续登录记录就会得到相同的分组值。
这个思路适用于 MySQL 8.0+、PostgreSQL、SQL Server,兼顾可读性和可维护性。
实操步骤
- 先用
ROW_NUMBER() OVER (PARTITION BY user_id ORDER BY DATE(login_time))为每个用户生成递增序号 - 把
DATE(login_time)转成可参与减法的天数,例如TO_DAYS(DATE(login_time))或CAST(login_time AS DATE) - 用“日期天数 - 序号”得到分组键
- 外层按
user_id和分组键聚合,再通过HAVING COUNT(*) >= 3筛出连续至少 3 天的用户
MySQL 示例
SELECT user_id
FROM (
SELECT user_id,
 TO_DAYS(CAST(login_time AS DATE)) -
 ROW_NUMBER() OVER (PARTITION BY user_id ORDER BY CAST(login_time AS DATE)) AS diff
FROM login_log
) t
GROUP BY user_id, diff
HAVING COUNT(*) >= 3;
这里要注意保留自然日粒度。如果原始字段包含时分秒,必须先统一到日期层级,否则同一天多次登录会干扰结果。
MySQL 5.7 没有窗口函数怎么办
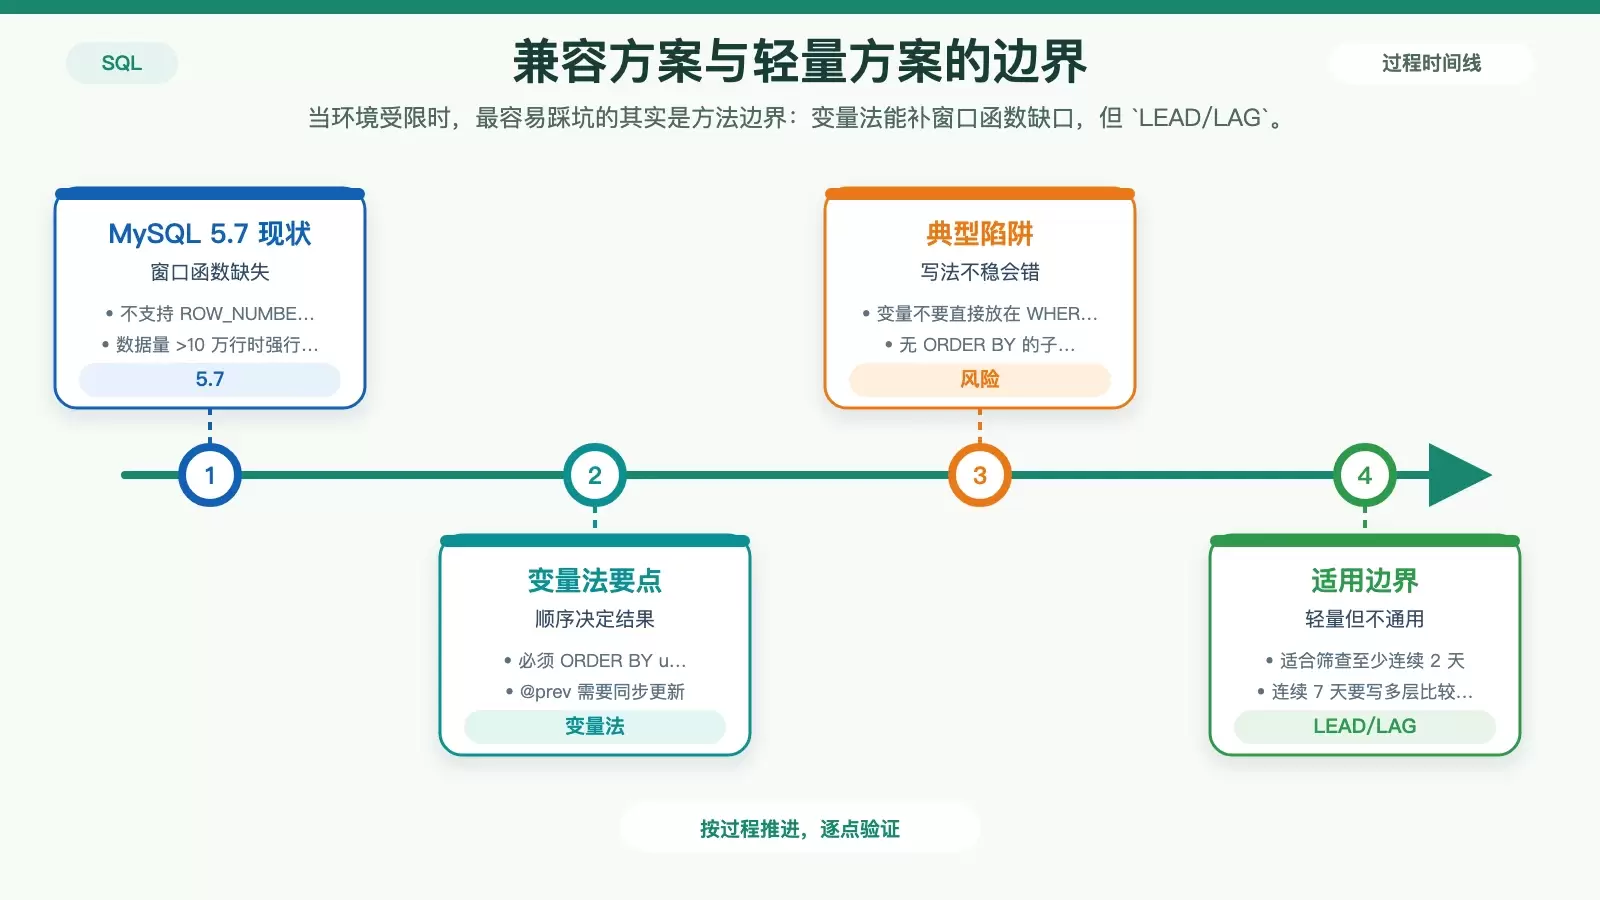
MySQL 5.7 不支持 ROW_NUMBER(),这时通常只能用自连接或变量模拟序号。实际项目里,如果数据量已经超过 10 万行,强行堆子查询关联,性能往往会明显变差。
相比之下,变量法更可控,但前提是你必须严格处理执行顺序。
变量法的几个关键点
- 必须使用
ORDER BY user_id, login_date,确保变量按预期顺序赋值 - 变量不要直接写在同一层级的
WHERE或HAVING中,通常需要外面再包一层 @rn := IF(@prev = user_id, @rn + 1, 1)这类写法里,@prev要同步更新,否则序号会错乱
一个常见陷阱
SELECT @rn := @rn + 1 如果出现在没有 ORDER BY 的子查询里,行为并不可靠,因为 MySQL 可能重排执行顺序。结果看起来能跑通,但并不稳定,尤其不适合直接上线。
为什么 `LEAD()` / `LAG()` 不是通用解法
LEAD() 和 LAG() 的优势是轻量,适合快速查看相邻记录之间的关系;但它们并不擅长处理“连续 N 天”这种序列型问题。
它的问题出在哪里
这两个函数只能查固定偏移。比如你想查连续 7 天,就要层层比较后续 6 天,SQL 很快会变得又长又难维护。一旦中间某一天缺日志,整条链也会直接断掉。
因此,它更适合筛查“是否至少连续 2 天”,而不是统计最长连续天数,或者筛出连续 N 天的用户。
适合的轻量写法
SELECT DISTINCT user_id
FROM (
SELECT user_id,
 DATE(login_time) AS d1,
 LEAD(DATE(login_time), 1) OVER (PARTITION BY user_id ORDER BY login_time) AS d2
FROM login_log
) t
WHERE DATEDIFF(d2, d1) = 1;
这段 SQL 可以快速找出存在“至少连续两天登录”的用户,但不要把它当作连续登录统计的通用模板。
真正上线前,还要补哪些约束
连续登录的本质,是序列分组问题,不是简单的相邻判断。SQL 写对只是第一步,真正上线时还要把数据口径约束清楚。
- 登录时间是否包含时分秒,是否已经统一转成自然日
- 时区是否统一,跨时区数据会不会导致日期偏移
- 同一用户同一天多次登录,是否需要先去重
NULL值或异常时间是否要提前过滤
如果这些边界没有在子查询里显式约束,最终跑出来的“连续用户”结果,很可能混入大量脏数据。
小结
查询连续登录用户时,最容易犯的错误,是把问题理解成“判断前一天是否存在”。但真正可靠的做法,是先把用户登录日期按自然日排序,再通过“日期值 - 序号”给连续区间分组。
如果数据库支持窗口函数,优先使用 ROW_NUMBER();如果还是 MySQL 5.7,就要格外注意变量法的顺序和嵌套层级。至于 LEAD() / LAG(),更适合作为轻量筛查工具,而不是完整解法。















