



查“第二高薪资”并不只是把排序结果拿第 2 行这么简单。只要数据里出现并列最高、全员同薪,或者数据库版本不同,原本看似顺手的写法就可能出现结果偏移、空集甚至直接不兼容。下面按实际使用场景拆开讲:先看几种常见方案分别解决什么问题,再说明为什么子查询排除最大值的写法通常最稳,最后补上几个容易踩坑的错误示例,方便你在不同 SQL 方言里快速判断。
先明确:你要找的是哪一种“第二高”
很多 SQL 题目表面只问“第二高薪资”,但真正决定写法的是业务定义。比如最高薪资如果有两个人都拿 15000,你是要返回去重后的第二个薪资值,还是按排序后物理上的第 2 行?这两个答案并不一样。
如果问题是“严格第二高的薪资值”,通常应先去掉重复薪资,再取次大的那个值。本文后面提到的 LIMIT/OFFSET、嵌套 MAX() 和窗口函数方案,都是围绕这个定义展开的。除此之外,还要提前确认两件事:
- 薪资字段是否可能出现
NULL - 当全表只有一种薪资时,业务是接受空结果,还是希望返回
NULL
这些细节会直接影响你最后选哪种写法。
方案一:用 LIMIT 和 OFFSET 跳过最高值
最直观的方式,是先把薪资按降序排列,再跳过第 1 个值,取后面的第 1 个:
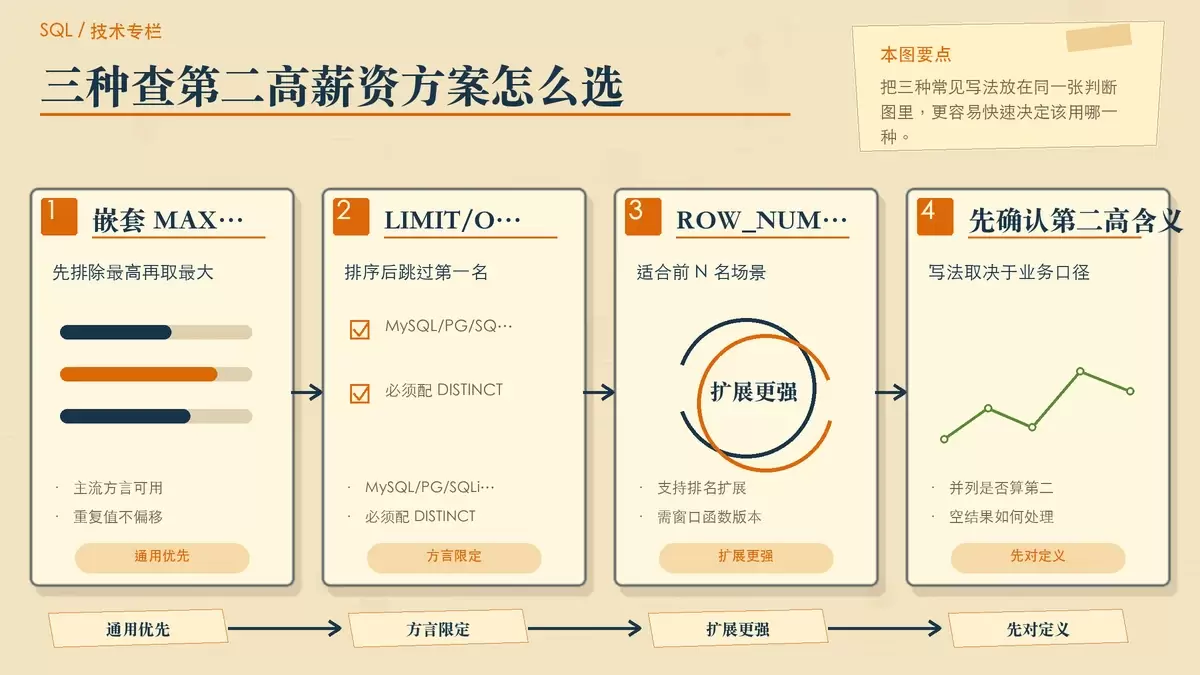
SELECT DISTINCT salary FROM employee ORDER BY salary DESC LIMIT 1 OFFSET 1这类写法的好处是短,读起来也直接,适合 MySQL、PostgreSQL 和 SQLite 这类支持 LIMIT ... OFFSET ... 的数据库。不过它有一个前提:你查的是“去重后的第二高薪资”,所以这里的 DISTINCT 不能省。
如果不加 DISTINCT,当最高薪资重复时,偏移就会错位。比如两条记录都是最高薪资,OFFSET 1 只是跳过第一条记录,下一条仍可能是同一个最高值,这样拿到的就不是严格意义上的第二高。
这一方案的使用边界也很明确:
- 适用于 MySQL / PostgreSQL,SQLite 也支持
- SQL Server 和 Oracle 不支持这种
OFFSET写法 - 如果全表只有一条记录,查询会返回空结果,不会报错
所以它适合数据库方言明确、需求也简单的场景,但不适合作为通用答案。
方案二:用子查询排除最大值,再取 MAX
如果你更在意兼容性和语义清晰度,最稳妥的写法是先找出最高薪资,再在“小于最高值”的范围里取最大值:
SELECT MAX(salary) FROM employee WHERE salary < (SELECT MAX(salary) FROM employee)这也是多数情况下最推荐的方案。原因很简单:它直接把“第二高”的含义翻译成 SQL 逻辑,不依赖分页语法,也不会因为最高值重复而偏移错位。
这个写法有几个实际优点:
- 兼容所有主流 SQL 方言
- 天然规避重复最高值带来的干扰
- 语义直接,后续维护时不容易误解
同时也要注意边界情况。如果所有人的薪资都相同,那么内层 SELECT MAX(salary) 能查到一个值,但外层条件 salary < ... 对所有记录都不成立,最终结果会是 NULL。这一点和前面的 LIMIT/OFFSET 返回空集不同,业务上是否接受,要提前确认。
还有一个常见误区,是把它改写成 NOT IN 形式,例如:
salary NOT IN (SELECT MAX(...))这种替换并不可靠。只要子查询结果里涉及 NULL,整个条件就可能变成 UNKNOWN,最终导致结果为空。看起来只是换了一种写法,实际语义已经变了。
性能方面,这条 SQL 看上去像是扫描了两次表,但在大多数主流数据库里,优化器通常会结合索引做处理,实际开销通常不是问题。对这类题目和常规业务查询来说,可读性和正确性通常比“少写一次扫描”更重要。
方案三:用窗口函数取排名第 2
当数据库支持窗口函数,而且你希望把“去重后的薪资值”显式编号时,可以使用 ROW_NUMBER():
SELECT salary FROM (SELECT salary, ROW_NUMBER() OVER (ORDER BY salary DESC) AS rn FROM (SELECT DISTINCT salary FROM employee) t) t2 WHERE rn = 2这条语句的关键点不在 ROW_NUMBER() 本身,而在内层那一层 SELECT DISTINCT salary。如果不先去重,相同薪资会落在不同的行上,被分配不同的 rn,结果就不再表示“第二高薪资值”,而只是“排序后的第 2 行”。
这一方案适用的数据库包括 SQL Server、PostgreSQL、MySQL 8.0+ 和 Oracle。需要特别留意的是,MySQL 5.7 以及更早版本并不支持窗口函数。
为什么这里更适合用 ROW_NUMBER() 而不是 RANK()?因为题目如果要的是去重后的第二高值,那么在已经做过 DISTINCT 的前提下,ROW_NUMBER() 会按顺序稳定编号,表达更直接。若表中最终只有 1 个薪资值,rn = 2 查不到结果,返回空集,这一点与 LIMIT/OFFSET 的行为一致。
窗口函数的优势是扩展性更强。今天你查第二高,明天可能就想查前 3 名、倒数第 4 名,或者同时返回薪资和排名,这时窗口函数会比嵌套 MAX() 更容易延展。
常见误写:为什么不要把“第二高”硬塞进 WHERE
不少人会把“找第二高”写成下面这种形式:
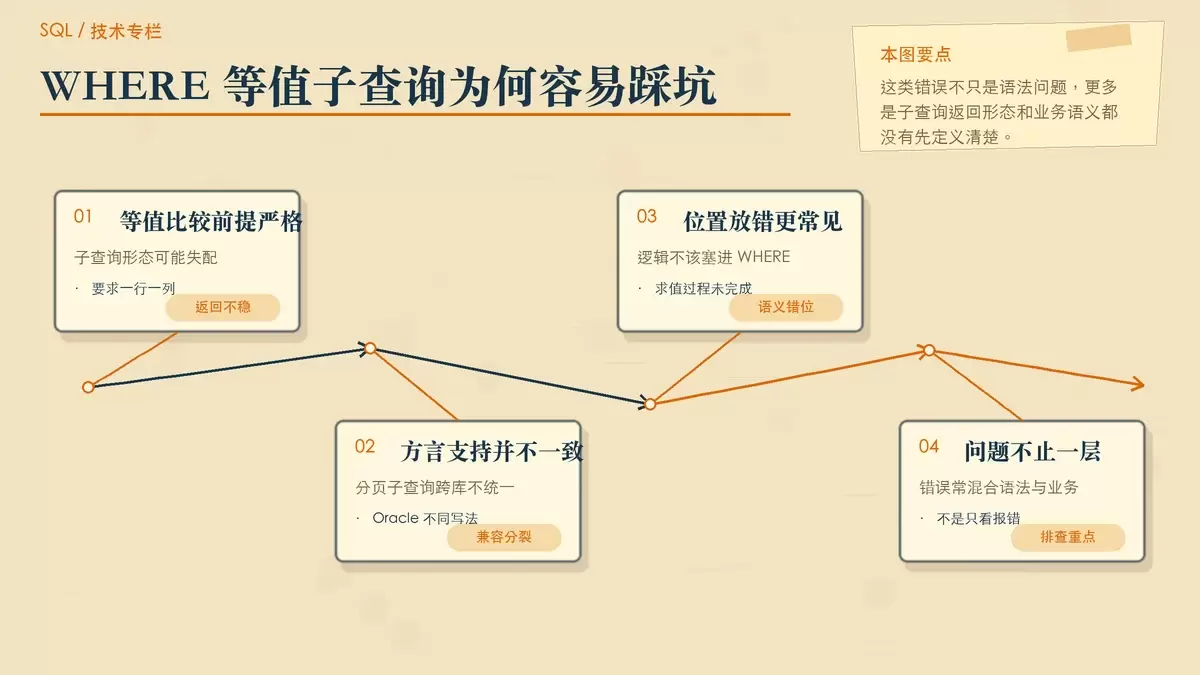
SELECT salary FROM employee WHERE salary = (SELECT DISTINCT salary FROM employee ORDER BY salary DESC LIMIT 1 OFFSET 1)这类写法看上去像是在先求一个值,再去原表匹配,但它在不少数据库里要么报错,要么逻辑不稳定。问题主要有三层。
子查询返回形态不稳定
WHERE ... = (subquery) 要求子查询返回恰好一行一列。但当结果不存在时,这类带 LIMIT/OFFSET 的子查询可能返回空集,而不是你以为的 NULL,这会让整个条件表达式处在不稳定状态。
方言兼容性本来就不统一
即使某些数据库能执行,带分页语义的子查询也不属于最稳妥的标准 SQL 表达。Oracle 和 SQL Server 在这类写法上的支持方式就与 MySQL、PostgreSQL 不一致,跨库迁移时很容易出问题。
逻辑位置放错了
“找第二高”本质上是一个求值过程,应该在子查询的 SELECT 结果里完成,而不是把尚未稳定定义好的结果硬塞进 WHERE 等值条件中。换句话说,先把“第二高是多少”算清楚,再决定是否要和原表做匹配,这样语义才完整。
实战里该怎么选
如果只是回答“第二高薪资是多少”,并且希望写法兼容、稳定、容易维护,优先使用下面这条:
SELECT MAX(salary) FROM employee WHERE salary < (SELECT MAX(salary) FROM employee)它兼容所有主流 SQL 方言,语义也最接近题目本身。
如果你所在的环境明确是 MySQL、PostgreSQL 或 SQLite,而且只是想快速拿到去重后的第二高值,可以考虑 LIMIT 1 OFFSET 1,但一定记得加上 DISTINCT。
如果数据库支持窗口函数,并且后续可能扩展到更多排名需求,比如前 N 名、分组排名或同时输出名次,那么 ROW_NUMBER() 会更灵活。
最后再强调一次,真正麻烦的通常不是语法,而是定义本身。“第二高”是否允许并列、薪资字段是否含 NULL、查不到时返回空集还是 NULL,这些都应在动手写 SQL 之前先和业务方对齐。SQL 能不能写出来是一回事,写出来的结果是不是业务真正要的,是另一回事。















