



员工和经理都放在 employees 一张表里时,很多人第一反应是直接自连接,但结果常常不是少数据,就是越查越慢。要把这类层级关系查对,核心不在“会不会 JOIN”,而在于先判断记录是否允许上级为空、过滤条件会不会误伤结果,以及当前需求到底是固定两层还是要追整条汇报链。
下面就按最常见的几个问题展开:先说明为什么员工-经理查询应优先用 LEFT JOIN,再看索引和执行计划怎么影响性能,最后解释多层 JOIN 为什么很容易偏离“层级查询”的真实需求。
为什么员工-经理关系要优先用 LEFT JOIN
在员工表里,经理关系通常通过 manager_id 指向同表主键 id。这种设计下,CEO、部门负责人等顶层人员往往没有上级,因此 manager_id 会是 NULL。这也是员工-经理查询里 LEFT JOIN 不是“可选项”,而是默认正确解法的原因。
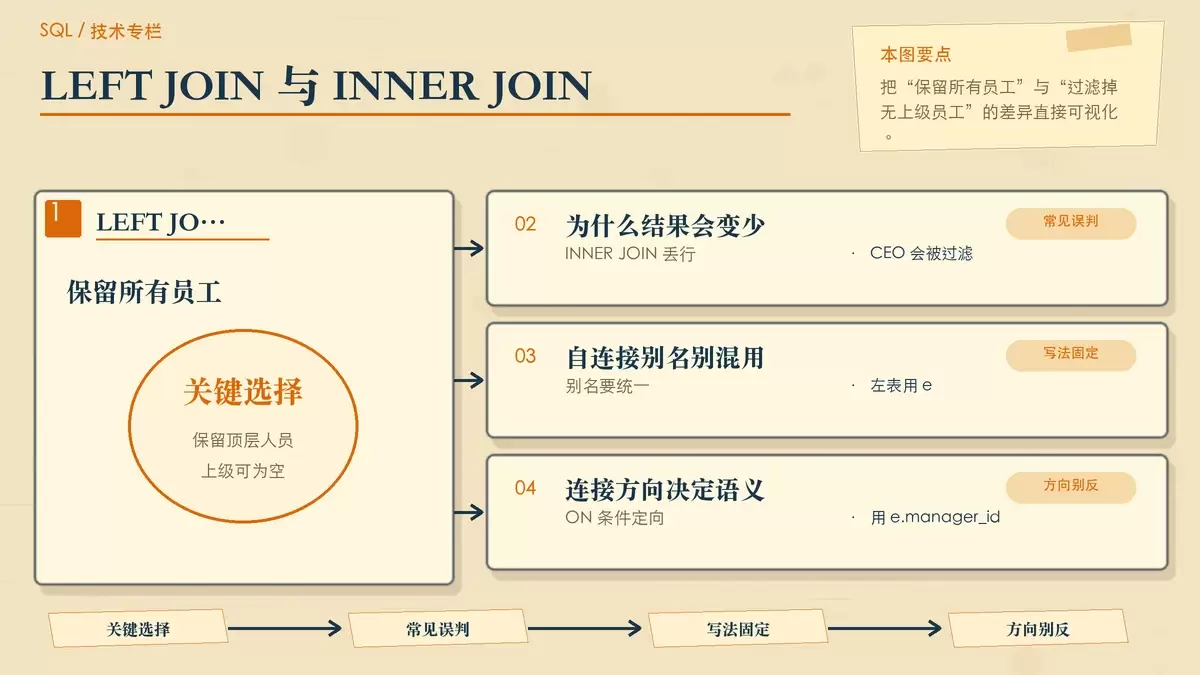
如果直接写成 INNER JOIN,所有 manager_id 为 NULL 的员工都会被过滤掉。表面上看像是数据没了,实际上只是连接逻辑把这些人排除了。
SELECT e.name AS employee, m.name AS manager
FROM employees e
LEFT JOIN employees m ON e.manager_id = m.id;
这条写法能保留所有员工记录。对于没有上级的人,manager 字段自然显示为 NULL。如果业务上希望结果更直观,可以再配合 COALESCE 做展示层替换:
SELECT e.name AS employee, COALESCE(m.name, 'Top') AS manager
FROM employees e
LEFT JOIN employees m ON e.manager_id = m.id;
这里要特别注意一个常见误区:如果后面又加了 WHERE m.name IS NOT NULL,那么这条 LEFT JOIN 实际上就退化成了 INNER JOIN,顶层员工还是会被排除。
另一个容易出错的点是别名和连接方向。既然左表表示员工、右表表示经理,就应该统一使用类似下面的命名:
- 左表固定为
e,表示 employee - 右表固定为
m,表示 manager ON条件固定写成e.manager_id = m.id
如果把条件写反成 e.id = m.manager_id,查询语义就从“这个员工的经理是谁”变成了“这个人是谁的经理”,结果会完全变样。很多自连接错误并不是 SQL 语法问题,而是把层级方向写反了。
manager_id 没有索引,性能问题会立刻放大
自连接在语义上不复杂,但性能很依赖索引。瓶颈通常不在 JOIN 关键字本身,而在数据库如何根据 manager_id 去同一张表里找到对应的经理记录。
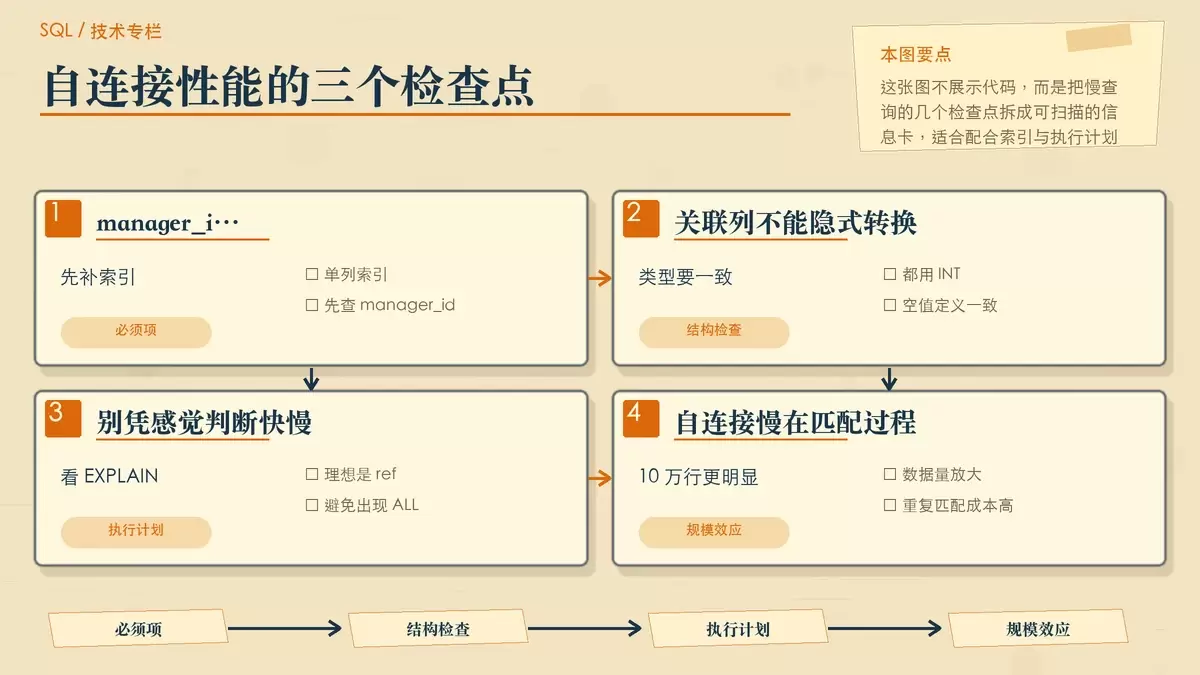
把员工表作为驱动表时,数据库需要对每一行员工记录去匹配一次上级。如果 manager_id 没有合适索引,匹配动作就可能退化成重复扫描。数据量小时问题不明显,到了 10 万员工级别,性能差距就会迅速被放大。
这类查询至少要确认三件事:
manager_id有单列索引manager_id与父级主键id的类型严格一致,例如都为INT NOT NULL- 父级侧的
id也确实能高效命中索引
执行前后最好用 EXPLAIN 看计划,而不是凭感觉判断快慢。对于这类按主键或外键匹配的自连接,type 列理想情况下应看到 ref 或 eq_ref,如果出现 ALL,通常说明在做全表扫描,索引设计或类型匹配需要回头检查。
这里还有一个容易被忽略的细节:很多人默认主键一定“天然高效”,但在联合主键或特殊聚簇设计下,id 是否以你预期的方式被使用,仍然值得核实。尤其在结构经过历史演化的表里,这一步不能省。
查多层汇报关系时,JOIN 堆叠为什么容易失真
查询一层经理关系时,自连接很直观;一旦想继续追“经理的经理”,很多人会继续堆叠 JOIN:
e1 LEFT JOIN e2 ON e1.manager_id = e2.id
LEFT JOIN e3 ON e2.manager_id = e3.id
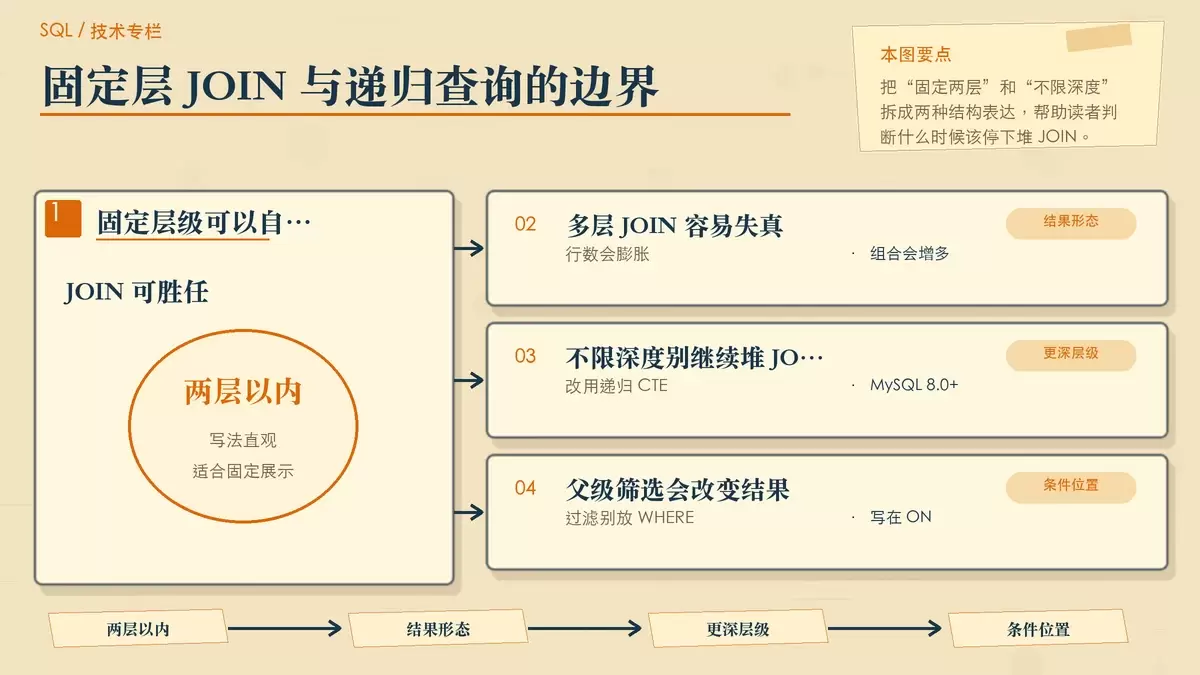
这种写法在固定层级、字段含义明确时可以用,但它并不等于真正的树形遍历。问题主要有两个。
中间层为空时,结果含义很容易被误读
当某一层的 manager_id 为 NULL 时,后续层级自然匹配不到记录。此时你看到的通常不是“结构完整但值为空”,而是从这一层开始没有更多上级结果。对于顶层或接近顶层的人员,这种结果很常见,但如果没有提前理解,很容易误判成数据异常。
层级一多,结果集可能迅速膨胀
多层 JOIN 展开的其实是层与层之间的组合结果,而不一定是你脑子里那种“一条汇报链”。例如一个总监管 10 个经理,每个经理再管 5 个员工,三层 JOIN 产出的就是 50 行组合数据,而不是一条可直接阅读的组织路径。
所以,超过两层之后,先别急着继续加别名。你需要先确认需求到底是:
- 固定展示 1 到 2 层上级信息
- 查询某个人的完整上级链
- 展开整个组织树
这三类问题,适合的 SQL 写法并不一样。
什么时候该换递归 CTE,过滤条件又该写在哪
如果目标是“查某人全部上级,直到最顶层”,继续堆叠固定数量的 JOIN 就不合适了。这时应该使用 WITH RECURSIVE。MySQL 8.0+、PostgreSQL 和 SQL Server 都支持这种递归查询方式,旧版 SQLite 则不支持。
递归 CTE 的优势不只是“能查更多层”,而是它更接近树形结构本身。你不需要预先写死三层、四层或五层,而是让查询沿着 manager_id 一直向上追溯,直到没有上级为止。
另外,在自连接场景里,筛选条件写在 ON 还是 WHERE,会直接改变结果集。比如你只想把“部门负责人”识别为上级:
AND m.is_dept_head = 1
这个条件应该写在 ON 里,而不是放进 WHERE。原因很简单:写进 WHERE 后,没有上级的员工会被一起过滤掉,LEFT JOIN 的保留效果也就没了。
可以把这条判断记成一句简单规则:凡是限制右表匹配资格、又不想丢掉左表主记录的条件,优先考虑写在 ON 中。
字段就在同表时,别把并列字段误当层级关系
还有一种常见误判,是把同表里的并列字段硬解释成层级链。比如 direct_manager 和 dept_head 都已经是 employees 表中的字段,它们只是同一行上的并列信息,并不代表必须通过自连接才能取出。
这种情况下,直接查询当前行即可:
SELECT name, direct_manager, dept_head
FROM employees
WHERE name = '张三';
只有在 dept_head 实际存放在另一张表,例如 departments 表里时,才需要再做 JOIN 或子查询:
(SELECT head_name FROM departments d WHERE d.id = e.dept_id)
这背后反映的是一个更基础的判断:自连接解决的是“同一张表中,一行通过外键关联到另一行”的问题;它不负责替你补出不存在的数据,也不等于任意组织架构问题都能靠堆 JOIN 解决。
如果查询只是拿固定字段,直接读列通常最简单;如果查询的是确定层级关系,用 LEFT JOIN;如果查询的是不定深度的树形路径,就该转向递归 CTE 或交给应用层做拼接。先把问题类型分清,再选 SQL 写法,结果和性能都会稳定得多。















