


数据库数据湖:Delta Lake与Iceberg格式

先理解:为什么数据湖需要表格式
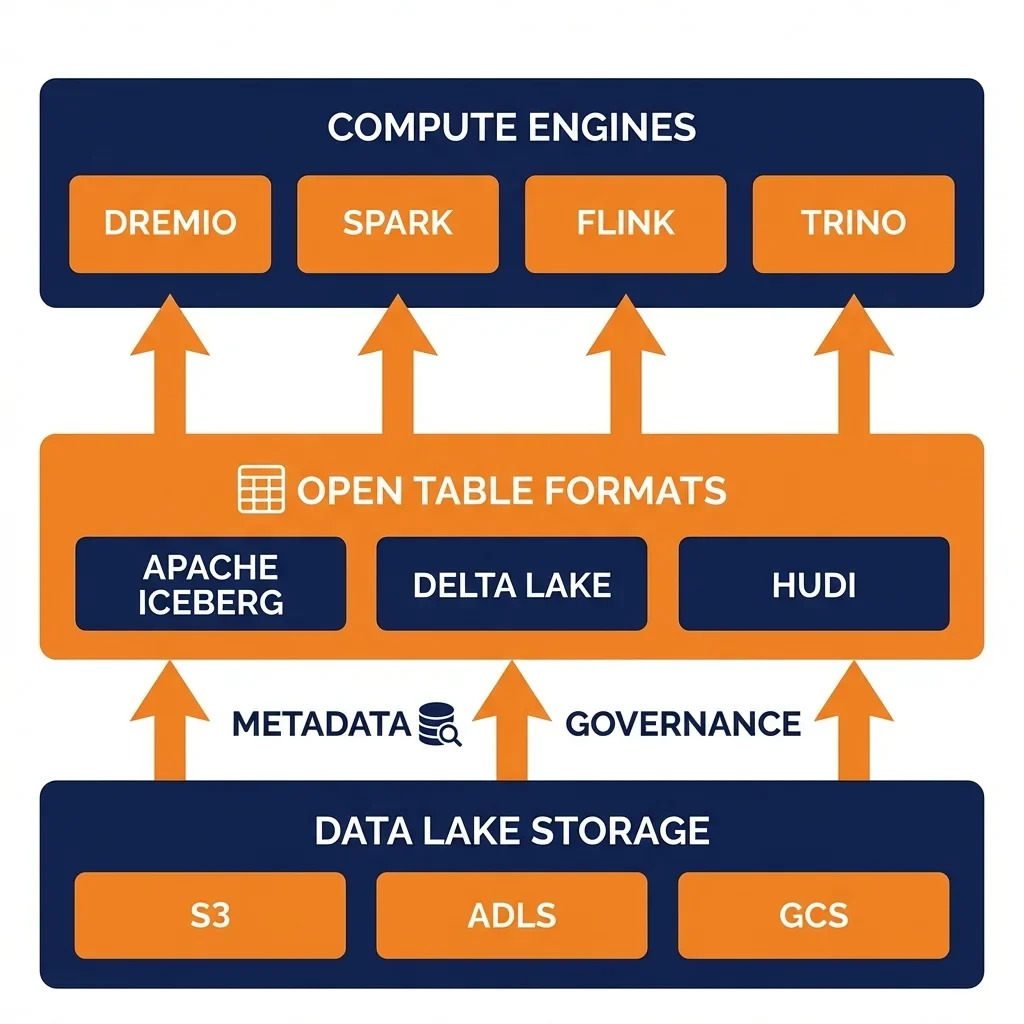
传统数据湖直接依赖对象存储存放 Parquet 或 CSV 文件,长期运行后极易陷入“文件堆积”困境。由于缺乏统一的元数据管理,计算引擎无法感知文件间的逻辑关系,导致重复读取、脏读或写入冲突频发。表格式(Table Format)的引入正是为了解决这一痛点。它在底层文件之上抽象出事务日志与元数据层,通过 ACID 事务保证读写一致性,利用 Schema 注册机制实现字段类型的强校验,并借助快照(Snapshot)机制记录每次变更。例如,当多个 Spark 任务同时向同一目录写入时,表格式会通过乐观并发控制或锁机制协调提交顺序,避免数据覆盖。同时,时间旅行能力允许用户通过版本号或时间戳回溯历史状态,彻底改变了过去“数据湖即文件仓库”的粗放管理模式,为后续 Delta Lake 与 Iceberg 的能力对比奠定基础。
核心对比:Delta Lake与Iceberg到底有什么不同
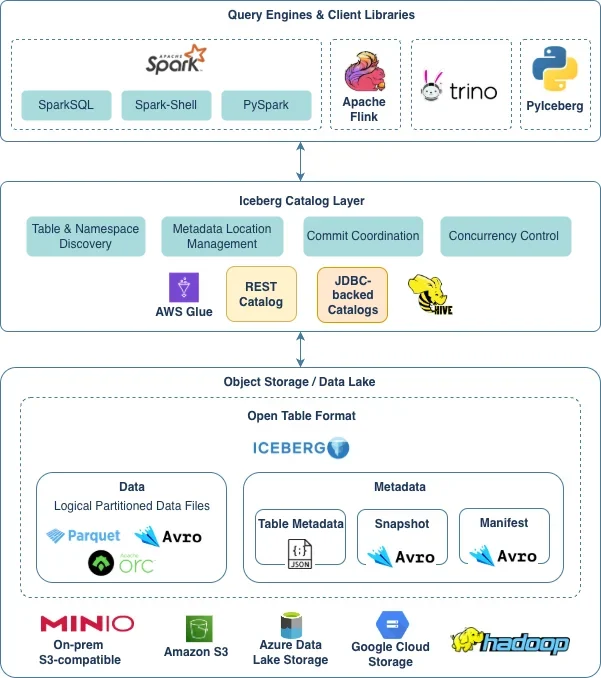
Delta Lake 与 Apache Iceberg 在核心目标上一致,但底层设计哲学存在显著差异。事务模型方面,Delta Lake 采用单一 _delta_log JSON 目录记录所有变更,结构直观且易于调试;Iceberg 则采用 Manifest List 与 Manifest File 的多级清单结构,将元数据与数据文件解耦,更适合超大规模表的快速扫描。Schema 演进上,Delta 默认支持追加列,但修改列名或类型需显式配置且可能触发全表重写;Iceberg 原生支持列重命名、类型安全转换及隐藏分区,元数据变更无需重写底层数据。分区管理层面,Delta 依赖物理目录结构,分区变更需重建表;Iceberg 采用逻辑分区规范,支持动态分区与分区演进。生态兼容性上,Delta 深度绑定 Databricks 与 Spark,而 Iceberg 由 Netflix 开源,对 Flink、Trino、Hive 等引擎的适配更为中立。两者均提供时间旅行与并发写入能力,但 Iceberg 在跨引擎互操作与元数据扩展性上更具优势,Delta 则在 Spark 生态内的开箱即用体验更优。
动手操作:创建、写入、查询与版本回溯
以 Spark SQL 为例,两种格式的实操流程高度相似但语法细节不同。创建 Delta 表使用 CREATE TABLE events USING DELTA LOCATION '/path/to/data',写入数据后通过 INSERT INTO 或 MERGE INTO 更新。查询历史版本可直接使用 SELECT * FROM events TIMESTAMP AS OF '2023-10-01 12:00:00' 或 VERSION AS OF 5。Iceberg 的建表语法为 CREATE TABLE events USING iceberg LOCATION '/path/to/data',写入逻辑一致,但时间旅行需依赖 CALL iceberg.system.rollback_to_snapshot('events', snapshot_id) 或查询时指定 OPTIONS('snapshot-id'='12345')。在 Schema 演进操作中,Delta 执行 ALTER TABLE events ADD COLUMN region STRING 后需配合 OPTIMIZE 整理文件;Iceberg 则直接执行 ALTER TABLE events ADD COLUMN region STRING,元数据层即时生效,底层 Parquet 文件保持兼容。实际操作中,建议通过 DESCRIBE HISTORY events(Delta)或 SELECT * FROM events.snapshots(Iceberg)验证版本链完整性,确保每次 DDL/DML 均正确落盘。
验证与避坑:一致性、兼容性和性能怎么检查
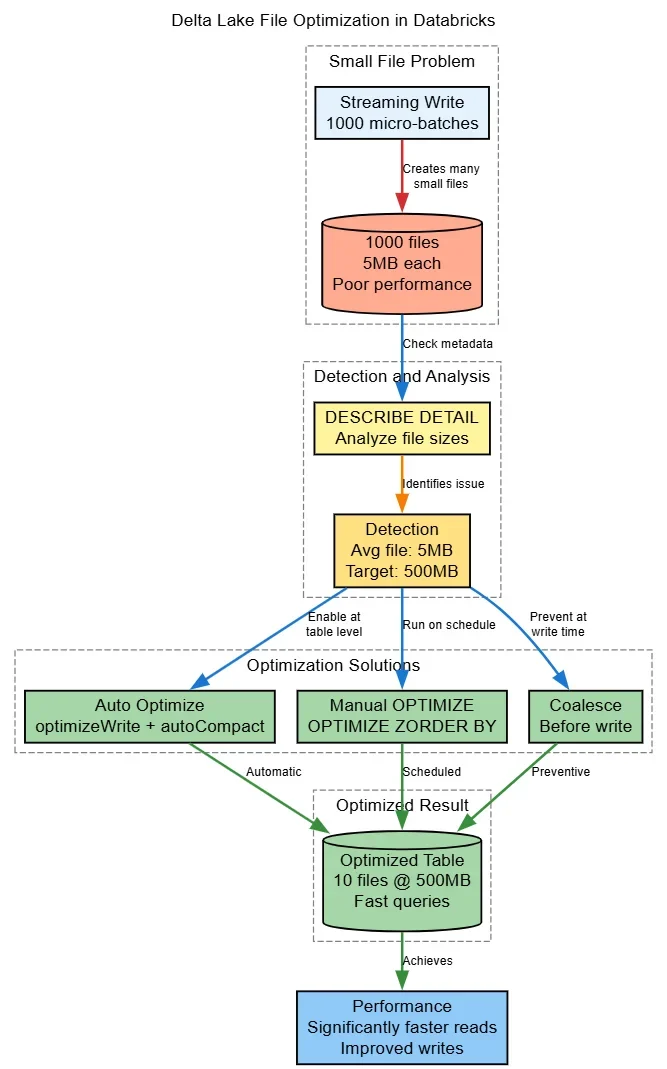
上线前必须进行系统性验证。一致性检查可通过并发写入测试:使用两个 Spark 作业同时执行 MERGE INTO,观察事务日志是否出现冲突回滚,并利用 VACUUM(Delta)或 expire_snapshots(Iceberg)清理过期文件后验证查询结果是否一致。Schema 变更验证需执行 DESCRIBE EXTENDED 对比元数据,并抽样读取新旧版本数据确认无类型截断。常见避坑点包括:小文件泛滥会严重拖慢查询,需定期执行 OPTIMIZE 或 rewrite_data_files 合并;分区设计不当(如按高基数字段分区)会导致元数据爆炸,建议采用分桶或动态分区;引擎版本不兼容是高频故障源,例如低版本 Spark 读取高版本 Iceberg 表可能因清单格式升级而报错,务必锁定统一运行时版本。此外,Delta 的 VACUUM 默认保留 7 天,若时间旅行需求超过此期限需调整 spark.databricks.delta.retentionDurationCheck.enabled 参数;Iceberg 则需合理配置快照保留策略,避免元数据目录膨胀。
最终选型:什么场景更适合Delta Lake或Iceberg
选型应基于现有技术栈与业务诉求构建决策框架。若团队重度依赖 Databricks 平台,且计算引擎以 Spark 为主,Delta Lake 是更优选择,其深度集成的 Auto Optimize、Z-Order 索引与 Unity Catalog 权限管控可大幅降低运维成本。若企业采用多云架构或混合计算引擎(如 Flink 实时写入、Trino 即席查询、Hive 离线批处理),Apache Iceberg 的中立性与标准化元数据设计能避免厂商锁定,其跨引擎一致性表现更为稳定。迁移成本方面,从 Hive 表迁移至 Iceberg 可通过 migrate 过程平滑过渡,而 Delta 迁移需重写底层数据。上线前必须确认的关键问题包括:现有对象存储是否支持强一致性(如 S3 或 OSS);团队是否具备元数据维护能力;实时流处理场景对延迟的容忍度;以及是否需长期保留历史快照。建议通过 POC 环境模拟核心业务负载,对比查询延迟、写入吞吐与元数据扫描开销,最终结合团队技术储备做出理性决策。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















