



做月度报表时,很多人会先想到“当前日期减 1 个月”,但自然月环比并不是滚动 30 天比较,而是把数据严格落在每个日历月里再做前后对照。下面按定义、MySQL 8.0+ 推荐方案、低版本兼容写法和常见坑点拆开说明,方便你判断该用哪种 SQL,以及结果是否真的可信。
自然月环比到底在算什么
自然月环比的公式是:
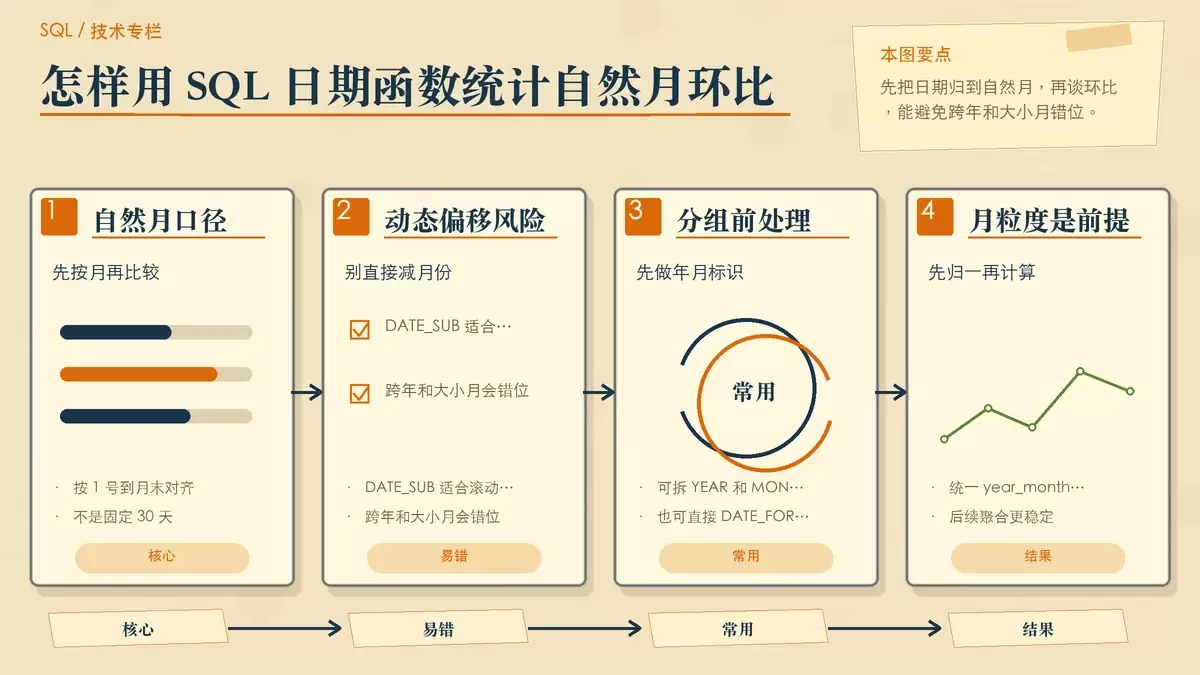
(本月数据 - 上月数据)/ 上月数据 × 100%这里最关键的不是公式,而是“自然月”三个字。它要求按日历月对齐,也就是每个月都以 1 号到月末为完整区间,而不是固定 30 天,也不是从“今天往前推一个月”的动态窗口。
这也是为什么不能直接把 DATE_SUB(NOW(), INTERVAL 1 MONTH) 当成自然月比较条件。动态偏移只适合做滚动分析,一旦碰到跨年、大小月,统计口径就会错位。例如 1 月和 12 月的对比,真正要比的是 1 月 1 日到 1 月 31 日,对上 12 月 1 日到 12 月 31 日,而不是围绕某一个具体日期往前推。
更稳妥的方式,是先把原始日期归到“年月”这一层,再按月聚合。常见写法有两类:
YEAR(date_col)
MONTH(date_col)
或者直接拼出年月标识:
CONCAT(YEAR(date_col), '-', LPAD(MONTH(date_col), 2, '0'))
DATE_FORMAT(date_col, '%Y-%m')
有了统一的 year_month 之后,再去做分组、聚合和上月值关联,逻辑会清楚很多,也更不容易在跨年时出错。
MySQL 8.0+:用窗口函数计算月度环比
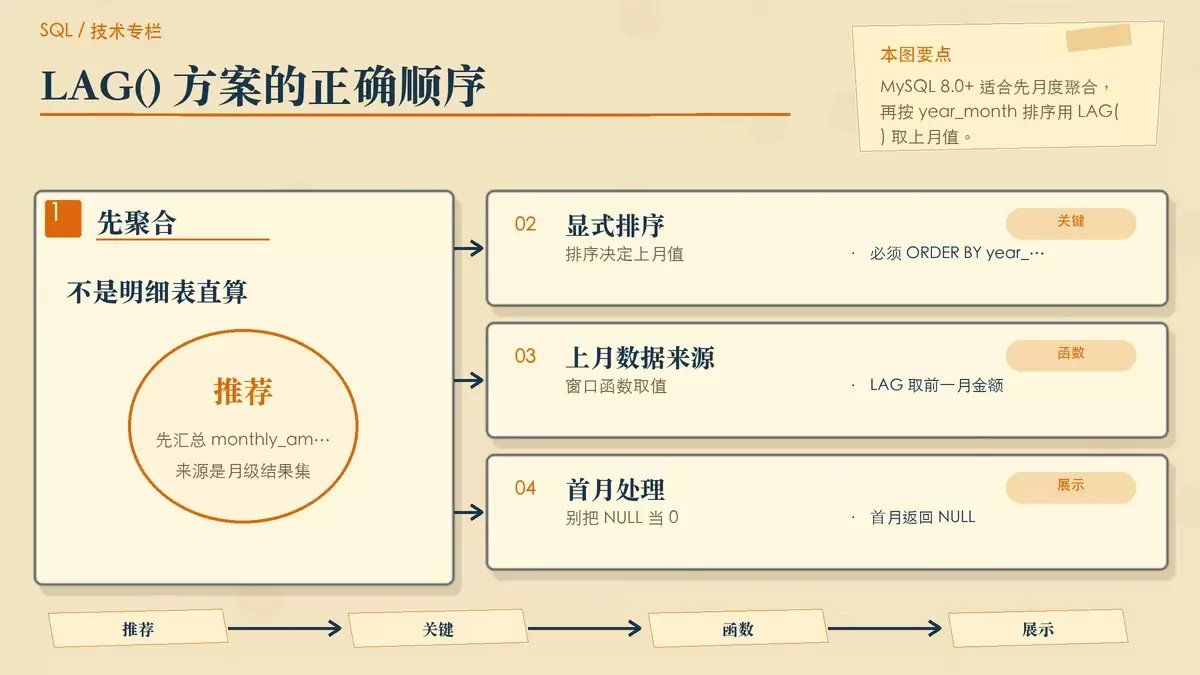
如果数据库是 MySQL 8.0+,优先用 LAG()。它的优势很直接:先得到每个月的聚合结果,再按年月排序,把上一行当成上月值取出来,写法清晰,后期维护也方便。
第一步,先按自然月聚合。比如统计每月订单总额:
SELECT DATE_FORMAT(order_time, '%Y-%m') AS year_month, SUM(amount) AS monthly_amount FROM orders WHERE order_time >= '2024-01-01' GROUP BY DATE_FORMAT(order_time, '%Y-%m')第二步,在聚合结果外层使用 LAG() 拉取上月数据,并计算环比:
SELECT year_month, monthly_amount, LAG(monthly_amount) OVER (ORDER BY year_month) AS last_month_amount, ROUND((monthly_amount - LAG(monthly_amount) OVER (ORDER BY year_month)) / LAG(monthly_amount) OVER (ORDER BY year_month) * 100, 2) AS mom_rate FROM (/* 上面的聚合子查询 */ ) t这套写法能成立,有两个前提必须满足。
先聚合,再做 LAG()
很多报表算错,不是 LAG() 有问题,而是直接在明细表上套窗口函数,没有先汇总到月粒度。这样一来,同一个月内的多条记录都会参与窗口计算,结果自然不是“月对月”。所以正确顺序一定是:先按 DATE_FORMAT(order_time, '%Y-%m') 聚合,再在月度结果集上取上月值。
必须显式排序
LAG() 是基于结果顺序取前一行,没写 ORDER BY year_month,上月值就可能乱序。原文里提到的常见错误,本质上都是这个问题:排序缺失,或者排序字段不是统一格式的年月字段。
另外,首月没有上月可比数据,LAG() 返回 NULL。这种情况下,环比结果也会是 NULL。如果报表不需要展示首月,可以显式过滤:
WHERE last_month_amount IS NOT NULL这样做的好处是语义明确,前端也不容易误把“无可比项”当成正常业务数值。
MySQL 5.7 及以下:用自连接补上月数据
如果系统还停留在 MySQL 5.7 或更早版本,没有窗口函数,就只能走“先聚合、再自连接”的路线。思路并不复杂:当前月结果表和自身做一次关联,把能对应到上月的那一行连出来。
问题主要出在“怎么准确构造上月年月”。直接硬算年和月会非常绕,例如下面这种思路虽然可行,但可读性很差:
STR_TO_DATE(CONCAT(YEAR(date_col)-IF(MONTH(date_col)=1,1,0), '-', LPAD(MONTH(date_col)-1+IF(MONTH(date_col)=1,12,0), 2, '0'), '-01'), '%Y-%m-%d')实际更推荐先把 year_month 还原成当月 1 号,再减去 1 个月,最后格式化回 %Y-%m。对应写法是:
DATE_FORMAT(DATE_SUB(STR_TO_DATE(CONCAT(year_month, '-01'), '%Y-%m-%d'), INTERVAL 1 MONTH), '%Y-%m')这样处理的好处是跨年场景会自动对齐,比如从 2024-01 推回 2023-12,不需要手工拆分 1 月和其他月份分别判断。
在实现上,可以按下面这个结构理解:
- 先得到聚合结果表,记为
t_curr,包含year_month和amount - 再把它左连接到自身的上一月结果表
t_prev - 关联条件使用年月减一月后的结果进行匹配
原始关联逻辑可写为:
t_curr.year_month = DATE_FORMAT(DATE_SUB(STR_TO_DATE(CONCAT(t_prev.year_month, '-01'), '%Y-%m-%d'), INTERVAL 1 MONTH), '%Y-%m')如果首月没有上月数据,还要避免它参与后续环比运算。原文建议补上:
AND t_prev.year_month IS NOT NULL这类方案常见于老系统无法升级,或者同一套报表要兼容多版本 MySQL 的场景。缺点也很明显:大数据量下,自连接通常比窗口函数更慢。因此如果报表长期使用,最好在 year_month 字段上建立索引,减少连接和分组的开销。
写对 SQL 之后,还要盯住这些边界问题
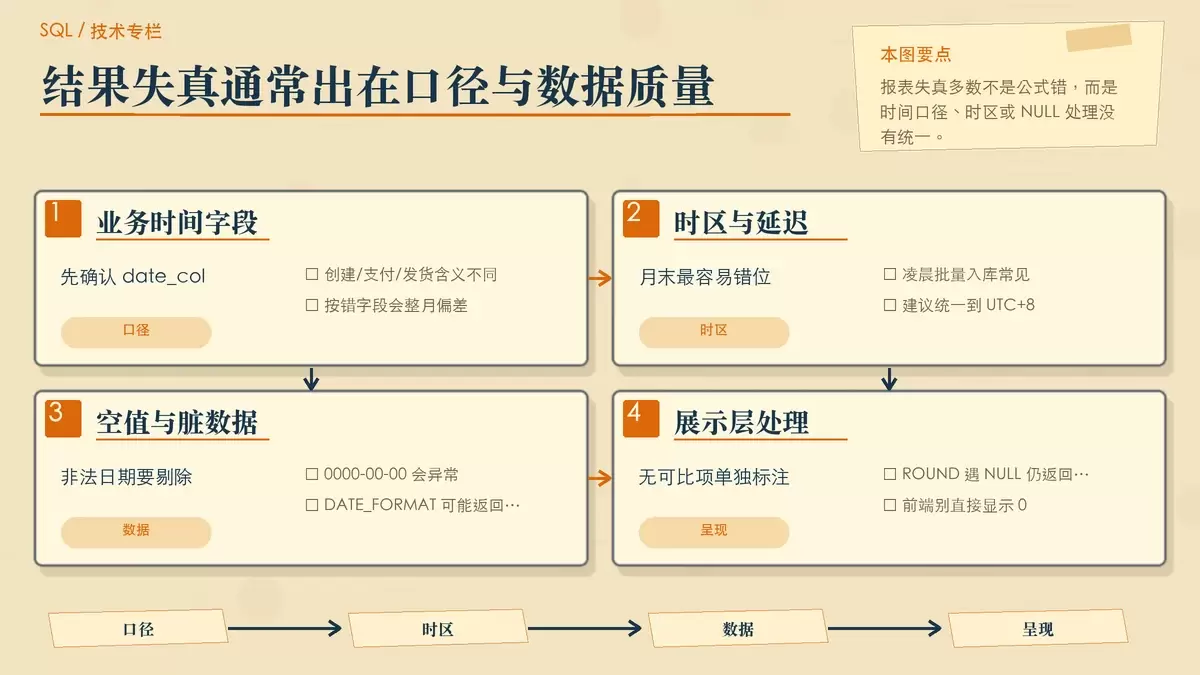
自然月环比最容易出问题的地方,往往不是 SQL 语法,而是时间字段的业务口径不一致。看上去都是某个时间列,实际含义可能完全不同:订单创建时间、支付时间、发货时间、结算时间,各自代表的业务阶段并不一样。你按哪个字段分组,最后得到的“月度变化”就对应哪个业务动作。
所以在动手写 SQL 前,至少要确认三件事:
时间字段到底代表什么
例如订单表里的 order_time 是创建时间,但财务月报也许按支付时间或发货时间结算。如果这个口径没先对齐,后面的环比公式再正确,也只是把错误口径算得很工整。
时区和入库延迟有没有统一
一些数据会在凌晨批量写入,或者由跨时区系统采集。如果没有统一时区,比如没有先归一到 UTC+8,那么月末最后几个小时的数据可能会落进下个月,导致 DATE_FORMAT(order_time, '%Y-%m') 的分组结果失真。
空值、非法日期和除零要单独处理
像 '0000-00-00' 这样的非法日期,可能让 DATE_FORMAT 返回 NULL,最终整组数据都进不到正常月份里。再比如 ROUND(..., 2) 在除零或 NULL 的情况下会返回 NULL,前端展示时不能直接把它当成 0,否则“没有上月数据”和“本月增长 0%”就会被混成一类。
换句话说,报表里看到 NULL 时,不一定是 SQL 写错了,也可能是在提醒你:这条记录没有可比的上月基准,或者源数据本身就不满足计算条件。把这类情况在接口层或前端层单独标注出来,通常比强行补 0 更符合真实业务含义。
该选哪种方案,取决于数据库版本和报表要求
如果环境是 MySQL 8.0+,优先使用 LAG(),可读性和维护性都更好,也更适合后续继续扩展同比、累计值等分析指标。前提是先完成月度聚合,并保证 ORDER BY year_month 明确存在。
如果还需要兼容 MySQL 5.7 及以下版本,就采用“年月聚合 + 自连接”的方案,把 year_month 转成当月 1 号后再 DATE_SUB 一个自然月,避免手工处理跨年月份。无论哪种写法,最终结果是否可信,都要回到三个检查点:时间字段业务口径是否统一、时区是否一致、空值与 NULL 是否被正确解释。
只要这几个点没跑偏,自然月环比的 SQL 本身并不复杂;真正有价值的是,先把“按什么时间统计、怎么对齐上月、哪些情况不能算”说明白,再落到具体语句上。















