



大文件下载在 Web 服务里并不罕见,日志归档、数据库备份、CSV 导出、镜像分发都可能很快把文件体积推到 GB 级。一旦还沿用“先把文件完整读进内存,再一次性返回”的写法,接口响应和机器内存都会先吃到压力。本文就从 Gin 的流式响应入手,拆开看它为什么能缓解内存瓶颈、核心代码该怎么写,以及上线前还要补哪些错误处理和性能细节,帮助你判断这套方案是否适合自己的下载场景。
为什么大文件下载要改成流式响应
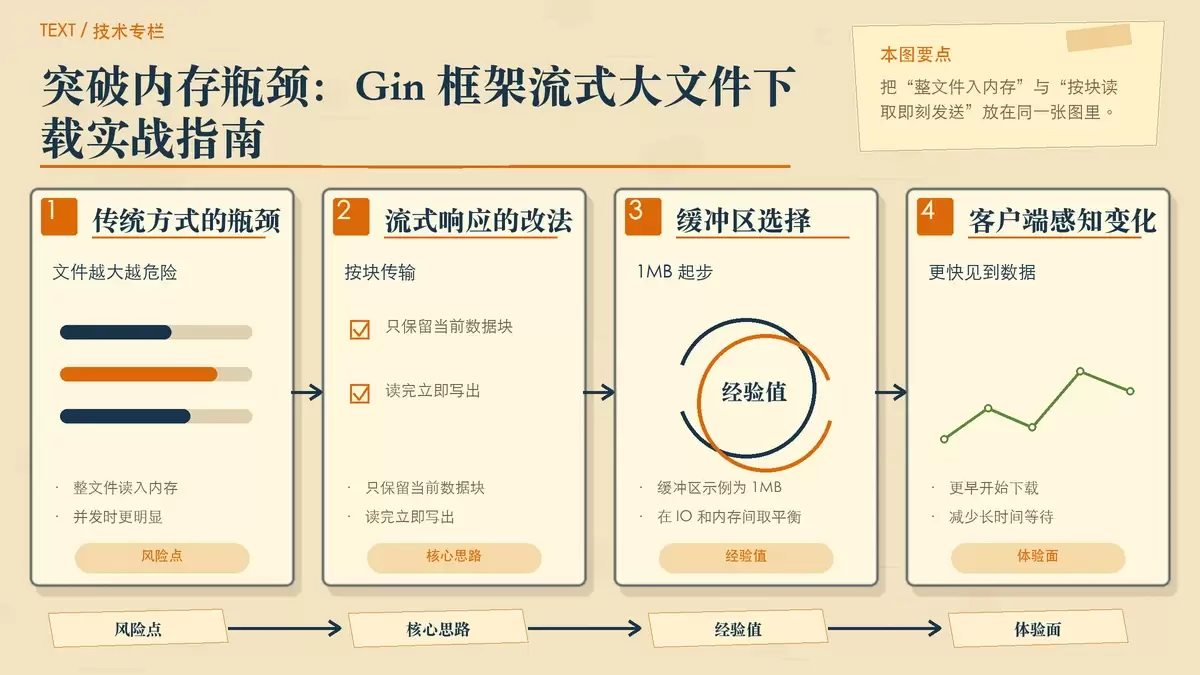
常规下载方式对小文件很直接:服务端把文件读入内存,再写给客户端。这种方式在几十 KB、几 MB 的文件上问题不大,但文件一旦达到 GB 级,代价会迅速放大。
最直接的问题是,服务器需要把整个文件加载到内存。这会带来两类后果:
- 内存占用过高:并发请求一多,很容易把服务推到 OOM 边缘。
- 响应启动慢:必须先读完大部分甚至全部内容,客户端才开始接收数据。
流式下载的思路正好相反:不等文件整体准备完,而是把响应拆成多个小块,边读边发。这样服务端不需要一次性持有完整文件内容,只保留当前这一个缓冲区即可,内存压力会明显下降。
从使用效果看,流式响应解决的不只是“能不能传完”这个问题,还改善了两个实际体验:
- 客户端可以更早开始接收数据,而不是长时间等待。
- 服务端面对大文件和长连接时,稳定性通常比一次性返回更好。
Gin 流式下载的核心实现
在 Gin 里,实现一个基础版流式下载并不复杂。关键点只有三个:打开文件、设置下载响应头、按固定大小循环读取并写回客户端。
func StreamDownload(c *gin.Context) {
    filePath := "path/to/large/file.zip"
    file, err := os.Open(filePath)
    if err != nil {
        c.AbortWithError(404, err)
        return
    }
    defer file.Close()

    c.Header("Content-Type", "application/octet-stream")
    c.Header("Content-Disposition", "attachment; filename=download.zip")

    buffer := make([]byte, 1024*1024) // 1MB缓冲区
    for {
        n, err := file.Read(buffer)
        if n > 0 {
            c.Writer.Write(buffer[:n])
            c.Writer.Flush()
        }
        if err == io.EOF {
            break
        }
    }
}
这段代码的核心价值,不在于“把文件发出去”,而在于它把单次内存使用控制在了缓冲区大小附近。示例里使用的是 1024*1024,也就是 1MB 缓冲区,意味着服务端每次只处理 1MB 左右的数据,而不是一次读完整个压缩包。
这里有几个实现细节值得单独注意:
响应头决定了客户端如何处理下载
Content-Type 设置为 application/octet-stream,表示这是一个通用二进制流;Content-Disposition 设置为附件下载,并指定文件名 download.zip,浏览器通常会直接触发保存而不是尝试内联打开。
Flush 的作用是尽快把当前块送出去
在每次 Write 之后调用 c.Writer.Flush(),可以让已写入的数据尽快发送给客户端,而不是继续积压在缓冲层里。对长时间下载任务来说,这一步能更稳定地体现“边读边传”的效果。
这种方式更适合大文件,而不是所有文件
如果你处理的是体积很小、需要一次性计算长度或签名的文件,流式下载不一定比普通返回更有优势。它真正适合的是大文件、生成耗时长、或者服务端不希望为单个响应占用太多内存的场景。
分块传输编码怎么工作
流式下载背后的关键机制,是 HTTP/1.1 的分块传输编码,也就是 Transfer-Encoding: chunked。它的意义在于:服务端不必预先知道整个响应体到底有多大,也能一块一块地持续发送内容。
// 设置分块传输头
c.Header("Transfer-Encoding", "chunked")
和传统下载相比,分块传输有个很实际的差异:通常不需要提前设置 Content-Length。这对两类场景尤其有用:
- 文件很大,希望直接顺序读取并立即发送。
- 内容动态生成,例如导出 CSV、拼接报表,服务端在开始响应时还拿不到最终总长度。
也正因为如此,流式响应不仅能服务静态文件,也很适合“边查边导出”的业务接口。与其先把完整导出结果拼到内存或临时文件里,再统一返回,不如直接把每一批结果编码后持续写到响应流中。
不只下载文件:数据库结果集也能流式导出
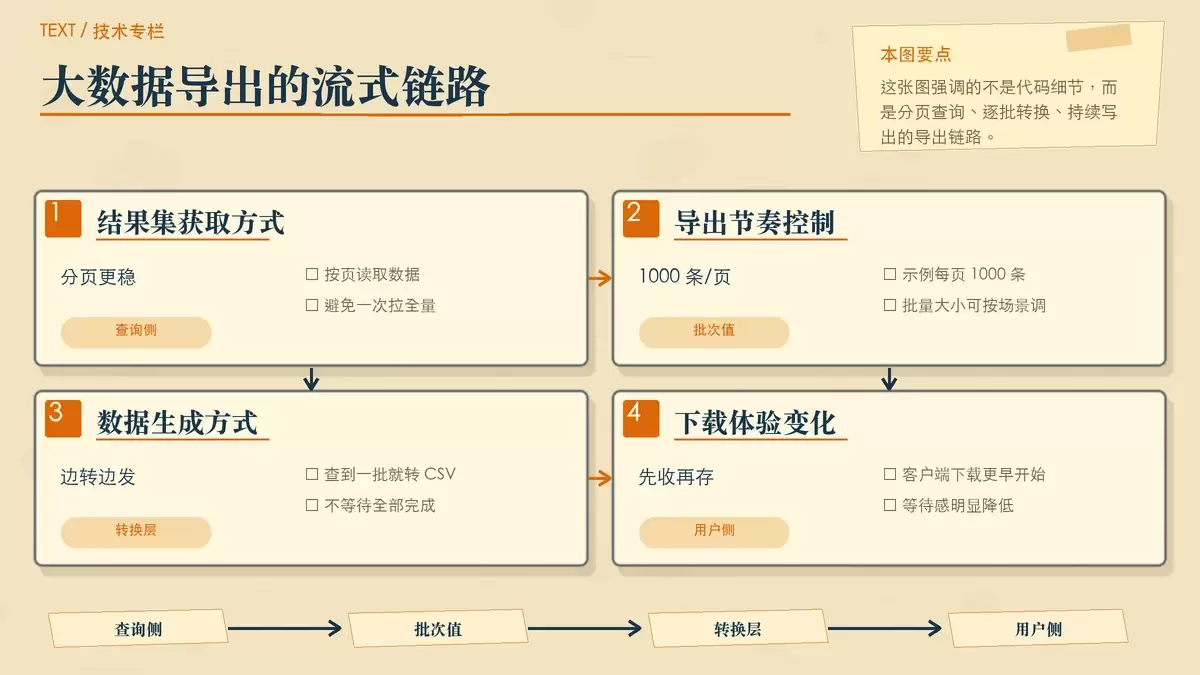
很多业务里真正麻烦的,不是磁盘上的现成大文件,而是动态导出。比如一次导出几十万、几百万条记录到 CSV,如果先把所有结果集堆在内存里,再统一转换、统一输出,服务端压力往往比下载静态文件还高。
Gin 的 c.Stream 机制比较适合这一类任务:
func StreamDataExport(c *gin.Context) {
    c.Header("Transfer-Encoding", "chunked")
    c.Header("Content-Disposition", "attachment;filename=export.csv")

    c.Stream(func(w io.Writer) bool {
        for page := 1; page <= totalPages; page++ {
            data := queryDataByPage(db, page, 1000)
            csvData := convertToCSV(data)
            w.Write([]byte(csvData))
        }
        return false // 结束流
    })
}
这段实现体现的是一种分页导出思路:每次按页查询,比如每页 1000 条,查到一批就转换成 CSV 并立即写出。这样做有几个现实收益:
- 数据库查询压力更均匀,不需要一次拉全量数据。
- 应用层内存更稳定,不必长期持有超大结果集。
- 客户端下载会更早开始,等待感更弱。
如果你的导出接口经常因为记录量过大而超时、内存飙升,或者生成阶段过长导致用户一直看不到下载开始,这种分页查询加流式输出的组合通常比“先生成完整文件,再开始下载”更合适。
错误处理、连接中断与优化重点
流式下载真正落地时,代码能跑通只是第一步。只要下载时间够长,客户端取消、网络抖动、代理层超时、写入失败这些问题迟早会遇到,因此错误处理和连接管理必须补齐。
客户端中断下载时要及时终止写入
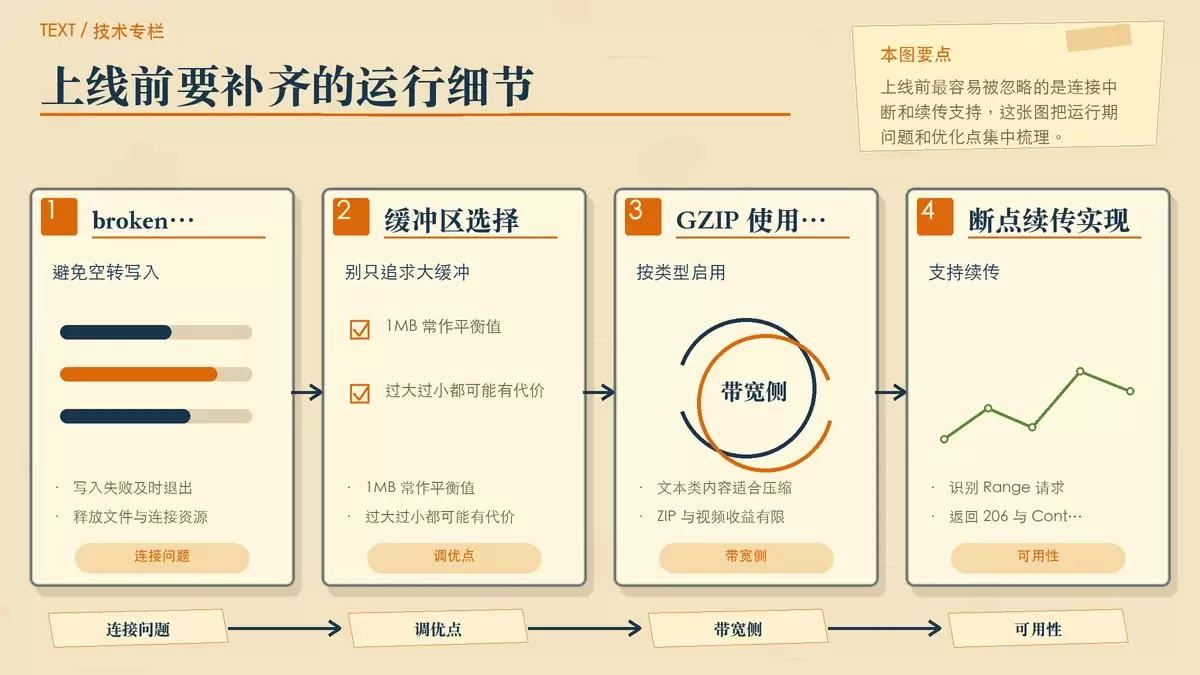
最典型的情况是用户手动取消下载,或者连接中途断开。这时服务端继续往连接里写数据,就可能遇到 broken pipe 之类的错误。
p := make([]byte, 1024)
for {
    n, err := f.Read(p)
    if n > 0 {
        if _, err := w.Write(p[:n]); err != nil {
            break // 处理broken pipe错误
        }
    }
    if err == io.EOF {
        break
    }
}
这类错误不该被当成普通业务异常无限重试,而应该尽快结束当前请求,释放文件句柄和相关资源。否则在高并发下载环境下,失效连接会白白消耗服务端 IO 和 CPU。
缓冲区大小通常以 1MB 作为起点
缓冲区不是越大越好,也不是越小越省资源。原文给出的经验值是1MB 是个平衡点:过小会导致读写次数增多,放大 IO 开销;过大则会抬高单请求内存占用。实际项目里可以根据磁盘性能、网络带宽和并发量做压测后再调整。
文本类内容可以配合 GZIP 压缩
如果下载的是文本类文件,例如 CSV、日志、JSON 导出结果,启用压缩往往能节省带宽。
import "github.com/gin-contrib/gzip"

func main() {
    router := gin.Default()
    router.Use(gzip.Gzip(gzip.DefaultCompression))
}
不过这条优化更适合可压缩内容。对已经压缩过的 ZIP、视频、镜像文件,再做 GZIP 往往收益有限,甚至会增加额外 CPU 开销。
需要断点续传时要处理 Range 请求
如果业务是镜像分发、媒体下载或超大文件传输,断点续传会直接影响可用性。实现上通常要识别客户端的 Range 请求头,并返回部分内容状态。
rangeHeader := c.GetHeader("Range")
if rangeHeader != "" {
    // 解析Range头,实现断点续传逻辑
    c.Header("Content-Range", "bytes ...")
    c.Status(206) // 部分内容
}
这里的关键不只是读取 Range,还包括正确计算字节区间、返回 206 状态码,以及保证文件偏移读取逻辑准确。对于经常被中断或需要重复续传的下载接口,这是从“能下载”升级到“好用”的关键一步。
哪些场景最适合用这套方案
流式下载并不是只为少数极端场景准备,它在很多常见后端任务里都很实用。典型场景包括:
- 大型日志文件下载:系统生成的 GB 级日志文件,适合按块读取,避免内存溢出。
- 数据库备份文件:备份体积大、生成时间长,边生成边下载更稳妥。
- 视频或镜像文件:这类文件本身体积大,往往还需要断点续传支持。
- 大数据导出:从数据库批量导出 CSV,适合分页查询后流式写出。
如果你的接口已经出现以下信号,基本就该考虑流式方案了:
- 下载接口一跑,应用内存明显抬升。
- 文件越大,客户端开始下载前等待越久。
- 导出类任务容易超时,或者需要先生成临时文件。
- 并发下载稍高时,服务稳定性开始下降。
从工程角度看,Gin 的流式响应解决的是一个很具体的问题:如何在不把整个文件或整个结果集压进内存的前提下,稳定地完成大体积数据传输。它带来的收益主要体现在三点:
- 内存效率更高:单请求占用更可控,能更稳地面对大文件。
- 传输更及时:客户端能边接收边处理,而不是长时间空等。
- 系统稳定性更好:减少大响应对服务整体资源的冲击。
对于 Gin 开发者来说,这不是一个只在特殊项目里才会用到的技巧,而是处理大文件下载、动态导出、长时间响应时非常值得掌握的基础能力。只要把分块传输、写入刷新、连接中断处理和必要的续传支持补完整,GB 级文件传输就不再只能靠堆内存硬扛。















