


Python jieba库中文分词原理与三种模式实战详解

本文详解Python jieba库的中文分词原理,介绍基于词库与动态规划的算法机制。重点解析精确模式、全模式及搜索引擎模式的区别与适用场景,并通过jieba.lcut等常用函数展示代码实操,涵盖安装、自定义新词及不同模式下的分词效果对比。
一、jieba库概述
jieba是一款高效的中文分词第三方库。由于中文文本中汉字连续书写且无空格分隔,需通过特定算法切分出独立的词语,这一过程称为分词。jieba库正是为解决这一需求而设计,能够准确完成中文文本的词组提取。
二、jieba分词机制
jieba的分词核心在于利用内置的中文词库,将待处理文本与词库进行比对。它结合图结构构建与动态规划算法,计算出概率最高的词语组合。此外,该库支持用户添加自定义词汇,以优化特定领域的分词效果。
三、jieba支持的三种分词模式
1. 精确模式
旨在将句子切分为最精确的词组,不产生冗余,适用于大多数文本分析场景。
2. 全模式
扫描句子中所有可能构成词语的组合,输出速度极快,但无法消除语义歧义,可能产生大量冗余词。
3. 搜索引擎模式
在精确模式的基础上,对长词进行二次切分,从而提高召回率,特别适合搜索引擎等需要高召回率的场景。
注意:对于中文分词,使用jieba库仅需一行代码即可实现;英文文本因单词间有空格分隔,通常不涉及分词问题。
四、jieba常用函数说明
| 函数 | 描述 |
|---|---|
| jieba.lcut(s) | 精确模式,返回一个列表值 |
| jieba.lcut(s,cut_all=True) | 全模式,返回一个列表值 |
| jieba.lcut_for_search(s) | 搜索引擎模式,返回一个列表值 |
| jieba.add_word(w) | 向分词词典中增加新词w |
五、jieba代码实操
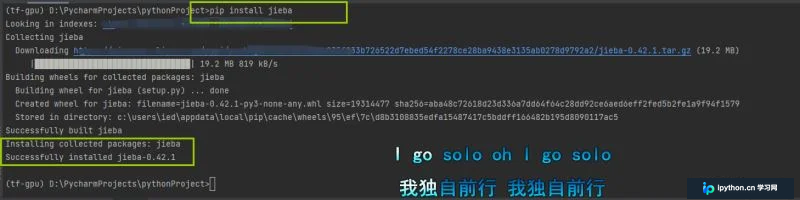
首先需安装jieba库,命令如下: pip install jieba
练习一(jieba.lcut)精确模式
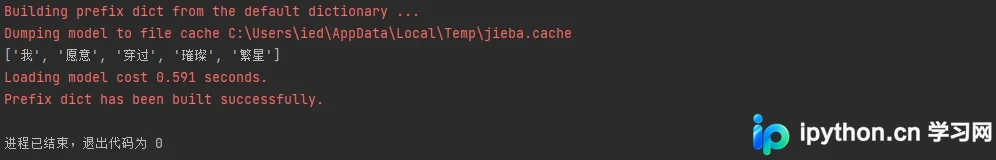
jieba.lcut(s)是最常用的分词函数,采用精确模式,将字符串分割为等量的中文词组列表。
import jieba

ls = jieba.lcut("我愿意穿过璀璨繁星")
print(ls)
练习二(jieba.lcut(s,cut_all=True))全模式
jieba.lcut(s,cut_all=True)用于全模式,列出字符串所有可能的分词结果,冗余度最大。
import jieba
ls = jieba.lcut("人面不知何处去,桃花依旧笑春风", cut_all=True)
print(ls)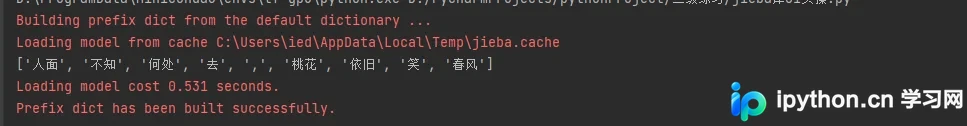
练习三(jieba.lcut_for_search)搜索引擎模式
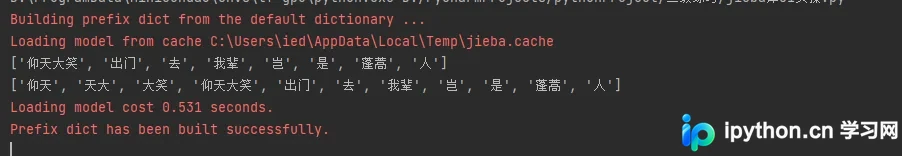
jieba.lcut_for_search首先执行精确模式,随后对结果中的长词进行进一步切分,以获取最终的分词列表。
import jieba
ls1 = jieba.lcut("仰天大笑出门去我辈岂是蓬蒿人")
ls = jieba.lcut_for_search("仰天大笑出门去我辈岂是蓬蒿人")
print(ls1)
print(ls)
练习四(jieba.add_word(w))增加新词
import jieba

ls = jieba.lcut_for_search("仰天大笑出门去我辈岂是蓬蒿人")
print(ls)
jieba.add_word("蓬蒿人")
ls1 = jieba.lcut("仰天大笑出门去我辈岂是蓬蒿人")
print(ls1)
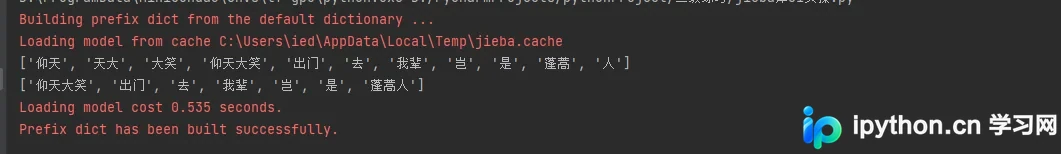
小结:由于精确模式不产生冗余结果,因此在实际应用中最为常用。
总结
本文介绍了Python第三方库jieba及其在中文分词中的应用。如需了解更多Python jieba库与中文分词相关内容,请搜索本站过往文章或继续浏览后续文章,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















