


Python使用pynlpir进行中文分词并保留段落结构

发布时间:2026-10-11 |
5人浏览过
本文介绍如何在Python环境中安装与配置pynlpir模块,演示基础单句分词及按行读取、标注后批量处理本地TXT文件的完整流程。通过参数调整保留原始段落换行结构,导出含词性信息的分析结果,并补充自定义词典导入、跨平台路径处理等高频注意事项。
一、环境安装与授权更新
pynlpir是基于NLPIR工具封装的Python接口,支持高效的中文分词与词性标注。使用前需先通过pip安装依赖,并完成授权文件初始化。
pip install pynlpir
pynlpir update
注意:该工具的授权文件需要定期更新以维持服务可用性。首次运行或长期未使用后,请务必执行上述更新命令,否则可能出现调用失败。若处于网络受限环境,建议前往官方仓库手动下载授权文件后替换至本地缓存目录。
二、实操步骤:从基础分词到批量保留段落
第1步:执行基础分词测试
初始化分词库后,可通过open()加载引擎,调用segment()传入目标字符串获取分词列表。返回结果默认包含分词文本及其对应的词性标签。
import pynlpir
pynlpir.open()
s = '欢迎科研人员、技术工程师、企事业单位与个人参与NLPIR平台的建设工作。'
segs = pynlpir.segment(s)
for seg in segs:
    print(seg)
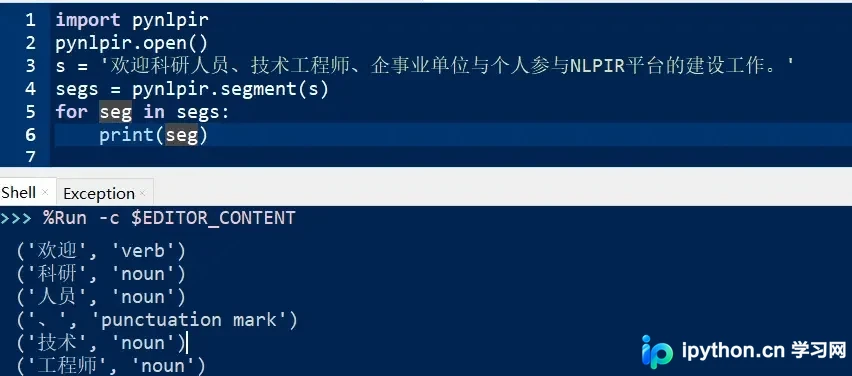
第2步:批量读取文本并保留段落结构
在实际数据分析场景中,通常需要遍历当前目录下的全部TXT文件,逐段读取并写入结构化结果。以下代码实现了自动识别目录内文本、按行分词标注、拼接词性与词面信息,并利用换行符严格对齐原文段落的功能。
import pynlpir
import os

# 初始化分词库
pynlpir.open()

# 筛选当前目录下的所有TXT文件
txts = [file for file in os.listdir(".") if file.endswith(".txt")]

for txt in txts:
    with open(txt, "r", encoding="utf-8") as f:
        lines = [line.strip() for line in f.readlines()]
        for line in lines:
            # pos_tagging开启词性标注,pos_english输出英文标签
            segments = pynlpir.segment(line, pos_tagging=True, pos_english=True)
            with open("segged_" + os.path.basename(txt), "a+", encoding="utf-8") as fi:
                for segment in segments:
                    try:
                        # 格式化为 词_词性| ,末尾补段落换行符
                        fi.write(str(segment[0]) + "_" + str(segment[1]) + "|")
                    except Exception as e:
                        print(e, segment)
                fi.write("\n")

# 完成后释放资源
pynlpir.close()
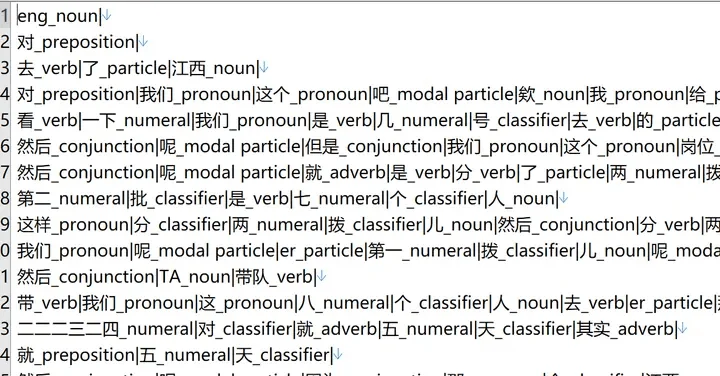
三、关键注意事项与常见报错排查
尽管该模块运行速度较快,但在工程化落地时需注意以下边界条件:
- 自定义词典导入:若需加载用户自建的词典扩展库,源文件必须保存为ANSI编码。若直接沿用UTF-8,初始化时极易抛出编码解析异常。
- 批量路径避坑:脚本在扫描
os.listdir()及读写文件时,强烈建议避免使用包含中文字符的路径。部分底层C扩展或系统API在解析非ASCII字符时可能中断,导致批量任务静默失败。 - Licence跨平台更新:Linux环境下若网络波动导致在线更新中断,推荐先在GitHub Releases页面完整下载授权包,再通过SCP或FTP上传至服务器指定目录,可大幅降低运行阻断风险。
四、总结
借助pynlpir提供的segment()接口配合Python原生IO流,能够以较低门槛实现中文文本的高精度切分与段落级数据清洗。掌握正确的编码规范与路径管理规范,即可顺畅对接后续的停用词过滤、TF-IDF计算或Embedding训练流水线。以上就是Python使用pynlpir进行中文分词并保留段落结构的详细内容,更多关于pynlpir中文分词与自然语言处理实战的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















