


Python 爬取学信网登录页面的实现方法

发布时间:2026-10-13 |
6人浏览过
本文以学信网为例,详细介绍如何使用 Python 模拟登录并爬取个人信息。通过 Firefox 开发者工具分析网络请求,定位 POST 提交链接及表单参数,利用 requests 库和 BeautifulSoup 构造会话与提交数据,最终实现自动登录并解析页面表格内容,为类似网站的爬虫开发提供参考。
Python 爬取学信网登录页面实战
本文以学信网平台为例,演示如何爬取需要登录的个人信息页面。
若界面显示不清晰或操作存在困难,请参考后续步骤。
具体操作流程如下:
网络请求分析与表单构造
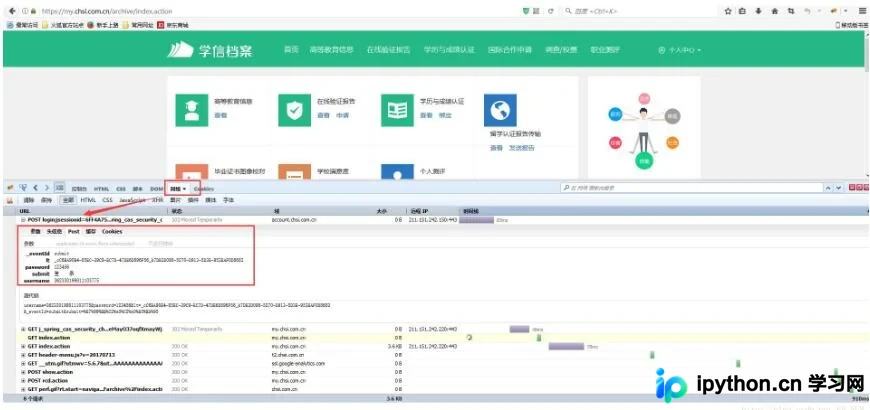
首先以 Firefox 浏览器为例,打开目标登录网页,按下 F12 键进入开发者模式(也可通过鼠标右键点击页面选择“检查元素”)。接着切换到“网络”选项卡,在页面完成登录操作后,观察网络请求列表,找到一个 POST 类型的提交链接并点击查看详情。重点分析该 POST 请求中包含的数据,这些信息即为后续爬虫代码中需要构造的表单字段。
import requests
from bs4 import BeautifulSoup
from http import cookies
import urllib
import http.cookiejar

headers = {
  'User-Agent':'Mozilla/5.0 (Windows NT 10.0; WOW64; rv:54.0) Gecko/20100101 Firefox/54.0',
  'Referer':'https://account.chsi.com.cn/passport/login?service=https://my.chsi.com.cn/archive/j_spring_cas_security_check',
}

session = requests.Session()
session.headers.update(headers)
username = 'xxx'
password = 'xxx'
url = 'https://account.chsi.com.cn/passport/login?service=https://my.chsi.com.cn/archive/j_spring_cas_security_check'
def login(username,password,lt,_eventId='submit'):   #模拟登入函数
  #构造表单数据
  data = { #需要传去的数据
      '_eventId':_eventId,
      'lt':lt,
      'password':password,
      'submit':u'登录',
      'username':username,
  }
  html = session.post(url,data=data,headers=headers)

def get_lt(url):    #解析登入界面_eventId
  html = session.get(url)
  #获取 lt
  soup = BeautifulSoup(html.text,'lxml',from_encoding="utf-8")
  lt=soup.find('input',type="hidden")['value']
  return lt

lt = get_lt(url)#获取登录form表单信息 以学信网为例
login(username,password,lt)
login_url = 'https://my.chsi.com.cn/archive/gdjy/xj/show.action'
per_html = session.get(login_url)
soup = BeautifulSoup(per_html.text,'lxml',from_encoding="utf-8")
print(soup)
for tag in soup.find_all('table',class_='mb-table'):
  print(tag)
  for tag1 in tag.find_all('td'):
    title= tag1.get_text();
    print(title)
以上就是通过 Python 爬取学信网登录页面的完整示例,希望能为读者提供有价值的参考。欢迎对本站内容给予支持,如有更多疑问可继续交流。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















