


Python实现前向最大匹配中文分词算法详解

本文详细介绍基于词表的中文分词方法,重点讲解前向最大匹配算法的原理与Python实现。通过定义最大词长、递归匹配字典及主循环处理,演示如何对包含英文、数字及特定术语的中文句子进行有效分词,并提供完整代码供参考。
中文分词理论基础
理论介绍
分词是自然语言处理的一项基础任务。与英文不同,中文文本中词语之间不存在空格分隔。因此,对输入的中文文本进行准确的中文分词,是实现文本挖掘的前提,也能帮助计算机自动理解语句含义。中文分词技术归属于自然语言处理领域,人类可以凭借自身知识区分词与非词,而计算机则需要通过特定的分词算法来处理这一过程。
中文分词方法大致可归纳为以下几类:
1. 基于词表的分词方法 2. 基于统计的分词方法 3. 基于序列标记的分词方法
在上述方法中,基于词表的分词方法最为直观。根据匹配起始位置的不同,这类方法主要包含:
1. 前向最大匹配算法 2. 后向最大匹配算法 3. 双向最大匹配算法
这三种方法的核心思想均较为简单,本文将使用Python代码具体实现前向最大匹配算法。
word是一个基于Java实现的分布式中文分词组件,它提供了多种基于词典的分词算法,并利用ngram模型来消除歧义。该组件能够准确识别英文、数字以及日期、时间等数量词,同时可以识别人名、地名、组织机构名等未登录词。用户可以通过自定义配置文件来调整组件行为,支持自定义用户词库、自动检测词库变化,并适应大规模分布式环境。此外,它还支持灵活指定多种分词算法,通过refine功能控制分词结果,并提供词性标注、同义标注、反义标注、拼音标注等功能。该组件还能无缝集成Lucene、Solr、ElasticSearch和Luke等系统。
前向最大匹配算法原理
前向最大匹配算法
前向最大匹配算法,顾名思义,是从待分词句子的左侧向右侧进行搜索,以寻找最大长度的匹配词。实现该算法需要预先设定一个最大词长。在每次扫描时,算法会截取当前起始位置、长度为最大词长的子串,并与字典中的词进行匹配。如果未找到匹配项,则缩短截取长度继续尝试,直到在字典中找到匹配词或剩余部分成为单字为止。
Python代码实现细节
具体代码实现
获取分词函数:getSeg(text):
def getSeg(text):
  # 句子为空
  if not text:
    return ''

  # 句子成为一个词
  if len(text) == 1:
    return text

  # 此处写了一个递归方法
  if text in word_dict:
    return text
  else:
    small = len(text) - 1
    text = text[0:small]
    return getSeg(text)
主函数:main()
def main():
  global test_str, word_dict
  test_str = test_str.strip()
  # 正向最大匹配分词测试 最大长度5
  max_len = max(len(word) for word in word_dict)
  result_str = [] # 保存分词结果
  result_len = 0
  print('input :', test_str)
  while test_str:
    tmp_str = test_str[0:max_len]
    seg_str = getSeg(tmp_str)
    seg_len = len(seg_str)
    result_len = result_len + seg_len

    if seg_str.strip():
      result_str.append(seg_str)
    test_str = test_str[seg_len:]

  print('output :', result_str)
字典:
word_dict = ['混沌', 'Logistic', '算法', '图片', '加密', '利用', '还原', 'Lena', '验证', 'Baboon', '效果']
测试句子:
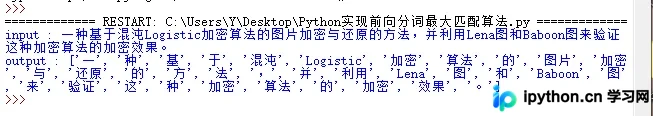
test_str = '''一种基于混沌Logistic加密算法的图片加密与还原的方法,并利用Lena图和Baboon图来验证这种加密算法的加密效果。'''分词结果
到此这篇关于用python实现前向分词最大匹配算法的示例代码的文章就介绍到这了,更多相关python 前向分词最大匹配算法内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















