


RAG向量数据库选型指南:Milvus、Chroma、Weaviate对比

构建检索增强生成(RAG)应用时,向量数据库是核心基础设施。它负责存储嵌入向量并执行相似度搜索,直接决定检索的准确率与响应速度。面对市场上众多的选择,Milvus、Chroma 和 Weaviate 是目前开发者关注度最高的三款开源或云原生方案。它们各有侧重,适用于不同的工程阶段和业务规模。
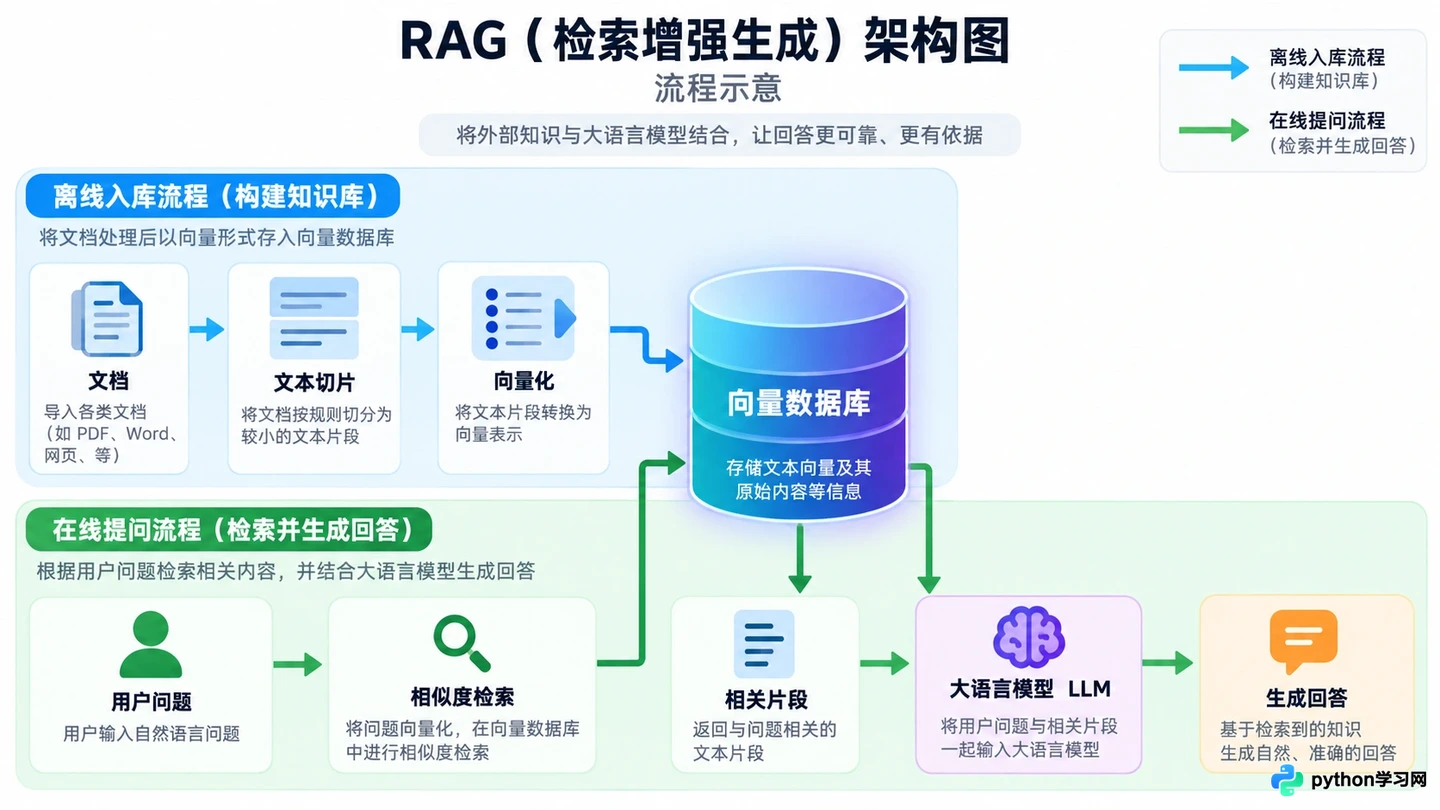
RAG 流程中向量数据库的核心位置
概述
在选择之前,我们需要建立一个基本的认知地图。这三款数据库代表了三种不同的设计哲学:Milvus 追求极致的规模化性能,Chroma 强调开发者体验与快速集成,而 Weaviate 则试图在向量搜索与传统数据管理之间找到平衡。
对于初创团队或原型验证,轻量级和易上手是关键;对于企业级生产环境,高可用、水平扩展和多租户支持则是硬指标。接下来的内容将依次拆解这三个工具的核心界面与逻辑,帮助你根据实际需求对号入座。
关于 Milvus:为大规模生产而生
Milvus 是一款专为海量向量数据设计的开源向量数据库。它的架构基于云原生理念,将计算、存储和索引解耦,这意味着它可以独立扩展各个组件以应对高并发查询。
在使用 Milvus 时,你通常会接触到其复杂的集群架构。它支持多种索引类型,如 IVF_FLAT、HNSW 和 DiskANN,允许用户根据内存和磁盘资源的限制进行精细调优。Milvus 的最大优势在于其处理十亿级向量数据的能力,以及在分布式环境下的高可用性。
然而,这种强大也带来了复杂性。部署 Milvus 通常需要借助 Docker Compose 或 Kubernetes,维护成本相对较高。它更适合那些已经拥有专门运维团队,且数据量增长迅速、对查询延迟有严格要求的大型企业项目。
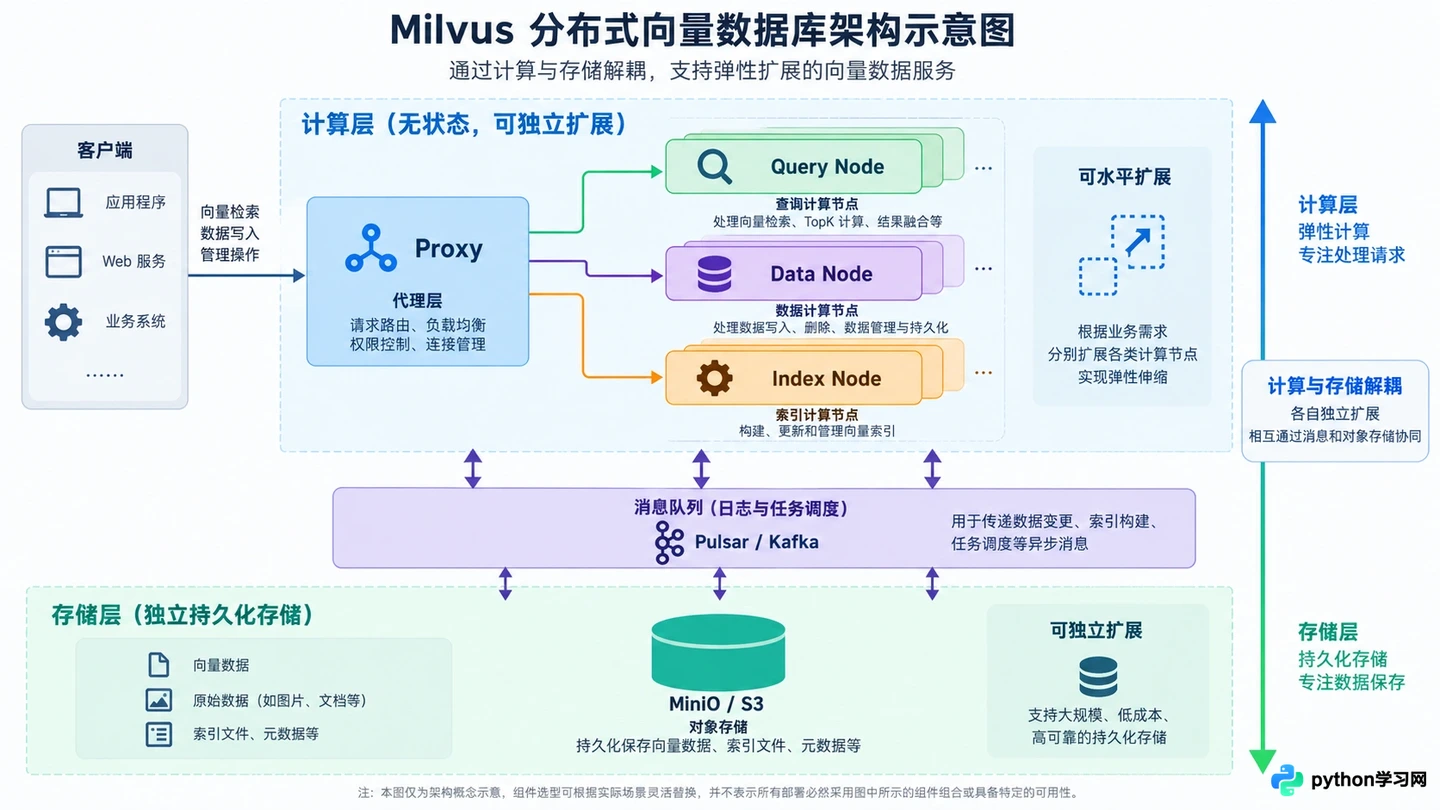
Milvus 的存算分离分布式架构
关于 Chroma:开发者友好的嵌入式选择
Chroma 的设计目标非常明确:让 AI 开发者能够最快地将向量搜索功能集成到应用中。它既可以作为嵌入式库运行在本地进程中,也可以作为独立服务部署。
Chroma 的接口极其简洁,通常只需几行代码即可完成集合创建、向量插入和相似度搜索。它默认使用 HNSW 索引,并在底层集成了持久化存储,无需额外配置复杂的依赖项。对于 Python 开发者而言,Chroma 的 API 设计符合直觉,极大地降低了学习曲线。
此外,Chroma 对元数据过滤的支持也非常直观,允许用户在搜索时结合标量字段进行筛选。虽然它在超大规模数据集上的性能不如 Milvus 那样经过极端优化,但对于大多数中小规模的 RAG 应用、个人项目或内部工具来说,Chroma 提供了最佳的投入产出比。
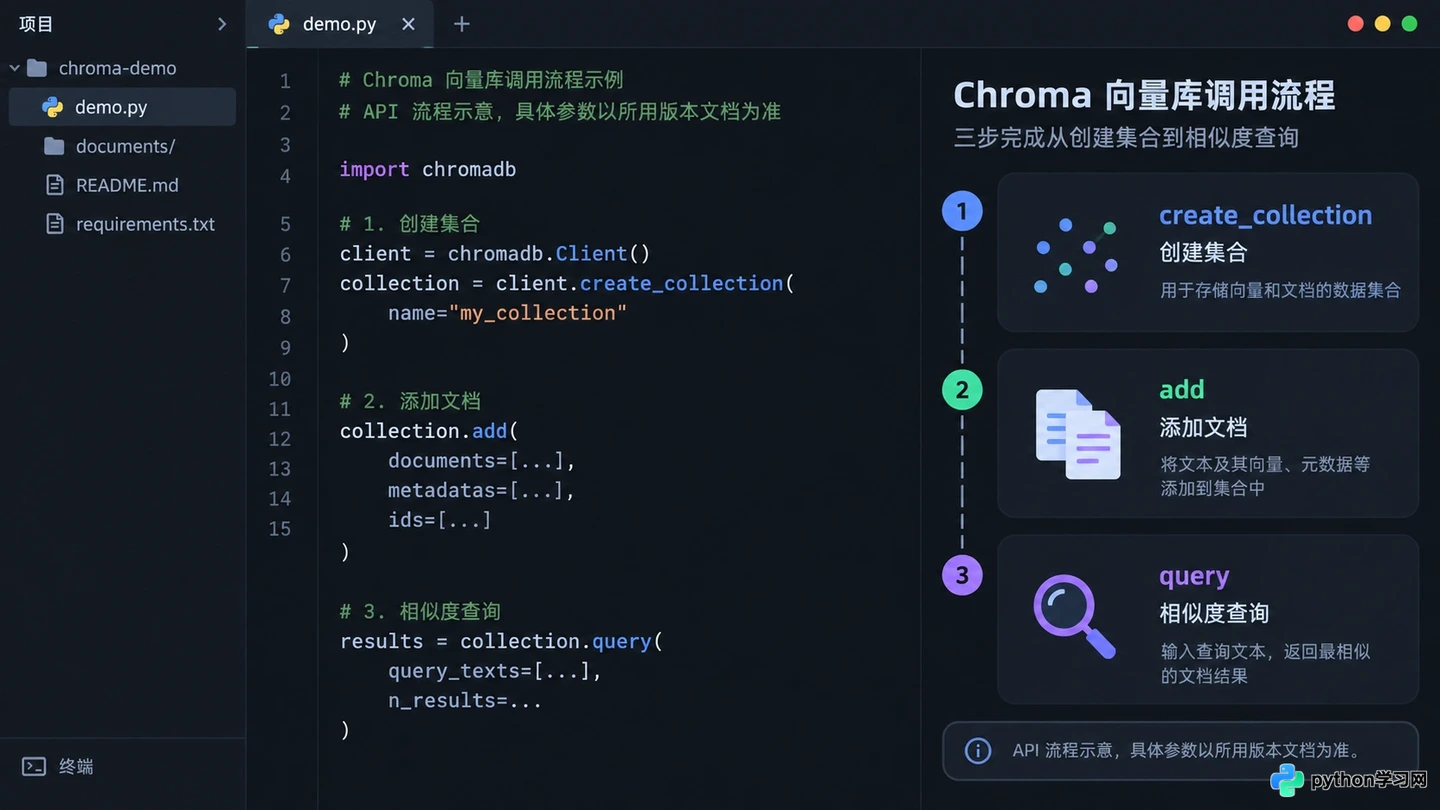
Chroma 简洁的 Python API 调用示例
关于 Weaviate:模块化与混合搜索
Weaviate 将自己定位为“向量原生”搜索引擎,而不仅仅是数据库。它的独特之处在于内置了模块化架构,支持直接在数据库层面调用机器学习模型进行向量化,减少了应用层与数据库之间的网络往返。
Weaviate 的一个显著特点是其对混合搜索的原生支持。它可以同时结合关键词搜索(BM25)和向量相似度搜索,并通过加权算法融合结果。这对于解决纯向量搜索在某些专有名词或精确匹配场景下的不足非常有效。
在数据建模方面,Weaviate 使用了类似 GraphQL 的模式定义,结构清晰且类型安全。它还提供了丰富的客户端库,支持多种编程语言。如果你需要在检索过程中结合传统的文本匹配能力,或者希望简化向量化的流水线,Weaviate 是一个值得考虑的强大选项。
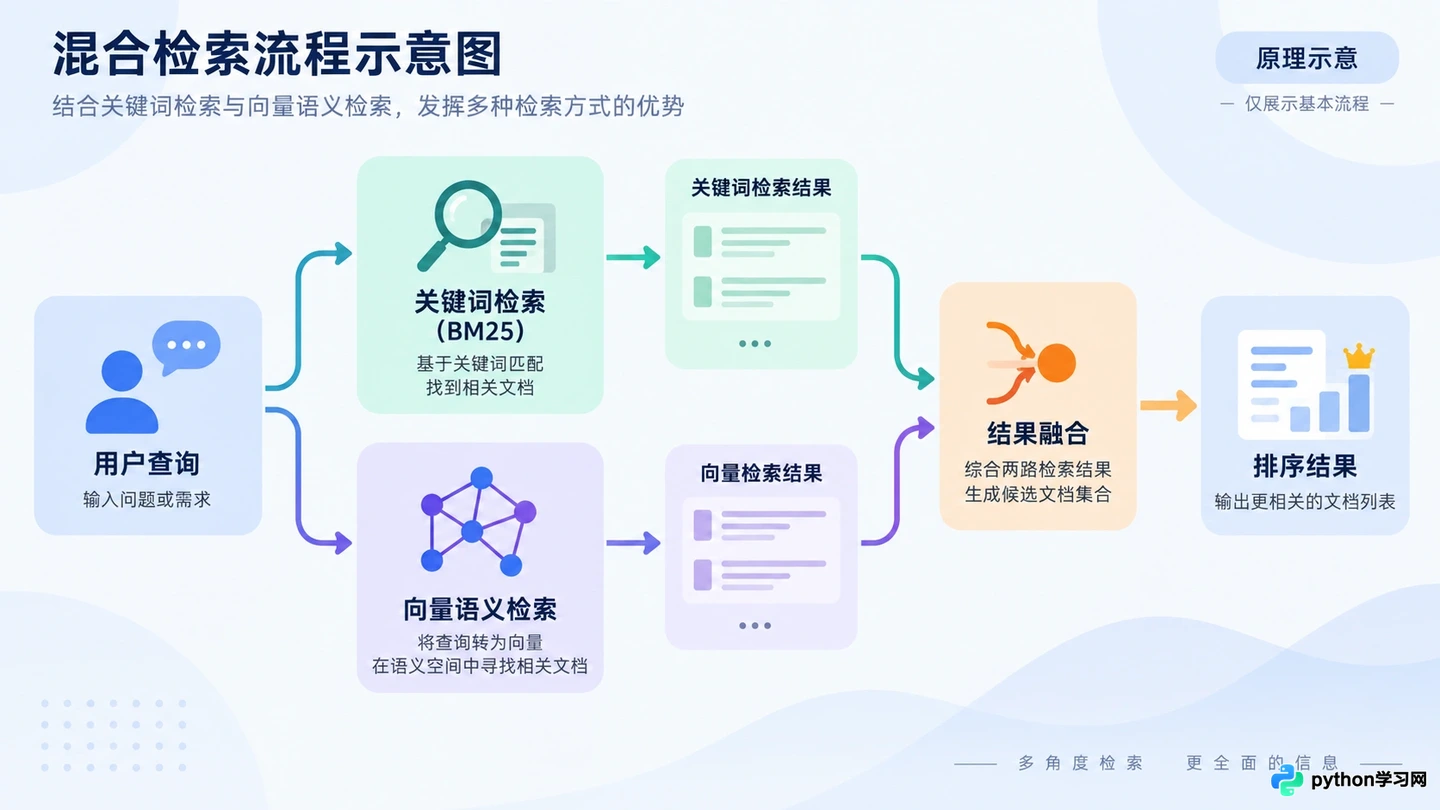
Weaviate 的混合搜索机制示意
核心维度对比
为了更直观地理解三者的差异,我们可以从以下几个关键维度进行横向比较:
| 特性 | Milvus | Chroma | Weaviate |
|---|---|---|---|
| 主要定位 | 企业级大规模向量库 | 开发者友好/嵌入式 | 模块化向量搜索引擎 |
| 部署复杂度 | 高 (需 K8s/Docker) | 低 (可嵌入式/单容器) | 中 (Docker/K8s) |
| 扩展性 | 极强 (存算分离) | 一般 (适合中小规模) | 强 (支持分片) |
| 混合搜索 | 支持 (需配置) | 基础元数据过滤 | 原生支持 (BM25+Vector) |
| 生态系统 | 丰富 (LangChain/LlamaIndex) | 快速增长 (Python生态) | 完善 (多语言客户端) |
| 适用场景 | 十亿级数据、高并发 | 原型开发、中小应用 | 需要混合检索、模块化 |
选型建议
如果你的项目处于早期阶段,或者数据量在百万级以下,Chroma 是最快启动的选择。它的简单性让你能专注于业务逻辑而非基础设施维护。
当你的应用需要处理复杂的查询意图,既包含语义理解又需要精确关键词匹配时,Weaviate 的混合搜索能力能提供更高的检索相关性。其模块化设计也便于后续集成自定义的 ML 模型。
一旦你的数据量突破千万甚至亿级,且对系统的稳定性和水平扩展能力有极高要求,Milvus 是经过验证的工业级解决方案。尽管初期投入较大,但它能为未来的规模化增长提供坚实保障。
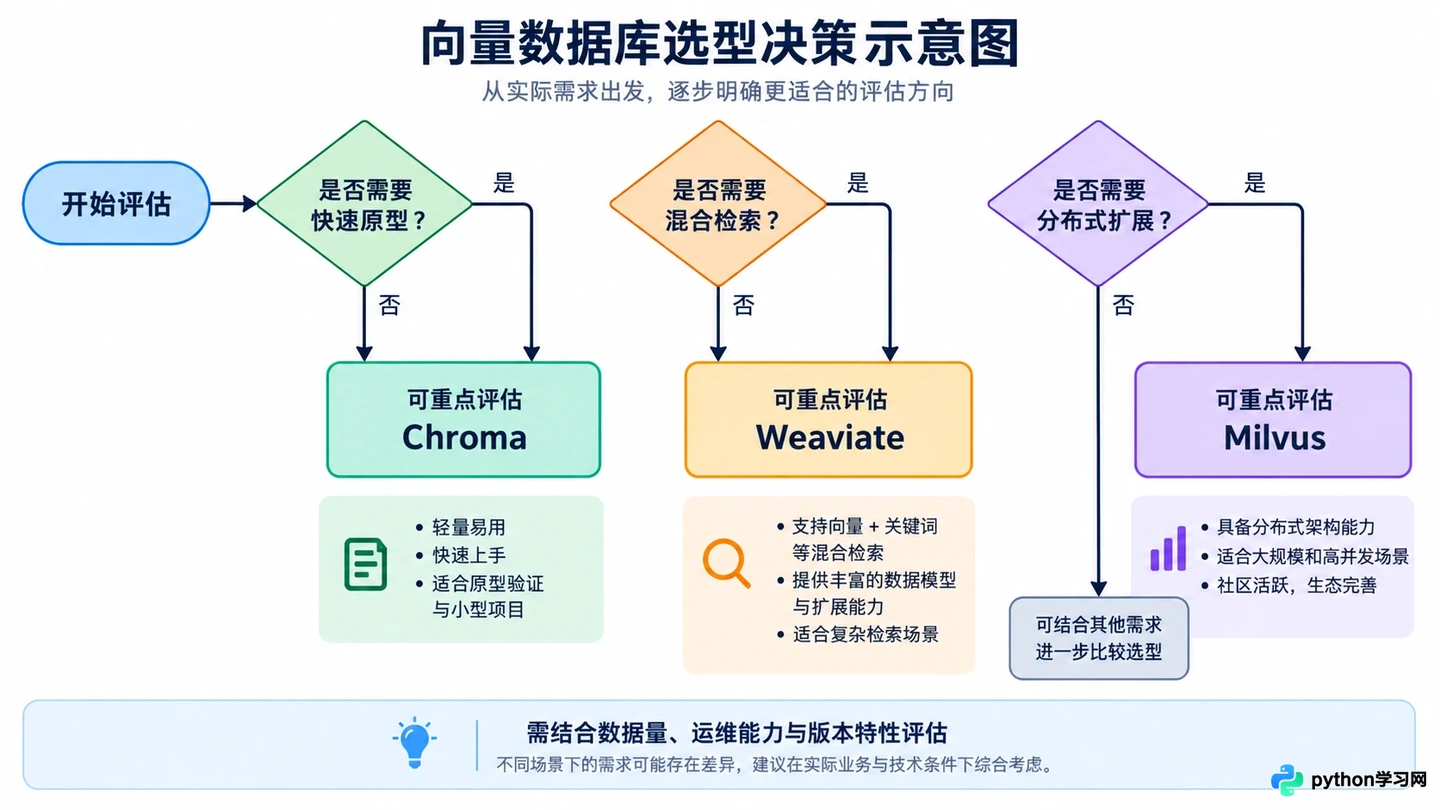
根据项目规模与需求的选型决策路径
最终的选择不应仅基于技术参数,更应结合团队的技术栈熟悉度、运维能力以及业务的长期演进路线。在 RAG 知识库的构建中,合适的向量数据库能让检索环节从瓶颈变为优势。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















